# 工学じじいの縁側日記
> C++、DirectX、ゲームプログラミング、自作ゲームエンジン、コンピュータサイエンス周りの技術など、じじいとして得た知識を分かりやすく解説する技術記事をお届けしたいです
Public Ghost content for AI and LLM tooling. This file includes a bounded export of public pages first, then recent public posts.
Append `.md` to any post or page URL to get the content in Markdown (for example, `/example-post.md`).
## Pages
### 工学じじいの縁側日記について
URL: https://www.geekjp.com/about/
Last updated: 2026-07-25T04:21:39.000Z
**工学じじいの縁側日記**は、ゲーム開発、C++、コンピュータサイエンスなどの技術的な話題から、日常の中で気になったことまで、工学じじいが気ままに書き残していくサイトです。
筆者は工学系の大学・大学院を経て、エンターテインメント分野やVR・AR技術などの研究開発に携わってきました。
そこで学んだソフトウェア技術をはじめ、自作ゲームエンジンの開発記録、実際に遭遇した不具合、その原因を調べて解決するまでの過程などをまとめています。
じじいが確認できた確実な知識や成功例だけではなく、試行錯誤の途中や、うまくいかなかった方法についても、できるだけ具体的に残していきます。
## このサイトで扱う内容
### ゲーム開発とC++
DirectX、DxLib、自作ゲームエンジンなどを使ったゲーム開発について紹介します。ときどきPythonや、そのほかの技術も扱います。
クラス設計、シーン管理、当たり判定、アニメーション、ゲームAI、経路探索など、実際のゲーム制作で必要になる技術が中心です。
このサイトでは、できる限りC++を使って話を進めていきます。
「なぜ今でもC++なのか」という話も含め、ゲーム開発におけるC++の役割や、ほかの言語との違いについても考えていきます。
### ソフトウェア工学
プログラムをただ動かすだけではなく、あとから読みやすく、修正しやすく、機能を追加しやすい形にするための考え方を扱います。
クラス設計、責務の分離、継承、ポリモーフィズム、デザインパターン、アセット管理、シーン構造など、ゲーム開発の中で実際に必要になった設計上の問題を取り上げます。
「正しい設計」を一方的に示すのではなく、規模や目的、学習者の理解度によって、どのような構造が扱いやすいのかを考えます。
作れる→解かる、を意識しています。
### コンピュータサイエンス
データ構造、アルゴリズム、ベクトル、行列、探索、ソートなどを、ゲーム開発とのつながりが分かる形で解説します。
数式や専門用語を並べるだけではなく、それらがプログラムの中でどのように使われるのかを重視しています。ゲームを題材にしながら、実際に動かして理解できる、実践的な内容を目指します。
### Linux・サーバー構築
Linux、Apache、Docker、Ghost、BookStackなどを使ったサーバー運用の記録です。設定方法だけでなく、失敗した原因、調査の手順、復旧方法についても残します。
人に教えるための記事というより、将来の自分が同じ問題に遭遇したときに困らないための、備忘録としての意味合いが強い分野です。
### コーヒー部とじじいの日常
技術以外にも、コーヒー、器具、写真、散歩、道具、日々考えたことなどを書いています。
難しい技術記事の合間に、縁側でひと休みするような気持ちで読んでもらえれば幸いです。
## 記事について
このサイトの記事は、研究開発、講義経験、個人開発、サーバー運用などで得た知識をもとに作成しています。
内容についてはできる限り確認していますが、ソフトウェアのバージョンや実行環境の違いにより、同じ手順で動作しない場合があります。
掲載しているプログラムや設定を利用する場合は、重要なデータのバックアップを取ったうえで、ご自身の責任でお試しください。
また、このサイトには、以前はてなブログで公開していた記事を修正・整理しながら移行したものも含まれています。
## 運営者
**工学じじい**
死ぬまでマッドサイエンティストを目標に、プログラミング、C++、ゲームエンジン、コンピュータグラフィックス、ゲームAIなどを中心に、実際に動かして理解できる教材やサンプルを作っています。
お問い合わせは、サイト内のお問い合わせページからお願いします。
### プライバシーポリシー
URL: https://www.geekjp.com/privacy-policy/
Last updated: 2026-07-25T05:31:28.000Z
「工学じじいの縁側日記」(以下、「当サイト」といいます)では、当サイトを利用する方の個人情報およびプライバシーを尊重し、取得した情報を以下の方針に基づいて適切に取り扱います。
## 個人情報の取得について
当サイトでは、お問い合わせフォームなどを通じて、次の情報を取得する場合があります。
- 名前またはハンドルネーム
- メールアドレス
- お問い合わせ内容
- その他、利用者が入力した情報
これらの情報は、お問い合わせへの回答や必要な連絡のために利用し、それ以外の目的では利用しません。
## 個人情報の利用目的
当サイトで取得した個人情報は、次の目的で利用します。
- お問い合わせへの回答
- 必要な情報の連絡
- 当サイトの運営および改善
- 迷惑行為や不正利用への対応
- 法令または利用規約に違反する行為への対応
取得した個人情報を、上記の目的を超えて利用する場合は、あらかじめ本人の同意を得るものとします。
## 個人情報の第三者提供について
当サイトでは、次の場合を除き、取得した個人情報を本人の同意なく第三者へ提供しません。
- 法令に基づく場合
- 人の生命、身体または財産の保護に必要であり、本人の同意を得ることが困難な場合
- 不正アクセスや迷惑行為などから当サイトや利用者を保護するために必要な場合
- 利用目的の達成に必要な範囲で、業務を外部へ委託する場合
外部へ業務を委託する場合は、個人情報が適切に管理されるよう必要な措置を講じます。
## Cookieについて
当サイトでは、利用状況の把握、利便性の向上、広告配信などを目的として、Cookie(クッキー)およびこれに類する技術を使用する場合があります。
Cookieとは、ウェブサイトを閲覧した際に、ブラウザへ保存される小さなデータです。Cookieにより利用者個人を直接特定できるものではありません。
利用者は、ブラウザの設定によりCookieを無効にできます。ただし、Cookieを無効にした場合、当サイトの一部機能が正しく動作しない可能性があります。
## 広告配信について
当サイトでは、第三者配信の広告サービスである「Google AdSense」を利用する予定です。
Googleを含む第三者配信事業者は、Cookieを使用して、利用者が当サイトや他のウェブサイトへ過去にアクセスした際の情報に基づく広告を配信する場合があります。
Googleが広告Cookieを使用することにより、Googleおよびそのパートナーは、当サイトや他のウェブサイトへのアクセス情報に基づいて、利用者に適した広告を表示できる場合があります。
利用者は、[Googleの広告設定](https://adssettings.google.com/?ref=geekjp.com)から、パーソナライズ広告を無効にできます。
また、[YourAdChoices](https://optout.aboutads.info/?ref=geekjp.com)へアクセスすることで、第三者配信事業者によるパーソナライズ広告へのCookie利用を無効にできる場合があります。
Googleによる情報の取り扱いについては、次のページをご確認ください。
- [Googleがサービスを使用するサイトやアプリから収集した情報の利用方法](https://policies.google.com/technologies/partner-sites?hl=ja&ref=geekjp.com)
- [Googleによる広告でのCookieの利用方法](https://policies.google.com/technologies/ads?hl=ja&ref=geekjp.com)
- [Googleプライバシーポリシー](https://policies.google.com/privacy?hl=ja&ref=geekjp.com)
## 欧州経済領域などの利用者に対する同意管理
当サイトでは、欧州経済領域(EEA)、イギリスおよびスイスからアクセスする利用者に対し、法令やGoogleの方針により必要となる場合、Cookieの使用や広告目的での個人データの処理について同意を求めるメッセージを表示します。
利用者は、表示される同意管理画面から、同意内容を選択または変更できる場合があります。
## アクセス解析について
当サイトでは、サイトの利用状況を把握し、内容や利便性を改善するために、アクセス解析サービスを利用しています。
アクセス解析サービスは、Cookieなどを利用して、閲覧したページ、利用環境、アクセス日時、参照元などの情報を収集する場合があります。これらの情報は統計的に処理され、通常は特定の個人を直接識別するものではありません。
Google Analyticsを利用する場合、収集された情報はGoogleのプライバシーポリシーに基づいて管理されます。
- [Google Analytics利用規約](https://marketingplatform.google.com/about/analytics/terms/jp/?ref=geekjp.com)
- [Googleプライバシーポリシー](https://policies.google.com/privacy?hl=ja&ref=geekjp.com)
利用者は、[Google Analyticsオプトアウトアドオン](https://tools.google.com/dlpage/gaoptout?hl=ja&ref=geekjp.com)を利用することで、Google Analyticsによる情報収集を無効にできます。
## お問い合わせについて
当サイトへのお問い合わせ時に取得した情報は、お問い合わせへの回答および必要な連絡のために利用します。
お問い合わせ内容によっては、回答できない場合や、回答までに時間を要する場合があります。
[お問い合わせはこちら](https://www.geekjp.com/contact/)
## コメントについて
当サイトでコメントを受け付ける場合、コメント投稿時に入力された名前、メールアドレス、コメント内容、IPアドレス、ブラウザ情報などを取得する場合があります。
これらの情報は、迷惑行為やスパムへの対応、コメントの管理などに利用します。
次の内容を含むコメントは、管理者の判断により、事前の通知なく削除する場合があります。
- 特定の個人や団体を誹謗中傷する内容
- 違法行為または違法行為を助長する内容
- 広告、宣伝、勧誘を主な目的とする内容
- 個人情報を含む内容
- 他者の権利を侵害する内容
- その他、当サイトの管理者が不適切と判断した内容
## 外部サイトへのリンクについて
当サイトには、外部サイトへのリンクが含まれる場合があります。
リンク先のサイトで提供される情報、サービス、個人情報の取り扱いなどについて、当サイトは責任を負いません。リンク先のプライバシーポリシーや利用規約をご確認ください。
## 個人情報の開示・訂正・削除について
本人から、当サイトが保有する個人情報の開示、訂正、追加、削除、利用停止などを求められた場合は、本人確認を行ったうえで、法令に従って適切に対応します。
ご希望の場合は、お問い合わせページからご連絡ください。
## セキュリティについて
当サイトでは、取得した情報の漏えい、紛失、改ざん、不正アクセスなどを防止するため、合理的な安全対策に努めます。
ただし、インターネット上の通信や情報保存について、完全な安全性を保証するものではありません。
## プライバシーポリシーの変更について
当サイトは、法令、利用サービス、運営方針などの変更に応じて、本プライバシーポリシーの内容を変更する場合があります。
変更後のプライバシーポリシーは、当ページへ掲載した時点から効力を生じるものとします。重要な変更がある場合は、当サイト上で分かりやすい方法によりお知らせします。
## 運営者情報
- サイト名:工学じじいの縁側日記
- 運営者:工学じじい
- サイトURL:https://www.geekjp.com/
- お問い合わせ:[お問い合わせページ](https://www.geekjp.com/contact/)
## 制定日・改定日
- 制定日:2026年7月24日
- 最終改定日:2026年7月24日
### お問い合わせ
URL: https://www.geekjp.com/contact/
Last updated: 2026-07-24T17:35:38.000Z
「工学じじいの縁側日記」へのお問い合わせは、以下の内容をご確認のうえご連絡ください。
## お問い合わせいただける内容
次のような内容を受け付けています。
- 記事内容についてのご質問
- 記事内の誤記や不具合のご指摘
- 掲載コードに関するご連絡
- 著作権や引用に関するご連絡
- リンク切れや表示崩れのご報告
- サイト運営に関するご意見
- その他、当サイトに関するお問い合わせ
## お問い合わせ方法
読み込んでいます…
## ご連絡の際に記載してほしい内容
記事についてのお問い合わせの場合は、次の情報を記載していただけると確認しやすくなります。
- お名前またはハンドルネーム
- 返信先メールアドレス
- 対象の記事タイトル
- 対象ページのURL
- ご質問またはご指摘の内容
- エラーが発生した場合は、エラーメッセージ
- 実行環境やソフトウェアのバージョン
- 必要に応じて、問題が分かる画像やコード
個人情報、パスワード、APIキー、秘密鍵などの機密情報は送信しないでください。
## 返信について
お問い合わせ内容を確認後、必要に応じて返信します。
ただし、次のような場合は返信できないことがあります。
- 内容が不明確な場合
- 営業、宣伝、勧誘を目的とした連絡
- 同一内容が繰り返し送信された場合
- 誹謗中傷や迷惑行為に該当する場合
- 個別の課題や制作物について、完成品の作成のみを求める内容
- 当サイトと関係のない内容
- その他、返信が適切でないと判断した場合
すべてのお問い合わせへの返信を保証するものではありません。
## 技術的なご質問について
記事の内容に関する技術的なご質問には、可能な範囲で対応します。
ただし、環境の違いや情報不足により、原因を特定できない場合があります。質問の際は、使用しているOS、開発環境、ライブラリのバージョン、エラーメッセージなどをできるだけ詳しく記載してください。
また、学校の課題、採用試験、資格試験などについて、解答のみを求めるお問い合わせには対応できない場合があります。
## 掲載内容の誤りについて
記事内の誤記、技術的な誤り、リンク切れなどを見つけた場合は、対象ページのURLと該当箇所を添えてご連絡ください。
内容を確認し、必要に応じて修正します。
## 著作権・権利関係について
当サイトの掲載内容について、著作権、商標権、肖像権、その他の権利に関する問題がある場合は、対象ページのURLと具体的な内容を記載してご連絡ください。
正当な権利者またはその代理人からの申し出であることを確認したうえで、必要に応じて修正、削除などの対応を行います。
## 個人情報の取り扱い
お問い合わせの際に取得した名前、メールアドレス、お問い合わせ内容などは、回答および必要な連絡のために利用します。
詳しくは、[プライバシーポリシー](https://www.geekjp.com/privacy-policy/)をご確認ください。
## 運営者情報
- サイト名:工学じじいの縁側日記
- 運営者:工学じじい
- サイトURL:
### 免責事項
URL: https://www.geekjp.com/disclaimer/
Last updated: 2026-07-25T05:18:44.000Z
「工学じじいの縁側日記」(以下、「当サイト」といいます)をご利用になる前に、以下の内容をご確認ください。
## 掲載情報について
当サイトでは、ゲーム開発、C++、DirectX、コンピュータサイエンス、サーバー構築、各種ソフトウェアの使い方などに関する情報を掲載しています。
掲載内容については、できる限り正確で分かりやすい情報を提供するよう努めていますが、その正確性、完全性、安全性、最新性、特定の目的への適合性を保証するものではありません。
ソフトウェア、ライブラリ、OS、開発環境、サービスなどの仕様は、バージョンアップや提供元の都合によって変更される場合があります。そのため、記事の公開時点では正しかった内容であっても、現在の環境では動作しない場合があります。
## コード・設定例の利用について
当サイトに掲載しているプログラムコード、コマンド、設定例、手順、サンプルデータなどを利用する場合は、ご自身の責任で十分に内容を確認したうえで実行してください。
実行前には、必要に応じて次の対策を行ってください。
- 重要なデータのバックアップ
- 設定ファイルのコピー
- 仮想環境や検証環境での動作確認
- 使用しているソフトウェアやライブラリのバージョン確認
- パスワード、APIキー、秘密鍵などの機密情報の除去
当サイトの掲載内容を利用したこと、または利用できなかったことによって生じた損害、データの消失、機器やソフトウェアの不具合、サービス停止、セキュリティ上の問題、その他の不利益について、当サイトおよび運営者は責任を負いません。
## 学習・試験・課題に関する情報について
当サイトでは、プログラミング学習、資格試験、授業資料、練習問題などを扱う場合があります。
掲載内容は学習の補助を目的としたものであり、試験の合格、成績の向上、課題の完成、就職や採用などの結果を保証するものではありません。
また、学校、試験実施団体、企業、その他の組織が示す正式な解答、規約、指示、評価基準がある場合は、必ずそちらを優先してください。
## 外部リンクについて
当サイトには、他のウェブサイトやサービスへのリンクが含まれる場合があります。
リンク先のサイトで提供される情報、商品、サービス、プログラム、個人情報の取り扱い、セキュリティなどについて、当サイトおよび運営者は管理しておらず、その内容を保証するものではありません。
外部サイトを利用する場合は、リンク先の利用規約、プライバシーポリシー、注意事項などをご確認ください。
## 広告・アフィリエイトについて
当サイトでは、第三者配信の広告サービスやアフィリエイトプログラムを利用する場合があります。
当サイトで紹介する商品やサービスについては、可能な限り正確な情報を掲載するよう努めますが、価格、在庫、仕様、提供条件、キャンペーン内容などは変更される場合があります。
商品の購入やサービスの利用を検討する際は、必ず販売元や提供元の公式サイトで最新情報をご確認ください。
当サイトのリンクを経由して商品やサービスを購入、契約、利用したことによって生じた損害やトラブルについて、当サイトおよび運営者は責任を負いません。
## 著作権について
当サイトに掲載している文章、画像、図表、プログラムコード、その他のコンテンツの著作権は、当サイトの運営者または正当な権利者に帰属します。
私的利用や、著作権法で認められた範囲を超えて、無断で転載、複製、改変、再配布、販売することを禁止します。
引用する場合は、引用部分と本文を明確に区別し、出典として当サイト名および対象ページへのリンクを明記してください。
なお、掲載コードについて個別にライセンス表記がある場合は、そのライセンス条件を優先します。
## 商標について
当サイトに記載されている会社名、製品名、サービス名、ロゴなどは、各社または各権利者の商標または登録商標である場合があります。
当サイトは、各商標権者と提携、協賛、承認関係にあることを示すものではありません。
## 権利侵害への対応について
当サイトの掲載内容が著作権、商標権、肖像権、プライバシー権、その他の権利を侵害していると思われる場合は、対象ページのURLと該当箇所を添えて、[お問い合わせページ](https://www.geekjp.com/contact/)からご連絡ください。
内容を確認し、必要に応じて修正、削除などの対応を行います。
## コメント・投稿内容について
当サイトでコメントや投稿を受け付ける場合、投稿された内容は投稿者自身の責任によるものとします。
次のような内容は、運営者の判断により、事前の通知なく削除する場合があります。
- 特定の個人や団体を誹謗中傷する内容
- 違法行為または違法行為を助長する内容
- 個人情報や機密情報を含む内容
- 広告、宣伝、勧誘を主な目的とする内容
- 他者の権利を侵害する内容
- 当サイトの運営を妨げる内容
- その他、運営者が不適切と判断した内容
## サイトの停止・内容変更について
当サイトは、予告なく掲載内容の変更、修正、削除、公開停止を行う場合があります。
また、サーバー障害、メンテナンス、通信障害、災害、外部サービスの停止、その他の事情により、当サイトを一時的または継続的に利用できなくなる場合があります。
これらによって生じた損害について、当サイトおよび運営者は責任を負いません。
## 免責事項の変更について
当サイトは、法令、利用サービス、運営方針などの変更に応じて、本免責事項を変更する場合があります。
変更後の免責事項は、当ページへ掲載した時点から効力を生じるものとします。
## 運営者情報
- サイト名:工学じじいの縁側日記
- 運営者:工学じじい
- サイトURL:
- お問い合わせ:[お問い合わせページ](https://www.geekjp.com/contact/)
## 制定日・改定日
- 制定日:2026年7月25日
- 最終改定日:2026年7月25日
## Posts
### DirectXTKでゲーム制作 第1回:DirectXTKとは何か
URL: https://www.geekjp.com/directxtk-lesson01/
Last updated: 2026-10-05T14:03:04.000Z
Direct3D 11でゲームを作ろうとすると、画面に1枚の画像を出すだけでも、頂点やシェーダー、描画状態、テクスチャなど多くの準備が必要になります。DirectXTK(DirectX Tool Kit)は、そうした定番処理を使いやすいC++クラスとしてまとめたライブラリです。
ただし、DirectXTKはゲームエンジンではありません。ここを最初に区別しておくと、「何を任せられて、何を自分で作るのか」が見通しやすくなります。
## DirectXTKとは
DirectXTKは、MicrosoftがGitHubで公開している、Direct3D向けのヘルパークラス集です。Direct3Dそのものを置き換えるのではなく、その上に薄い便利な層を加えます。
たとえば、2D画像をまとめて描画する`SpriteBatch`、ビットマップフォントを描画する`SpriteFont`、基本的な3D形状を生成して描く`GeometricPrimitive`などが用意されています。毎回ゼロから書くと長くなりやすい処理を、再利用しやすい形で使えるのが特徴です。
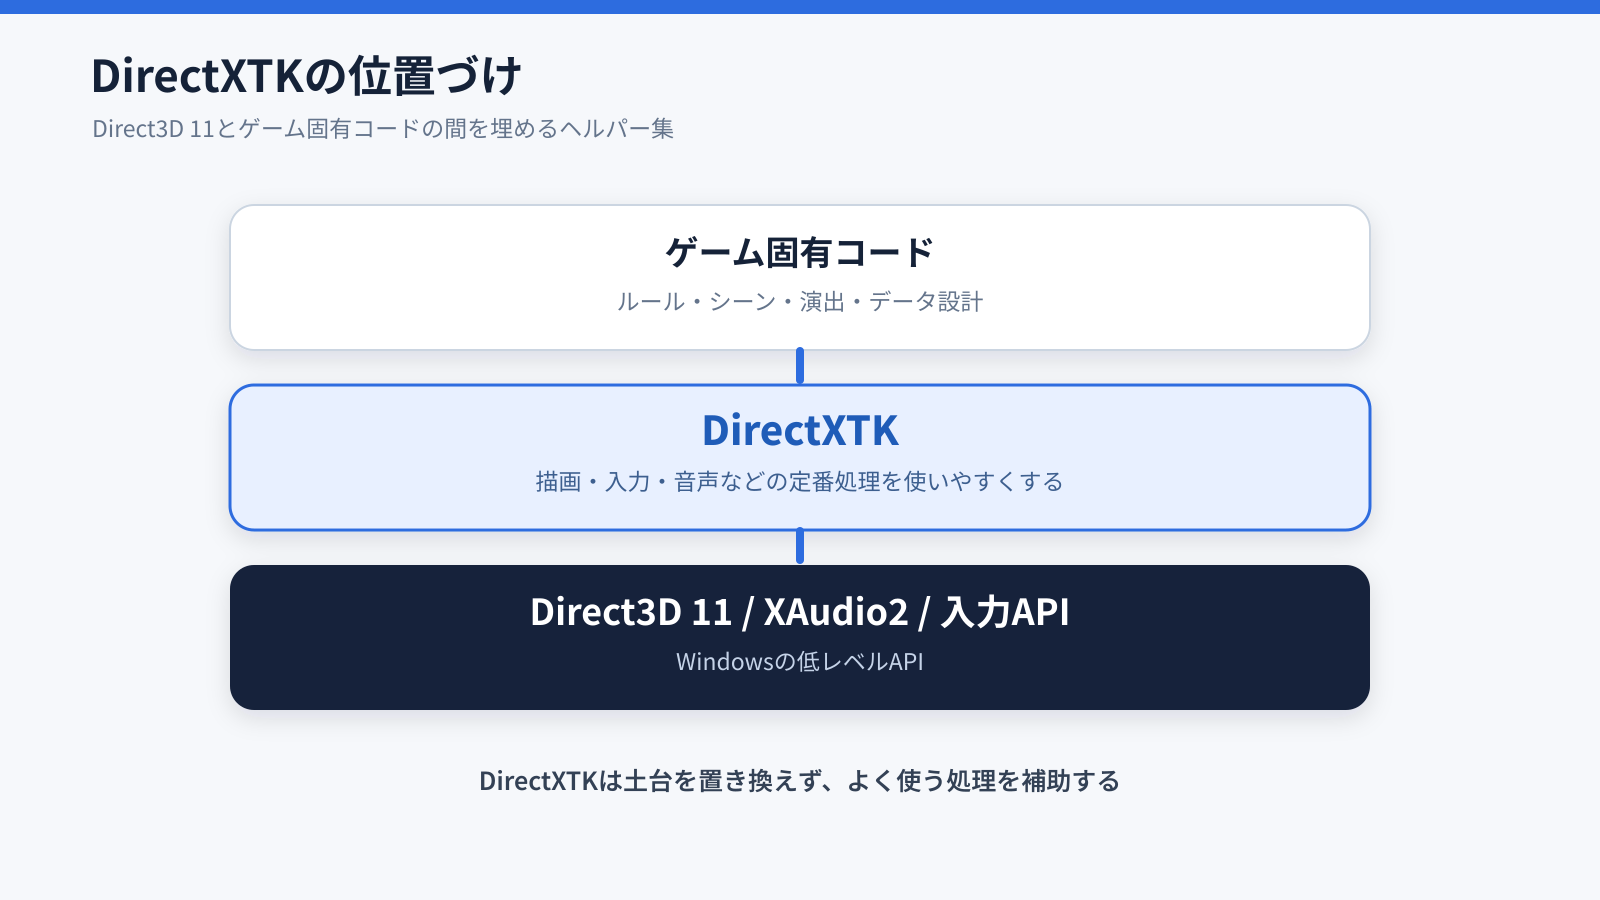
DirectXTKは低レベルAPIとゲーム固有コードの間に置く補助ライブラリ
重要なのは、DirectXTKを使ってもDirect3D 11を扱っている事実は変わらないことです。デバイスやデバイスコンテキスト、レンダーターゲット、フレーム単位の更新と描画といった基本構造は、アプリケーション側が管理します。
## DirectXTKで何ができるか
DirectXTKの機能は、目的別の部品として捉えると分かりやすくなります。
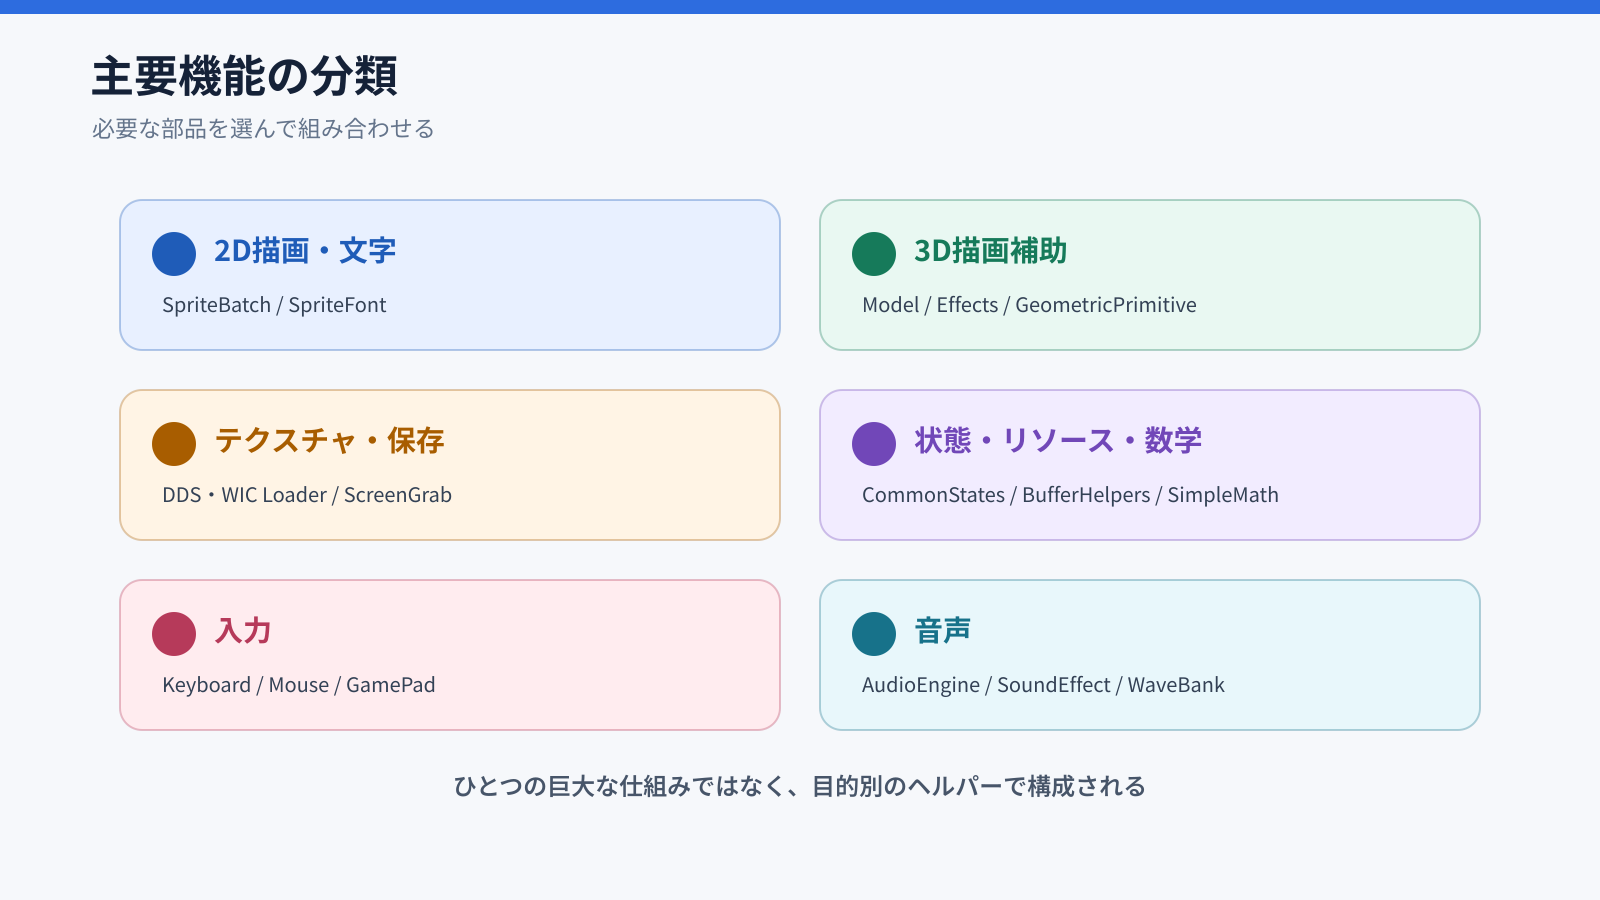
DirectXTKの主要機能は、必要なものだけ選んで利用できる
### 2D描画と文字
`SpriteBatch`は、テクスチャを2Dスプライトとして効率よく描画するためのクラスです。位置、回転、拡大縮小、色、描画順などを指定できます。`SpriteFont`と組み合わせれば、画面上に文字を描画できます。HUD、メニュー、デバッグ表示などに向いています。
### 3D描画の補助
`GeometricPrimitive`は立方体や球などの基本形状を生成して描画します。`Model`は対応形式のメッシュを読み込み、`Effects`は一般的な描画に使える組み込みシェーダーを提供します。`PrimitiveBatch`や`VertexTypes`は、独自の頂点を使った描画を組み立てるときに役立ちます。
### テクスチャの読み込みと画面保存
`DDSTextureLoader`はDDS、`WICTextureLoader`はPNGやJPEGなどをDirect3Dのテクスチャとして読み込むための軽量ローダーです。`ScreenGrab`を使えば、描画結果を画像として保存できます。
### 描画状態、リソース、数学
`CommonStates`は、ブレンド、深度ステンシル、ラスタライザー、サンプラーといった定番の描画状態をまとめて提供します。`BufferHelpers`や`GraphicsMemory`はリソース作成や動的メモリ管理を補助し、`SimpleMath`はDirectXMathを扱いやすいC++型で包みます。
### 入力
`Keyboard`、`Mouse`、`GamePad`は、各入力デバイスの現在状態や前フレームからの変化を扱いやすくします。入力APIの細部を毎回直接処理する負担を減らせます。
### 音声
`AudioEngine`、`SoundEffect`、`WaveBank`などを使い、XAudio2を基盤とした効果音や音声の再生を組み立てられます。
## DirectXTKはゲームエンジンではない
UnityやUnreal Engineのようなゲームエンジンは、描画だけでなく、シーン管理、オブジェクト管理、物理、アニメーション、エディタ、アセットの取り込みなど、制作全体を支える大きな枠組みを提供します。
DirectXTKが提供するのは、そのうちの一部で使える便利な部品です。ゲームの実行方式やデータ構造まで決めるものではありません。
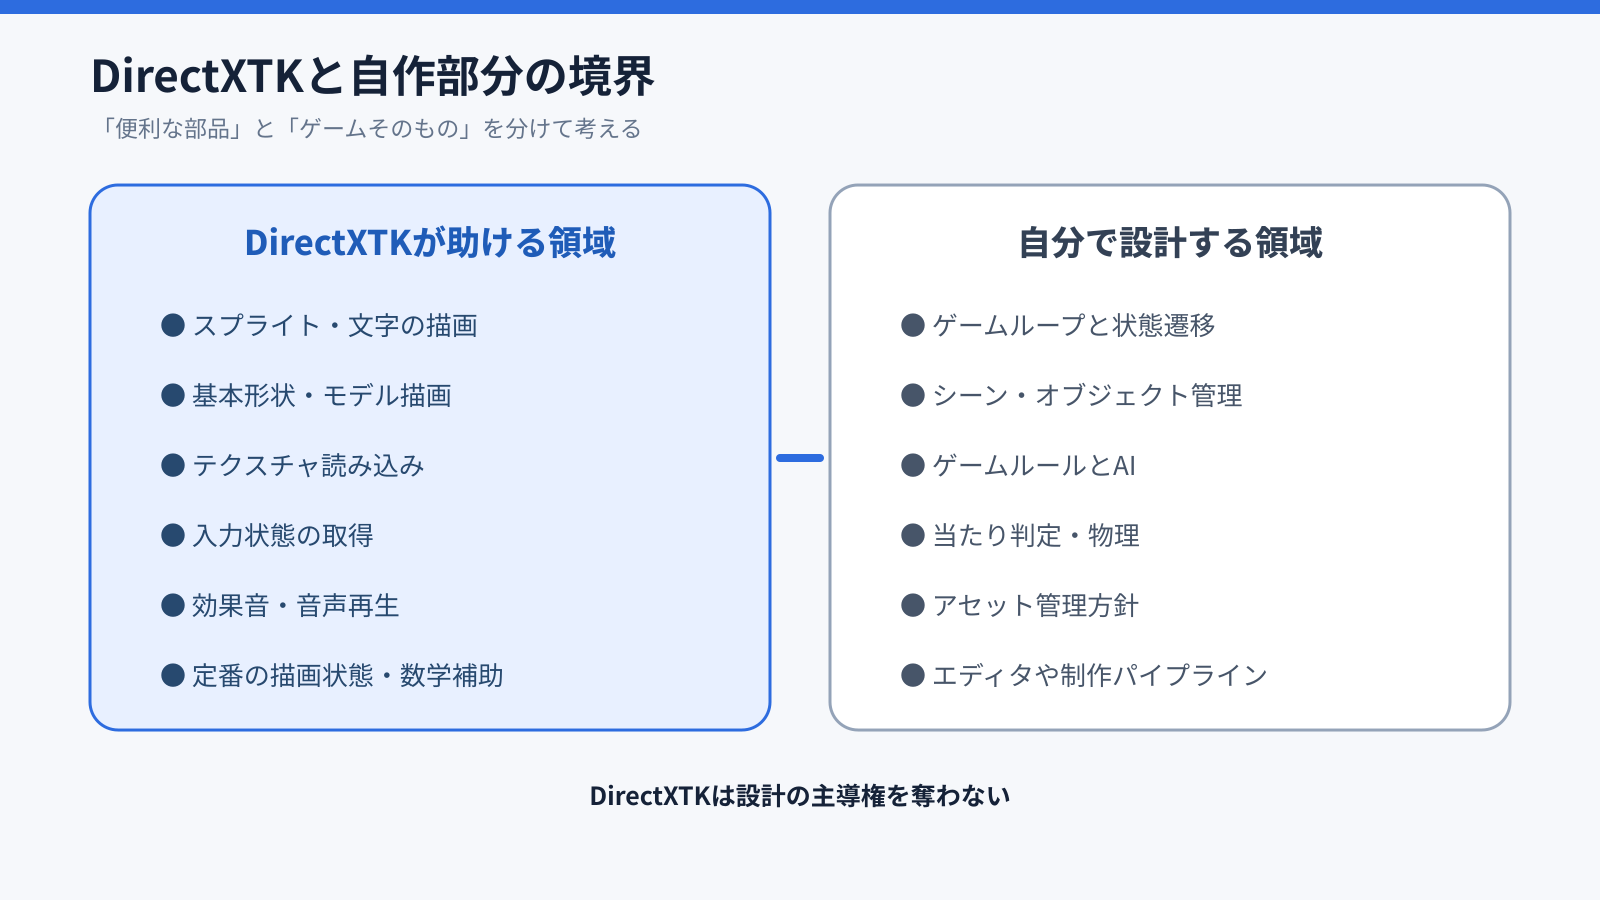
DirectXTKが担当するのは便利な部品。ゲーム全体の設計はアプリケーション側が担う
つまり、DirectXTKを採用しても、少なくとも次のような部分は自分で設計します。
- 更新と描画を回すゲームループ
- タイトル、ゲーム中、結果画面などの状態遷移
- キャラクターや敵、弾などのオブジェクト管理
- 当たり判定、ゲームルール、AI
- アセットの所有方法と読み込みのタイミング
> DirectXTKは「ゲームを完成させる仕組み」ではなく、「Direct3D 11でゲームを作るときの定番作業を短くする道具」と考えるのが適切です。
## 初期化処理を任せると、利用側のコードはどう変わるか
DirectXTKの公式チュートリアルやVisual Studioテンプレートでは、`DeviceResources`という補助クラスを使って、Direct3Dデバイス、デバイスコンテキスト、スワップチェーン、レンダーターゲット、深度バッファなどの初期化と管理をまとめます。
ここでは、800×600のウィンドウを作り、背景色でクリアして表示するだけの最小例を比較します。どちらもWin32のウィンドウ作成とメッセージループは必要ですが、Direct3D 11の初期化部分が大きく変わります。
### Direct3D 11を直接初期化する場合
直書きでは、スワップチェーンの設定、デバイスとコンテキストの作成、バックバッファの取得、レンダーターゲットビューの作成、ビューポートの設定、COMオブジェクトの保持を自分で行います。
```cpp
#include
#include
#include
#pragma comment(lib, "d3d11.lib")
using Microsoft::WRL::ComPtr;
ComPtr g_device;
ComPtr g_context;
ComPtr g_swapChain;
ComPtr g_renderTarget;
LRESULT CALLBACK WndProc(HWND hwnd, UINT msg, WPARAM wp, LPARAM lp)
{
if (msg == WM_DESTROY)
{
PostQuitMessage(0);
return 0;
}
return DefWindowProc(hwnd, msg, wp, lp);
}
bool InitializeDirect3D(HWND hwnd)
{
DXGI_SWAP_CHAIN_DESC desc{};
desc.BufferDesc.Width = 800;
desc.BufferDesc.Height = 600;
desc.BufferDesc.Format = DXGI_FORMAT_R8G8B8A8_UNORM;
desc.SampleDesc.Count = 1;
desc.BufferUsage = DXGI_USAGE_RENDER_TARGET_OUTPUT;
desc.BufferCount = 2;
desc.OutputWindow = hwnd;
desc.Windowed = TRUE;
desc.SwapEffect = DXGI_SWAP_EFFECT_DISCARD;
D3D_FEATURE_LEVEL level{};
if (FAILED(D3D11CreateDeviceAndSwapChain(
nullptr, D3D_DRIVER_TYPE_HARDWARE, nullptr, 0,
nullptr, 0, D3D11_SDK_VERSION,
&desc, &g_swapChain, &g_device, &level, &g_context)))
{
return false;
}
ComPtr backBuffer;
if (FAILED(g_swapChain->GetBuffer(
0, IID_PPV_ARGS(backBuffer.GetAddressOf()))))
{
return false;
}
if (FAILED(g_device->CreateRenderTargetView(
backBuffer.Get(), nullptr, &g_renderTarget)))
{
return false;
}
D3D11_VIEWPORT viewport{};
viewport.Width = 800.0f;
viewport.Height = 600.0f;
viewport.MaxDepth = 1.0f;
g_context->RSSetViewports(1, &viewport);
return true;
}
int WINAPI wWinMain(HINSTANCE instance, HINSTANCE, PWSTR, int show)
{
WNDCLASS wc{};
wc.lpfnWndProc = WndProc;
wc.hInstance = instance;
wc.lpszClassName = L"RawD3D11Window";
RegisterClass(&wc);
RECT rect{ 0, 0, 800, 600 };
AdjustWindowRect(&rect, WS_OVERLAPPEDWINDOW, FALSE);
HWND hwnd = CreateWindowEx(
0, wc.lpszClassName, L"Direct3D 11 直書き",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT, CW_USEDEFAULT,
rect.right - rect.left, rect.bottom - rect.top,
nullptr, nullptr, instance, nullptr);
if (!hwnd || !InitializeDirect3D(hwnd)) return 1;
ShowWindow(hwnd, show);
MSG msg{};
while (msg.message != WM_QUIT)
{
if (PeekMessage(&msg, nullptr, 0, 0, PM_REMOVE))
{
TranslateMessage(&msg);
DispatchMessage(&msg);
continue;
}
const float color[] = { 0.08f, 0.12f, 0.20f, 1.0f };
ID3D11RenderTargetView* target = g_renderTarget.Get();
g_context->OMSetRenderTargets(1, &target, nullptr);
g_context->ClearRenderTargetView(target, color);
g_swapChain->Present(1, 0);
}
return 0;
}
```
### DirectXTK公式テンプレートのDeviceResourcesを使う場合
`DeviceResources`をプロジェクトに用意しておけば、利用側ではウィンドウを渡し、デバイス依存リソースとウィンドウサイズ依存リソースの作成を呼び出すだけです。描画時も、必要なオブジェクトをアクセサーから取得し、最後に`Present`を呼びます。
```cpp
#include
#include
#include "DeviceResources.h"
std::unique_ptr g_deviceResources;
LRESULT CALLBACK WndProc(HWND hwnd, UINT msg, WPARAM wp, LPARAM lp)
{
if (msg == WM_DESTROY)
{
PostQuitMessage(0);
return 0;
}
return DefWindowProc(hwnd, msg, wp, lp);
}
int WINAPI wWinMain(HINSTANCE instance, HINSTANCE, PWSTR, int show)
{
WNDCLASS wc{};
wc.lpfnWndProc = WndProc;
wc.hInstance = instance;
wc.lpszClassName = L"DirectXTKWindow";
RegisterClass(&wc);
RECT rect{ 0, 0, 800, 600 };
AdjustWindowRect(&rect, WS_OVERLAPPEDWINDOW, FALSE);
HWND hwnd = CreateWindowEx(
0, wc.lpszClassName, L"DirectXTK + DeviceResources",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT, CW_USEDEFAULT,
rect.right - rect.left, rect.bottom - rect.top,
nullptr, nullptr, instance, nullptr);
if (!hwnd) return 1;
ShowWindow(hwnd, show);
// Direct3D 11の初期化をDeviceResourcesへ任せる
g_deviceResources = std::make_unique(
DXGI_FORMAT_B8G8R8A8_UNORM,
DXGI_FORMAT_UNKNOWN); // 今回は深度バッファ不要
g_deviceResources->SetWindow(hwnd, 800, 600);
g_deviceResources->CreateDeviceResources();
g_deviceResources->CreateWindowSizeDependentResources();
MSG msg{};
while (msg.message != WM_QUIT)
{
if (PeekMessage(&msg, nullptr, 0, 0, PM_REMOVE))
{
TranslateMessage(&msg);
DispatchMessage(&msg);
continue;
}
auto context = g_deviceResources->GetD3DDeviceContext();
auto target = g_deviceResources->GetRenderTargetView();
auto viewport = g_deviceResources->GetScreenViewport();
const float color[] = { 0.08f, 0.12f, 0.20f, 1.0f };
context->OMSetRenderTargets(1, &target, nullptr);
context->RSSetViewports(1, &viewport);
context->ClearRenderTargetView(target, color);
g_deviceResources->Present();
}
return 0;
}
```
比較すると、直書き版にあった`DXGI_SWAP_CHAIN_DESC`の設定、`D3D11CreateDeviceAndSwapChain`、バックバッファの取得、レンダーターゲットビューの生成が、利用側のコードから消えています。さらに公式の`DeviceResources`は、ウィンドウサイズ変更時のリソース再作成、デバイスロストからの復旧、デバッグレイヤーがない環境でのフォールバックなどもまとめて扱います。
> DirectXTKを使う利点は、Direct3D 11を使わなくてよくなることではありません。毎回必要になる初期化と管理を信頼できる共通部品へ任せ、ゲーム側のコードを描画やゲームロジックに集中させられることです。
注:`DeviceResources`はDirectXTK本体のNuGetライブラリに含まれる単一APIではなく、DirectXTK公式のVisual Studioテンプレートやサンプルで提供される補助クラスです。この比較は、公式テンプレートを使ったときに自分が記述・保守する`Main.cpp`の差を示しています。
## 使うメリット
最大のメリットは、定番処理の実装量を減らしつつ、Direct3D 11の構造を隠しすぎないことです。高水準のゲームエンジンほど自動化はしませんが、その分、レンダリングの流れやリソースの扱いを自分で決められます。(特に、DirectXでのプログラミングを求められるゲーム業界志望の人におすすめです)
そのためDirectXTKは、Direct3D 11を学びながら小規模なゲームや描画アプリケーションを作りたい場合や、独自フレームワークの土台に必要な機能だけ取り込みたい場合に向いています。
## DirectXTexとの関係
名前の似た`DirectXTex`なんてのもあります。同じDirectXTKのライブラリのセットにも入ってたりしますが、主に画像の読み書き、DDSの読み書き、リサイズ、形式変換、ミップマップ生成、ブロック圧縮などを行う、本格的なテクスチャ処理ライブラリです。主に制作ツールやコンテンツパイプラインでの利用を想定しています。まぁ、使う時が来たらまた説明します。
一方、DirectXTKの`DDSTextureLoader`と`WICTextureLoader`は、ゲーム実行時に加工済みの画像を軽量に読み込むためのものです。ゲーム内で画像を表示するだけなら、まずDirectXTKのローダーで十分です。画像を事前変換・圧縮する工程が必要になったときに、DirectXTexを別の道具として検討します。
## まとめ
- DirectXTKは、Direct3D向けのC++ヘルパークラス集
- 2D・3D描画、テクスチャ、入力、音声、数学などの定番処理を補助する
- Direct3D 11を置き換えるものではなく、ゲームエンジンでもない
- ゲームループ、シーン、ルール、オブジェクト管理は自分で設計する
- DirectXTexは主にテクスチャの加工や制作パイプラインを担う別ライブラリ
## 参考資料
- [Microsoft DirectXTK](https://github.com/microsoft/DirectXTK?ref=geekjp.com)
- [DirectXTK Wiki](https://github.com/microsoft/DirectXTK/wiki?ref=geekjp.com)
- [DirectXTex Wiki](https://github.com/microsoft/DirectXTex/wiki?ref=geekjp.com)
### DirectXTKでゲーム制作 第0回:Visual Studio 2026をインストールしよう
URL: https://www.geekjp.com/directxtk-lesson00/
Last updated: 2026-09-20T18:45:51.000Z
このページでは、**DirectXTKを使ってC++のゲームプログラムを作るための準備**として、Visual Studio Community 2026をインストールします。
この回で行うのは、Visual Studioのインストールまでです。DirectXTK本体の準備、DirectX 11のスタータープロジェクト、プロジェクト参照などの設定は次の回で行います。
## 🧰 1.Visual Studioとは
Visual Studioは、C++のプログラムを書くための開発ソフトです。
Visual Studioには、主に次の機能が入っています。
- プログラムを書くためのエディター
- C++のプログラムを実行できる形に変換するコンパイラー
- プログラムの間違いを調べるデバッガー
- プロジェクトやファイルを管理する機能
DirectXTKだけを用意しても、C++のプログラムを作ることはできません。先にVisual Studioをインストールして、C++を開発できる環境を用意します。
## ✅ 2.インストール前の確認
作業を始める前に、次のものを確認してください。
- Windowsを使用している
- インターネットに接続されている
- パソコンにソフトをインストールする権限がある
- 十分な空き容量がある
今回の画面では、必要な容量として約12GBと表示されています。必要な容量は、選択する機能やVisual Studioの更新状況によって変わります。
学校のパソコンなどで管理者権限がない場合は、先生や管理者に確認してください。
## 🌐 3.Visual Studioの公式サイトを開く
次のVisual Studio公式サイトを開きます。
[Visual Studio公式サイト](https://visualstudio.microsoft.com/ja/?ref=geekjp.com)
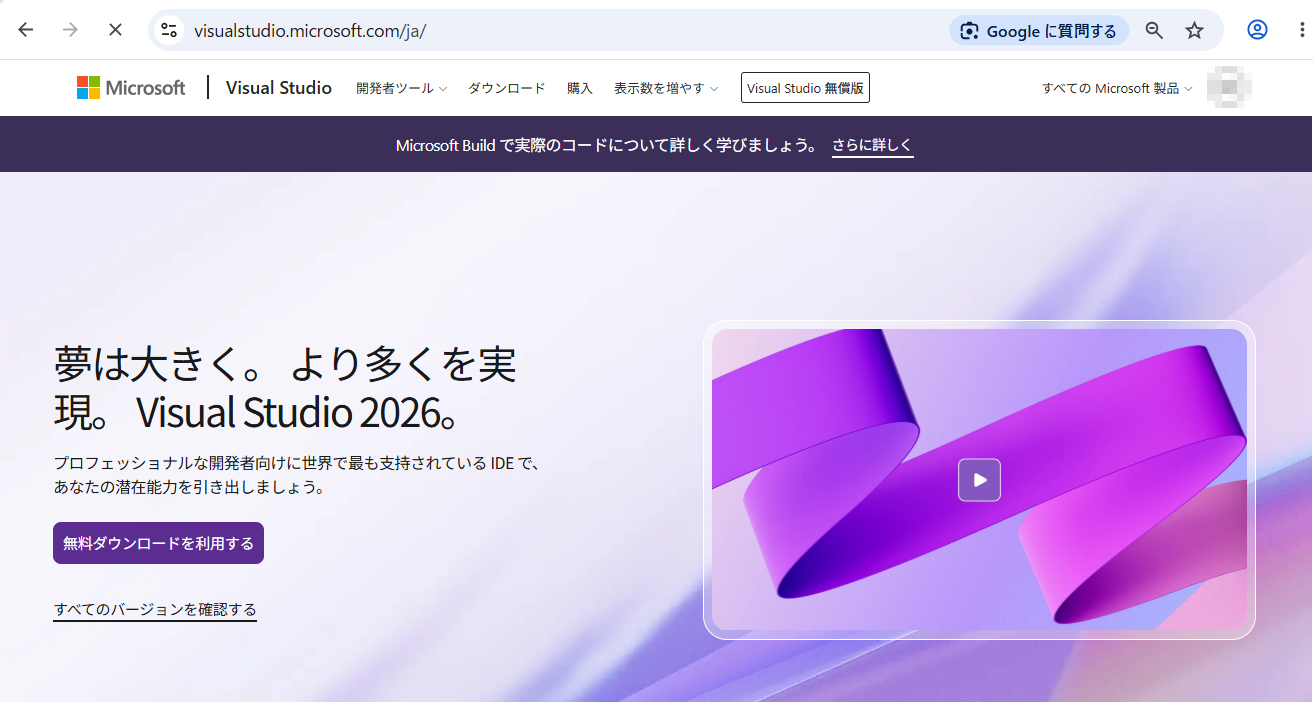
画面に表示されている「**無料ダウンロードを利用する**」をクリックします。画面のデザインやボタンの位置は、更新によって変わることがあります。
## ⬇️ 4.インストーラーをダウンロードする
ダウンロードが始まると、ブラウザーのダウンロード欄に `VisualStudioSetup.exe` が表示されます。
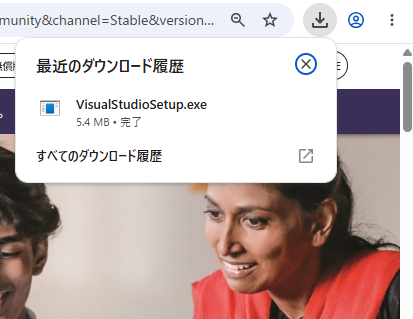
ダウンロードが終わるまで待ちます。
## 📁 5.ダウンロードしたファイルを開く
エクスプローラーで「ダウンロード」フォルダーを開きます。
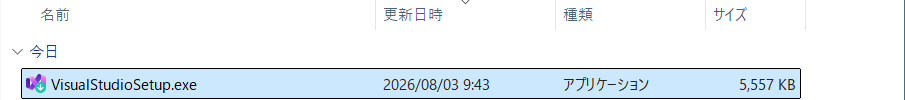
ダウンロードした `VisualStudioSetup.exe` をダブルクリックしてください。Windowsから確認画面が表示された場合は、内容を確認して「**はい**」を選びます。
## ⏳ 6.Visual Studio Installerの準備を待つ
Visual Studio Installerを動かすための準備が始まります。
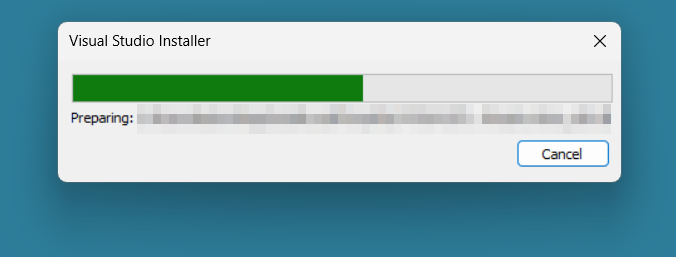
この画面は自動的に進みます。キャンセルを押さずに、そのまま待ってください。
## ▶️ 7.「続行」を押す
Visual Studio Installerの説明と、ライセンスに関する画面が表示されます。
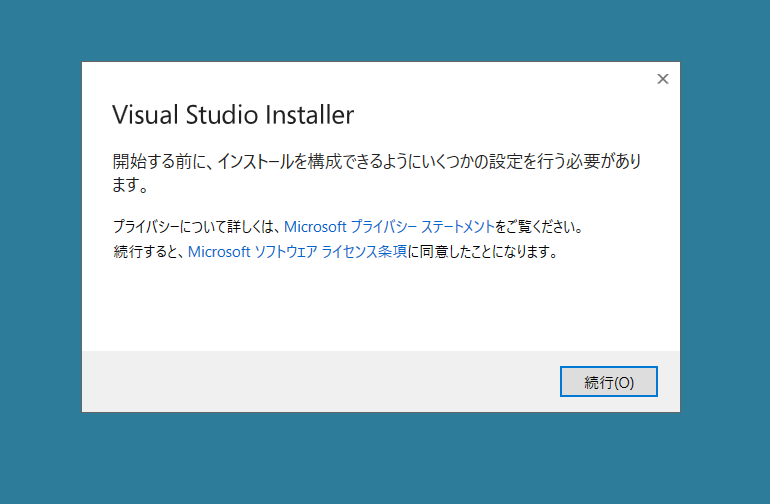
内容を確認して、右下の「**続行**」をクリックします。
## ⚙️ 8.インストーラーの準備が終わるまで待つ
Visual Studio Installer本体の検証とインストールが行われます。
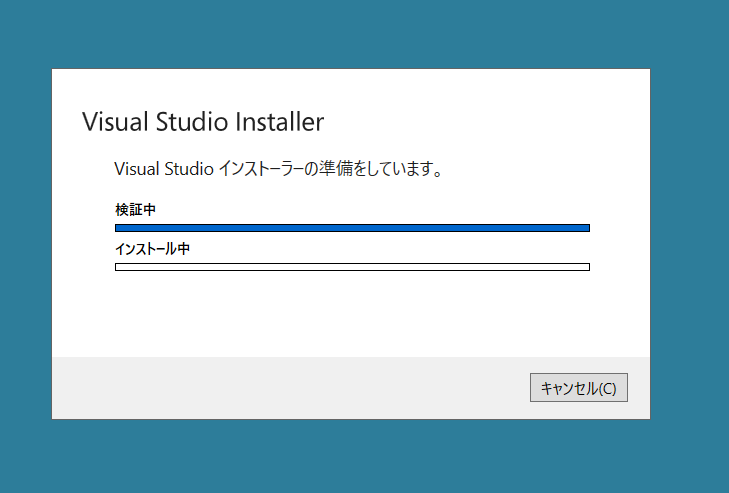
この処理も自動的に進みます。画面が切り替わるまで待ってください。
## 🧩 9.インストールする機能を選ぶ
Visual Studioでは、使用目的に合わせて必要な機能を選びます。
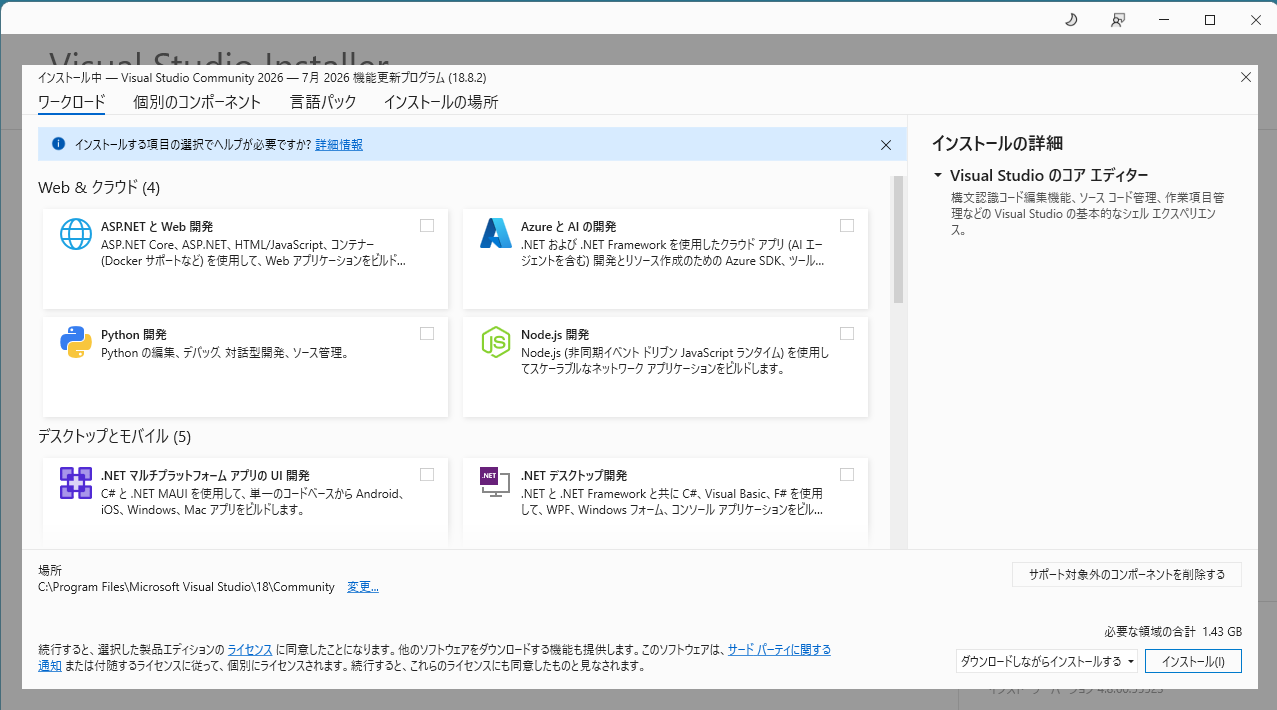
> ⚠️ 何も選ばずにインストールしてはいけません。DirectXTKを使ったC++ゲーム開発に必要な機能(下で選ぶよ)を選んでから、インストールを開始します。
## 💻 10.「C++によるデスクトップ開発」を選ぶ
「デスクトップとモバイル」の中にある「**C++によるデスクトップ開発**」をクリックして、チェックを付けます。
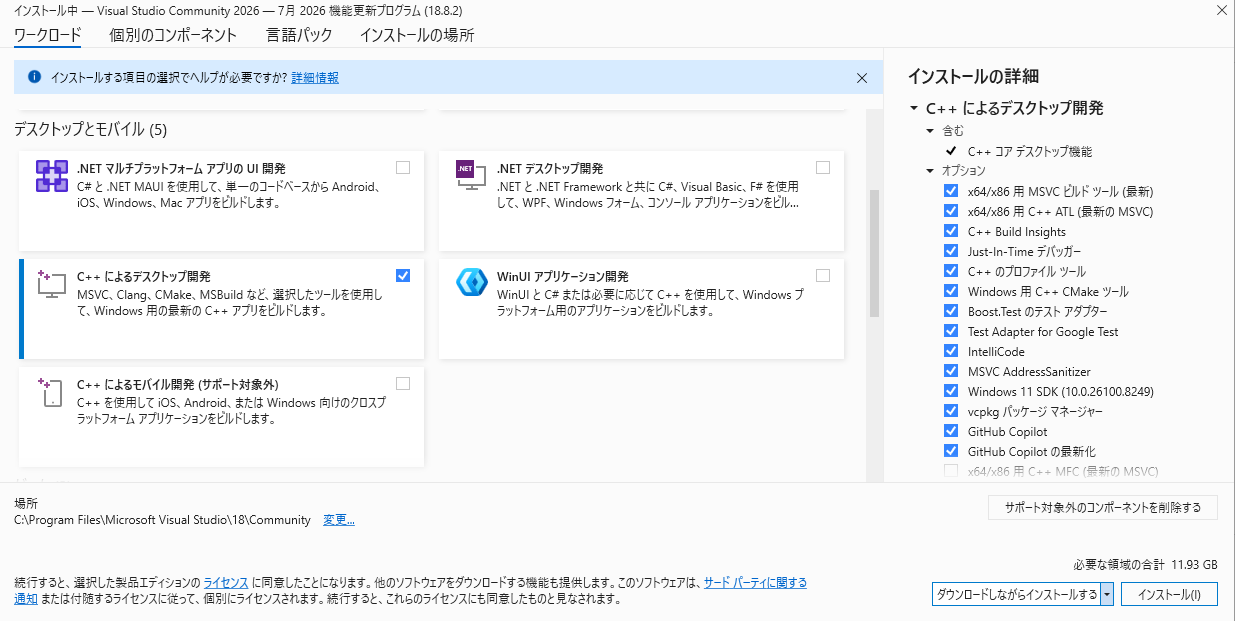
この講座では、まず「C++によるデスクトップ開発」が選択されていれば構いません。
右側の「インストールの詳細」は、基本的に初期設定のままで構いません。
そのまま「インストール」を押してください。
※**「C++によるゲーム開発」は選択しなくて構いません。 この講座では「C++によるデスクトップ開発」だけを使用します。**
右側の細かな項目は、最初は基本的に初期設定のままで構いません。
容量が足りない場合や、Cドライブ以外にデータ用ドライブがある場合は、必要に応じてインストール場所を変更できます。ただし、Visual Studio関連の一部ファイルはCドライブにも入るため、特に理由がなければデフォルト設定のままがおすすめです。
> ⚠️ 「C++によるモバイル開発」ではありません。必ず「C++によるデスクトップ開発」を選んでください。
## 🚀 11.インストールを開始する
画面右下の「**インストール**」をクリックします。
「ダウンロードしながらインストールする」と表示されている場合は、そのままで構いません。
インストールする容量を確認してから開始してください。
## ☕ 12.インストールが終わるまで待つ
Visual Studio本体と、C++の開発に必要なファイルのダウンロードが始まります。
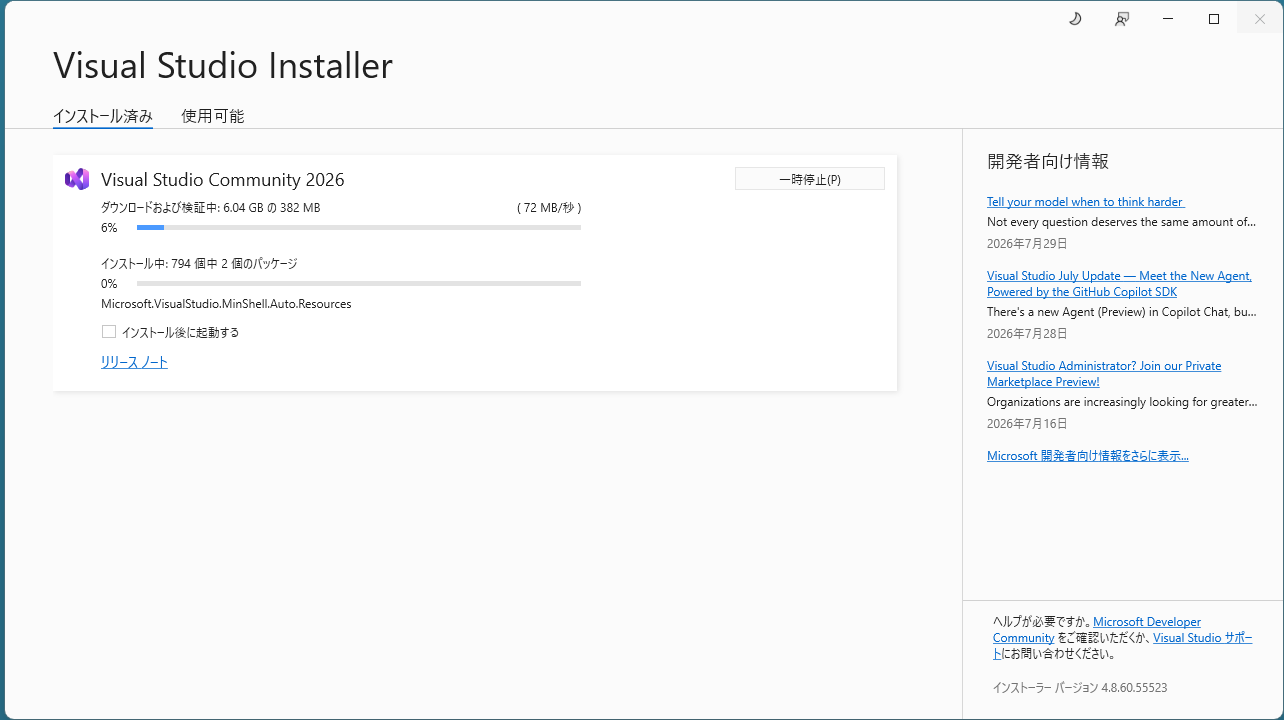
インストール中は、次のことに注意してください。
- パソコンの電源を切らない
- インターネット接続を切らない
- Visual Studio Installerを閉じない
ダウンロードするファイルが多いため、完了まで時間がかかることがあります。
進行状況が100%になり、インストール完了の表示が出るまで待ってください。
## 🎉 13.インストール完了
インストールが完了したら、Visual Studio Installerに「**起動**」などのボタンが表示されます。
これで、C++のプログラムを作るためのVisual Studioの準備は完了です。
## 🛠️ うまくいかない場合
### ❓ VisualStudioSetup.exeを開いても何も起きない
少し待ってから、もう一度実行してください。
それでも起動しない場合は、ファイルを右クリックして「**管理者として実行**」を試します。(そんなことしなくても大体うまくいくはずですが)
### 💾 空き容量が足りないと表示された
それはもうどうにもならんです。不要なファイルを削除して、空き容量を増やしてください。今後、プロジェクト作っていくと、Visual Studioが余計なファイル(VSの設定フォルダなどに余計なファイルを作りまくってどんどんインフレします。あとで余計なファイルの消し方も教えようかと思うけど。。。)
インストール先を変更する場合は、上部の「**インストールの場所**」から設定できます。
### 🔧 「C++によるデスクトップ開発」を選び忘れた
全然余裕。インストール後でも追加できます。
Visual Studio Installerを起動し、Visual Studio Community 2026の「**変更**」を選びます。
その後、「**C++によるデスクトップ開発**」にチェックを付けて、追加インストールしてください。
### ゲーム音楽とMIDI その3(結)
URL: https://www.geekjp.com/gemuyin-le-tomidi-sono3/
Last updated: 2026-09-16T15:34:32.000Z
> **ゲーム音源の歴史シリーズ**
>
> 1. [ゲームの音はどう作られていた? ― 専用回路・PSG・FM音源の時代](https://www.geekjp.com/gemuyin-le-tomidi-sono1/)
> 2. [MIDIとは何だったのか? ― ゲーム音楽と演奏データの革命](https://www.geekjp.com/midi-game-music-history/)
> 3. **MIDIはなぜゲームから消えた? ― PCM・ストリーミングと現代ゲームサウンド ← 今ここ**
前回は、MIDIが音声データではなく、
> **「何を、いつ、どのように演奏するか」を伝える情報**
であることを見てきました。MIDIや独自形式の演奏データを使って曲を鳴らす方式は、少ないデータで長い音楽を演奏できるため、ストレージもメモリも小さかった時代のゲームと非常に相性のよい方法でした。しかし現在のゲームでは、BGMを `.mid` ファイルで直接再生することは、以前ほど一般的ではありません。
代わりに使われているのは、録音した楽器、ボーカル、環境音などの**実際の音のデータ**です。ただし、ゲーム音楽が単純に「MIDIの時代」から「PCMの時代」へ移ったわけではありません。PCMそのものは以前から存在し、ゲームでも短い効果音や楽器音に使われていました。難しかったのは、何分もある音楽を録音したまま、大量にゲームへ入れることです。
だからこそ、少ないデータで曲を鳴らせるMIDIや独自形式の演奏データに意味がありました。それが今では、ゲームの中へ実際の音を大量に入れられるようになっています。何が変わり、PCMはゲームの中でどのように使われてきたのでしょうか。
最終回では、PCMとサンプリングの基本から、CD-ROM、Final Fantasy VII、Unreal、そして現在のインタラクティブオーディオまで追いかけます。
---
## PCMはMIDIより後に生まれたわけではない
ゲーム音源の歴史を一本の年代順で見ると、
> MIDIの時代が終わって、その後PCMが登場した
ように感じるかもしれません。実際には、PCMそのものはずっと以前から存在します。ゲームでも短い音声サンプルを再生する方法は早くから使われていました。
問題は、**大量のPCMデータをゲームへ入れるコスト**です。録音時間が長くなるほど、
- ROMやディスク容量を使う
- RAMを使う
- 音声用メモリを使う
- データを読み込む帯域が必要になる
- 再生処理も必要になる
という負担が増えます。数秒の効果音なら現実的でも、
> **何分もあるBGMを何十曲も丸ごと保存する**
となると、昔のゲームでは大きな問題でした。だから、MIDIや独自形式の演奏データを使う方式には大きな意味があったのです。
---
## PCMは「音そのもの」を数字にする
では、そのPCMは、PSGやFM音源と何が違うのでしょうか。PSGやFM音源は、回路や計算によって波形を作っていました。PCM(Pulse Code Modulation)は考え方が違います。
**実際の波形を一定間隔で測り、その値を数字として記録します。**例えばマイクから入った音を、
```
実際の波形
↓
一定間隔で測る
↓
数値にする
↓
保存する
```
ことで、あとからその波形を再現できます。これが、録音した声や楽器をゲームで鳴らすための基本になります。

---
## サンプリング周波数と量子化ビット数
PCMを理解するときに、よく出てくる数字が二つあります。
### サンプリング周波数
**1秒間に何回、波形の値を測るか**です。44.1kHzなら、1秒間に44,100回測ります。回数が増えるほど、時間方向に細かく波形を記録できます。
### 量子化ビット数
測った波形の高さを、**何段階の数値で表現できるか**です。例えば、
- 8bitなら256段階
- 16bitなら65,536段階
で値を表せます。この二つは、**同じ波形をどちらの方向に細かく記録するか**の違いです。
| 項目 | 細かくするもの | 数値が大きいと |
| --------- | --------- | ----------------- |
| サンプリング周波数 | 時間方向の測定回数 | 波形を、より短い間隔で測れる |
| 量子化ビット数 | 振幅方向の記録段階 | 波形の高さを、より細かく記録できる |
言い換えると、サンプリング周波数は**「1秒を何個に区切って測るか」、量子化ビット数は「波形の高さを何段階に分けて記録するか」**です。

### ちょっと寄り道――「8bitゲーム機だから8bit音声」ではない
ここは、ゲーム機の話で特に誤解されやすいところです。ファミコンやSG-1000などを「8bitゲーム機」と呼ぶ場合、その8bitは主に**CPUのデータ幅**を指しています。一方、
> 8bit PCM
> 16bit PCM
という場合は、**音声の量子化ビット数**です。同じ「8bit」という言葉でも意味が違います。さらに、PSGやFM音源は、録音したPCM波形を「何bit・何kHz」で保存して再生することを基本にした方式ではありません。
ですから、
> 「このゲーム機は8bitだから、音も8bitだった」
とは単純には言えません。第1回の年表でPSGやFM音源のPCM bit数を「該当なし」としたのは、このためです。同じ「8bit」でも、ゲーム機の世代を表す言葉と、PCMの記録精度を表す言葉は別物です。ここを分けておくと、CD-DAの「16bit・44.1kHz」という説明も混同せずに読めます。
---
## 「短い録音素材+演奏データ」という方法
PCMを使えることと、BGM全体を録音して入れられることは別の話です。何分もある録音は重くても、短い効果音や楽器音なら、ゲームへ入れやすくなります。そこで非常に重要になったのが、
> **短いPCMサンプル + 演奏データ**
という方式です。例えば、ピアノの音を曲の最初から最後まで録音する必要はありません。ピアノ、ドラム、ベース、ストリングスなどの短い音を素材として用意し、**「どの音を、いつ、どの高さで、どの強さで鳴らすか」**という演奏データと組み合わせます。

演奏データにはMIDIを使う場合もあれば、ゲーム機やゲームエンジンごとの独自形式を使う場合もあります。ここで重要なのは、形式の名前ではなく、
> **音素材と演奏情報を分離する**
という発想です。これは、前回までに見てきたMIDIと非常によく似ています。
---
## CD-ROMで何が変わった?
1990年代になると、家庭用ゲーム機でもCD-ROMが使われるようになります。CD-ROMは、それ以前のROMカートリッジと比べて非常に大きな容量を持ちます。さらに音楽CDと同じCD-DAなら、**16bit・44.1kHzのステレオ音声**を完成した音楽として収録できます。
すると、
> 「演奏データを入れて本体で演奏させる」
だけでなく、
> **「完成した音楽を録音して、そのまま入れる」**
という選択肢が現実的になります。ただし、CD-ROMが登場した瞬間に、すべてのゲームが録音BGMへ切り替わったわけではありません。容量以外にも、
- RAM
- 読み込み速度
- CDドライブのシーク
- 同時に必要なゲームデータ
- ループ
- BGMの切り替え
- 効果音やボイスとの競合
など、ゲーム特有の事情があります。そのため1990年代は、いろいろな方式が混ざった非常に面白い時期になりました。
---
## Final Fantasy VII ― CD-ROMでも、曲を本体で演奏していた
1997年のPlayStation版『Final Fantasy VII』は、この中間時代を説明するのに分かりやすい例です。『Final Fantasy VII』では、**サンプリング音源+演奏データ**という組み合わせが使われています。公開されているFFVIIのサウンド形式解析資料によると、ゲーム内の楽器音はPlayStationのADPCMサンプルとして格納されています。[FF7 Flat WikiのINSTR.ALL解析](https://ff7-mods.github.io/ff7-flat-wiki/FF7/PSX/Sound/INSTRx.ALL.html?ref=geekjp.com)でも、楽器サンプルがPSX ADPCMフレームとして収録されていることが説明されています。
そしてFFVIIは、こうした楽器サンプルとMIDIに似た独自形式の演奏データを組み合わせ、ゲーム機上でBGMを鳴らしていました。この演奏データは、解析資料では**AKAOシーケンス**と呼ばれています。[AKAO sequenceの技術解析](https://squall-leonhart.net/ff-wiki/FF7/PSX/Sound/AKAO%5Fsequence.html?ref=geekjp.com)では、MIDIに似た役割を持ち、PlayStation向けに調整された独自形式として説明されています。つまり、単純化すると、
```
楽器のPCM/ADPCMサンプル
+
MIDIに似た独自形式の演奏データ
(AKAOシーケンス)
↓
PlayStationの音源で演奏
```
という構造です。ここで大事なのは、**「FFVIIがMIDIファイルを再生していた」と言うことではありません。**実際に使われていたのは、AKAOシーケンスという独自形式の演奏データです。
しかし、
> 音素材と演奏情報を分けて、ゲーム機上で曲を作る
という考え方は、MIDI時代から続くものです。CD-ROM時代になっても、この方法にはまだ十分なメリットがありました。
---
## Unreal ― MIDIでも録音BGMでもないTracker音楽
1998年のPCゲーム『Unreal』も面白い例です。Unrealでは、**Tracker/Module系の音楽**が使われました。Unreal系の古い技術資料を保存している[Unreal Archive](https://unrealarchive.org/wikis/unreal-wiki/Legacy%3AUMX%5FFile.html?ref=geekjp.com)では、UMX形式がMOD/Tracker系のファイルをもとにした音楽コンテナであることが説明されています。
また、Unreal Editorでは `.mod`、`.it`、`.xm`、`.s3m` などのTracker形式をUMXへ取り込むことができました。Tracker音楽も、考え方は、
```
PCMサンプル
+
パターン
+
音程・音量・エフェクトなどの演奏情報
```
です。つまり、完成した音楽を最初から最後まで録音しているわけではありません。しかしMIDIのように「外部の音源へ演奏を依頼する」のとも違います。
**音素材そのものを楽曲ファイル内に持ち、音程・音量・エフェクトなどの演奏情報を記録したパターンを、決められた順番で再生する。**MIDIと録音済みBGMの間にある、非常に実用的な方式でした。
---
## 1990年代は「MIDIから録音へ一直線」ではなかった
ここまでの流れを整理すると、ゲーム音楽は、
```
MIDI
↓
録音BGM
```
と単純に切り替わったわけではありません。
| 時代 | よく見られた考え方 |
| -------- | ------------------------------ |
| 1990年代前半 | FM音源、MIDI、独自形式の演奏データ、サンプル音源 |
| 1990年代中盤 | MIDI/独自形式の演奏データ+PCMサンプル |
| 1990年代後半 | PCMサンプル+演奏データ、Tracker、録音BGMが混在 |
| 2000年代 | 録音音声や圧縮音声のストリーミングがより実用的に |
| 現代 | 録音素材+リアルタイムミキシング+動的制御 |
技術は一斉に置き換わるのではなく、**新しい選択肢が増え、その中で用途に合う方法が選ばれていった**と見る方が正確です。
---
## なぜゲーム内でMIDIを直接再生する用途が減ったのか
では、なぜPCゲームなどで一般的だった、
> `.mid` をユーザー側のMIDI音源で演奏する
という方法は減っていったのでしょうか。
### 1.ストレージが大きくなった
CD-ROM、DVD、大容量ROM、HDDなどによって、録音音声を保存するコストが大きく下がりました。MIDIの「非常に小さい」という利点は、以前ほど決定的ではなくなります。
### 2.RAMや音声再生能力が向上した
PCMサンプルや長い音声を扱えるメモリと処理能力が増えました。圧縮音声を展開しながら再生することも現実的になります。
### 3.制作者が意図した音を、そのまま届けられる
前回見たように、MIDIは音源によって音が変わります。これは面白さでもありましたが、制作側には、
> **「どのユーザーにも、完成させた同じ音を聞かせたい」**
という要求があります。録音済みの音楽なら、
- 楽器の音色
- エフェクト
- ミックス
- 演奏ニュアンス
まで含めて制作側で決められます。
### 4.ゲーム音楽自体が複雑になった
生楽器、ボーカル、オーケストラ、環境音、映画的な音響処理などを含む音楽では、汎用MIDI音源だけで完成形を再現することは難しくなります。結果として、
> **ゲーム内の最終再生フォーマットとしてMIDIを使う必要性**
は徐々に小さくなっていきました。
---
## では、MIDIは消えたのか?
ここで少し言葉に注意が必要です。**MIDIそのものが消えたわけではありません。**現在でも作曲では、
```
MIDI入力
↓
DAW
↓
ソフトウェア音源
↓
エフェクト・ミックス
↓
WAVなどへ書き出し
```
という制作方法が普通に使われています。ゲームに最終的に入るものがWAVや圧縮音声でも、その音楽を作る途中ではMIDIが使われていることがあります。ですから、
> **ゲームに `.mid` が入っていない = MIDIが使われていない**
ではありません。減ったのは主に、
> **ユーザー環境のMIDI音源を使って、ゲームBGMを直接再生する**
という使い方です。
---
## 現代ゲームは、むしろ「演奏を制御する」方向へ戻ってきた
完成した録音音源を使えるようになったなら、
> 「1曲のWAVを最初から最後まで再生すれば、それで終わり」
なのでしょうか。ゲームではそう簡単ではありません。例えば、
```
フィールド探索
↓
敵を発見
↓
ドラムレイヤー追加
↓
戦闘開始
↓
戦闘パートへ遷移
↓
ボスHP低下
↓
さらに激しいレイヤー
↓
勝利
↓
終結フレーズへ
```
のように、プレイヤーの行動で音楽を変化させたいことがあります。映画なら映像の時間が最初から決まっています。ゲームは、プレイヤーがいつ戦闘を始め、何分で勝つのか分かりません。
そこで現代のゲームサウンドでは、
> **録音した音素材を持ちながら、いつ・何を・どう鳴らすかをリアルタイムで制御する**
ことが重要になります。これはMIDIそのものではありません。しかし、
> **音そのものと、演奏・再生を制御する情報を分けて考える**
という点では、MIDIの話とどこか似ています。

---
## 現代のゲームサウンドミドルウェア
現在では、こうした複雑な音の制御を助ける**ゲームサウンドミドルウェア**が広く使われています。代表的なものとして、
- **CRI ADX**
- **FMOD**
- **Wwise**
があります。
### CRI ADX
CRIのADXでは、Cueと呼ばれる単位で音を管理し、ゲーム側の状態に応じて再生するトラックを切り替えたり、クロスフェードしたりできます。[CRI Middlewareの解説](https://blog.criware.com/index.php/2023/11/10/adx2-beginners-guide-2-the-cue-system/?ref=geekjp.com)では、Selectorによるトラック切り替えをビートに同期させるなど、インタラクティブミュージック向けの機能も紹介されています。
### FMOD
[FMOD](https://www.fmod.com/?ref=geekjp.com)は、自身をゲーム向けの**adaptive audio**ソリューションとして位置づけています。ゲームから送られるパラメータによって、
- 音量
- フィルター
- パート
- 再生位置
- エフェクト
などを変化させることができます。
### Wwise
Wwiseにもインタラクティブミュージックのための仕組みがあります。[AudiokineticのWwise公式教材](https://www.audiokinetic.com/en/learning/videos/yfr6liqyesk/?ref=geekjp.com)では、Music Segment間の遷移ルールを設定し、必要に応じて専用のTransition Segmentを挟むなど、ゲーム状態に応じて音楽を自然につなぐ方法が説明されています。つまり現代では、
```
録音された音素材
+
ゲームから送られる状態
+
再生ルール
↓
プレイするたびに変化するゲームサウンド
```
を作れるようになっています。
---
## ゲーム音源の歴史を、もう一度並べてみよう
全3回で見てきた流れを最後に並べます。

PCMは、この矢印の途中で突然生まれたわけではありません。短い効果音や楽器音として以前から使われ、容量の増加によって、やがて長いBGMまで扱えるようになりました。ただし、この矢印は、
> 「古い技術が消えて、新しい技術に完全に置き換わった」
という意味ではありません。現在でもFM音源は使われます。PSG風の音も使われます。
MIDIも使われます。短い音素材を演奏データで鳴らす方法も使われます。ゲームの音の歴史は、古い道具を捨ててきた歴史というより、
> **使える道具を増やしてきた歴史**
と考える方がよいでしょう。
---
## まとめ
第1回では、ゲーム専用の回路からPSG、FM音源までを見ました。第2回では、MIDIによって「演奏情報」と「音源」を分離し、異なる機器の間で共通の演奏情報を扱えるようになったことを見ました。そして今回、PCMやストリーミングによって、完成した音そのものを大量にゲームへ入れられるようになった流れを見てきました。
ゲーム内で `.mid` ファイルを直接鳴らす時代は、以前ほど一般的ではありません。しかし、
> **「音素材」と「いつ、何を、どう鳴らすか」を別々に考える**
という考え方は、現代のゲームオーディオにも残っています。スペースインベーダーでは、CPUが専用の音響回路を動かしていました。PSGでは、CPUが周波数や音量を音源へ送りました。
MIDIでは、演奏情報を共通のメッセージとして音源へ送りました。そして現代では、ゲームの状態をサウンドシステムへ送り、その状態に応じて録音素材を組み合わせ、ミックスし、変化させています。形は大きく変わりました。
でも、
> **「ゲームの状態を、どう音に変換するか」**
という問題は、ゲームが音を鳴らし始めた頃から、ずっと続いているのかもしれません。
> **← 前回:** [MIDIとは何だったのか? ― ゲーム音楽と演奏データの革命](https://www.geekjp.com/midi-game-music-history/)
>
> **シリーズ最初から読む:** [ゲームの音はどう作られていた? ― 専用回路・PSG・FM音源の時代](https://www.geekjp.com/gemuyin-le-tomidi-sono1/)
---
## 主な参考資料
- [ゲーム音楽とMIDI(BookStack)](https://bookstack.yz-learning.com/books/knowledge/page/midi?ref=geekjp.com)
- [The MIDI Association: MIDI 1.0 Core Specifications](https://midi.org/midi-1-0-core-specifications?ref=geekjp.com)
- [The MIDI Association: Standard MIDI Files](https://midi.org/standard-midi-files?ref=geekjp.com)
- [FF7 Flat Wiki: INSTRx.ALL ― PlayStation版FFVIIの楽器サンプル解析](https://ff7-mods.github.io/ff7-flat-wiki/FF7/PSX/Sound/INSTRx.ALL.html?ref=geekjp.com)
- [Final Fantasy Inside Wiki: AKAO sequence technical documentation](https://squall-leonhart.net/ff-wiki/FF7/PSX/Sound/AKAO%5Fsequence.html?ref=geekjp.com)
- [Unreal Archive: Legacy UMX File](https://unrealarchive.org/wikis/unreal-wiki/Legacy%3AUMX%5FFile.html?ref=geekjp.com)
- [Unreal Archive: Legacy Engine Directory Structure](https://unrealarchive.org/wikis/unreal-wiki/Legacy%3AEngine%5FDirectory%5FStructure.html?ref=geekjp.com)
- [CRI Middleware: ADX Beginner’s Guide #2 – The Cue System](https://blog.criware.com/index.php/2023/11/10/adx2-beginners-guide-2-the-cue-system/?ref=geekjp.com)
- [CRI Middleware: Composing Adaptive Music in AtomCraft](https://blog.criware.com/index.php/2017/04/11/composing-adaptive-music-in-atomcraft/?ref=geekjp.com)
- [FMOD Official](https://www.fmod.com/?ref=geekjp.com)
- [Audiokinetic: Wwise-201 Lesson 7 – Using Music Transitions](https://www.audiokinetic.com/en/learning/videos/yfr6liqyesk/?ref=geekjp.com)
### ゲーム音楽とMIDI その2
URL: https://www.geekjp.com/midi-game-music-history/
Last updated: 2026-09-13T17:32:41.000Z
# MIDIとは何だったのか?
## ― ゲーム音楽と演奏データの革命(言いすぎかな)
> **ゲーム音源の歴史シリーズ**[ゲームの音はどう作られていた? ― 専用回路・PSG・FM音源の時代](https://www.geekjp.com/gemuyin-le-tomidi-sono1/)**MIDIとは何だったのか? ― ゲーム音楽と演奏データの革命 ← 今ここ**[MIDIはなぜゲームから消えた? ― PCM・ストリーミングと現代ゲームサウンド](https://www.geekjp.com/gemuyin-le-tomidi-sono3/)
## 前回までの振り返り
前回は、ゲームの音が**専用の音響回路 → 波形メモリ音源 → PSG → FM音源**へと発展していく流れを見てきました。
昔のゲームは、現在のように完成した音楽ファイルをそのまま再生していたわけではありません。ゲーム機や基板に搭載された音源へ、
> **「この音程を、この音色で、このタイミングで鳴らす」**
と指示し、実際の音はその場で作っていました。
この仕組みが発展していくと、次第に、
> **何を、いつ鳴らすかという「演奏情報」**
> **その指示を受けて実際の音を作る「音源」**
を分けて考えられるようになります。
一方、1980年代の電子楽器の世界では、メーカーの違うシンセサイザーやシーケンサー同士でも、共通の方法で演奏情報をやり取りしたいという要求が高まっていました。
そこで1983年に登場したのが **MIDI(Musical Instrument Digital Interface)** です。
MIDIはゲームのために作られた規格ではありません。
しかし、
- データが非常に小さい
- 長い曲を扱いやすい
- ループさせやすい
- 演奏内容をリアルタイムに制御できる
- 外部の高性能な音源を利用できる
という特徴は、当時のゲームと非常に相性がよいものでした。
今回は細かなMIDI規格そのものを覚えることが目的ではありません。
**MIDIがなぜゲーム音楽で広まり、どんな楽しみ方を生み、なぜ一時代を築いたのか。**
そこを中心に見ていきます。
---
## なぜゲームにMIDIが向いていたのか
1980年代から1990年代前半のゲームでは、ROMやディスク、RAMの容量は現在とは比べものにならないほど限られていました。
もし数分間のBGMを「完成した録音音声」として保存するなら、曲の最初から最後まで大量の波形データを持たなければなりません。
一方MIDIでは、音そのものではなく、主に、
- どの音を鳴らすか
- いつ鳴らすか
- どのくらいの強さで鳴らすか
- どの楽器で鳴らすか
- いつ音を止めるか
といった**演奏情報**だけを扱います。
```text
完成した録音音楽
波形 波形 波形 波形 波形 波形 波形……
曲の最初から最後まで「音」そのものを保存
MIDI/シーケンス
音程
音の長さ
強さ
音色
タイミング
制御情報
```
演奏データは、録音済み音声に比べてずっと小さくできます。
しかもゲームBGMでは、同じ曲を繰り返すことがよくあります。演奏データなら、曲の終わりで先頭へ戻せばよい。ゲームの状態に合わせてテンポや音色、演奏内容を変えることもできます。
こうした特徴は、単に「MIDIというデータ形式が小さかった」から生まれたものではありません。
**実際に音を作る音源ハードウェアと、「何を、いつ、どう鳴らすか」という演奏データを分離したこと**が重要でした。
音そのものは音源側に任せ、ゲーム側には演奏に必要な情報だけを持たせる。だから、大量の波形データを保存せずに長い曲を演奏でき、同じデータを繰り返したり、ゲームの状態に応じて演奏を変えたりできたのです。
> **小さい。長く鳴らせる。繰り返せる。制御しやすい。**
これは、**音源ハードウェアと演奏データを分離するという考え方がもたらした大きな利点**であり、容量の厳しかった当時のゲームにとって、とても都合のよい性質でした。
この考え方自体は、ゲーム独自のシーケンス方式にも見られます。そしてMIDIは、この「演奏情報と音源を分ける」という考え方を、メーカーの異なる機器どうしでも扱える**共通規格**として広げました。
---
## MIDIって、結局何なの?
ここで一度だけ、MIDIそのものを整理しておきましょう。
**MIDIは音声データではありません。**
MIDI Associationの[MIDI 1.0仕様](https://midi.org/midi-1-0-core-specifications?ref=geekjp.com)では、音符、音色変更、表現制御などの情報を、異なる電子楽器や機器の間でやり取りするための仕様として定められています。
例えばMIDIでは、
- **Note On**:この音を鳴らす
- **Note Off**:この音を止める
- **Note Number**:どの高さの音か
- **Velocity**:どのくらいの強さで鳴らすか
- **Program Change**:どの楽器・音色を使うか
- **Control Change**:音量、パン、モジュレーションなどを制御する
- **Pitch Bend**:演奏中に音程を滑らかに変化させる
といった情報を送ります。
考え方としては、**楽譜と楽器を分ける**のに近いでしょう。
```text
MIDIによる演奏指示
「ピアノで」
「ドの音を」
「この強さで」
「ここで鳴らす」
↓
MIDI音源
↓
実際の音
```
MIDIケーブルの中を、ピアノの録音音声が流れているわけではありません。
流れているのは、**どう演奏するかという指示**です。
### 当時使われた主な外部MIDI音源
当時のPCゲームでは、設定画面や取扱説明書に、対応するMIDI音源の機種名がそのまま書かれていることがありました。
ここから先によく登場する、主な外部MIDI音源を先に整理しておきましょう。
| 登場年 | 外部MIDI音源 | 音源方式・規格 | 主な特徴 |
| ---- | ------------------------------ | -------------- | ------------------------------------------------------------------------------------------------------------------------------------------------ |
| 1987 | **MT-32**(Roland) | LA音源 | LA方式を採用したマルチティンバー音源モジュール。GM登場前のPCゲームで、対応音源として広く使われた [※10](https://www.roland.com/jp/lp/catalog%5Fmuseum/pdf/NAM-2899.pdf?ref=geekjp.com) |
| 1989 | **CM-32L**(Roland) | LA音源 | パソコンでの利用を意識したCMシリーズの音源。MT-32系の再生環境として、ゲームでも利用された [※10](https://www.roland.com/jp/lp/catalog%5Fmuseum/pdf/NAM-2899.pdf?ref=geekjp.com) |
| 1991 | **SC-55 Sound Canvas**(Roland) | GM / GS、PCM系音源 | GSフォーマット第1号機。Sound Canvasシリーズの出発点となった [※11](https://www.roland.com/jp/company/press%5Freleases/2015/0642/?ref=geekjp.com) |
| 1994 | **SC-88 Sound Canvas**(Roland) | GM / GS、PCM系音源 | SC-55の後継機。音色数や同時発音数が拡張された [※11](https://www.roland.com/jp/company/press%5Freleases/2015/0642/?ref=geekjp.com) |
| 1994 | **MU80**(Yamaha) | XG、AWM2音源 | XGを搭載した最初のマルチティンバー音源。32パート・64音同時発音に対応した [※12](https://www.yamaha.com/ja/about/experience/innovation-road/collection/detail/2026/?ref=geekjp.com) |
同じ「外部MIDI音源」でも、MT-32 / CM-32LとSC-55では、音源方式や前提とする音色構成が異なります。
そのためゲーム側も、単に「MIDI対応」とするだけではなく、**どの音源向けの演奏データなのか**を指定する必要がありました。
---
## じゃあ「MIDIファイル」って何?
パソコンを長く使っている人なら、`.mid` というファイルを見たことがあるかもしれません。
一般にはこれを「MIDIファイル」と呼びますが、少しだけ正確に言うと、多くの `.mid` ファイルは **SMF(Standard MIDI File)** という形式です。
[MIDI AssociationのSMF仕様](https://midi.org/standard-midi-files?ref=geekjp.com)では、MIDIの演奏情報を時間情報と一緒にファイルとして保存する方法が定められています。
難しく考える必要はありません。
```text
MIDI
演奏情報をやり取りするための決まり
↓
SMF(.mid)
その演奏情報を「曲」として保存したファイル
↓
MIDI音源
ファイルの指示を受けて実際の音を作る
```
つまり、普段「MIDIファイル」と呼んでいるものは、**MIDIの演奏情報を記録したファイル**です。
MIDIは本来、機器どうしが演奏情報をリアルタイムにやり取りするための規格です。一方のSMFは、その演奏情報を時間情報とともに保存するためのファイル形式です。
SMFには、音符だけでなく、複数のトラック、テンポ、拍子、曲名なども記録できます。ただし、ここにも録音された音声そのものが入っているわけではありません。
ここが分かると、次の現象も理解しやすくなります。
---
## PCゲームは「どんな音源を持っているか」で音が変わった
ここで、当時のPCゲーム側の事情も少し見ておきましょう。
現在のPCでは、ゲームを起動すれば基本的に音が鳴ります。しかし当時のPCでは、**すべてのユーザーが同じサウンド環境を持っているとは限りませんでした。**
FM音源ボードを持っている人もいれば、外部MIDI音源を接続している人もいる。逆に、PC本体に必ず用意されているBEEP音くらいしか使えない環境もありました。
例えば1990年のPC-9801版『ドラゴンスレイヤー英雄伝説』では、FM音源ボードがあればFM3音+SSG3音でBGMを演奏しますが、FM音源ボードがない環境では、**本体のBEEP音でBGMを演奏する**こともできました。[※8](https://tk-nz.game.coocan.jp/ysmusic/screen/Shot%5FEd%5F98.html?ref=geekjp.com)
今から見ると、単純なBEEP音でRPGのBGMを成立させようという、なかなかの力技です。
さらに同じ英雄伝説シリーズでも、1996年のPC-9801版『英雄伝説IV 朱紅い雫』では、**MIDI、FM音源、BEEP**という複数の再生環境が用意されていました。[※9](https://tk-nz.game.coocan.jp/ysmusic/screen/Shot%5FEdIV%5F98.html?ref=geekjp.com)

****図:PC-9801版『英雄伝説IV 朱紅い雫』。**ここで扱っているのは、このPC-98版でMIDI・FM音源・BEEPという異なる再生環境を選べた時代の例です。同じゲーム画面を見ていても、ユーザーの音源環境によって聞こえるBGMは異なりました。画像引用:[4Gamer.net / D4エンタープライズ発表資料](https://www.4gamer.net/games/008/G000896/20181225059/?ref=geekjp.com)。© Nihon Falcom Corporation. All rights reserved. / © D4Enterprise Co.,Ltd.
つまり当時のPCゲームでは、
> **BEEPでも何とか鳴らす → FM音源ならもっと豊かに鳴る → MIDI音源があればさらに豪華に鳴る**
というように、ユーザーが持っているハードウェアによって、同じ「ゲーム音楽」という体験にかなり大きな差がありました。
MIDIは、こうした**「音を作るハードウェアをユーザー側で選べるPC文化」**の中で、とても魅力的な選択肢になっていったのです。
ただし、この柔軟さは「どのMIDI音源でも必ず同じように鳴る」という意味ではありません。音源の世代や互換性によって、音色や一部パートの鳴り方が変わることもありました。
---
## 同じMIDIなのに、音が違う
同じ `.mid` ファイルを別のパソコンや別のMIDI音源で鳴らすと、音がかなり違うことがあります。
理由は単純です。
**ファイルの中に完成した音が入っていないからです。**
```text
同じ演奏データ
│
├─→ 音源A → 音A
│
├─→ 音源B → 音B
│
└─→ 音源C → 音C
```
例えば「ピアノでこの音を鳴らす」という指示は同じでも、
- どんなピアノ音を持っているか
- どのような方法で音色を作るか
- 同時に何音鳴らせるか
- リバーブやコーラスをどう処理するか
は、MIDI音源によって違います。
そして、この違いは当時のゲームユーザーにとって**欠点だけではありませんでした。**
むしろ、大きな楽しみの一つになります。
---
## 音源を買い替えると、同じゲームのBGMまで豪華になった
安価な音源しか持っていなくても、ゲームは遊べます。
でも、より高性能なMIDI音源を購入すると、**ゲームそのものは同じなのに、BGMがぐっと豪華になる**ことがありました。
現在のPCゲームで、グラフィックボードを強化すると映像が豪華になる感覚に少し似ています。
> **音源をアップグレードすると、ゲームの「音」もアップグレードされる。**
そんな楽しみ方ができた時代です。
1987年にはRolandの**MT-32**が登場しました。
さらに1991年には**SC-55 Sound Canvas**が登場し、Sound CanvasシリーズはPCのDTMやゲームでもよく知られる存在になります。
Yamahaからも、後にMUシリーズなどのMIDI音源が登場しました。
1990年代のPCゲームでは、ゲームの設定画面に、
```text
FM音源
MT-32
SC-55
General MIDI
...
```
といった選択肢が並び、**ユーザーが自分の持っている音源を選ぶ**ことも珍しくありませんでした。
ゲームのBGMをよりよい音で聞くために、外部MIDI音源を買う。
これも当時のPCゲーム文化の一部だったのです。
---
## でも、音源によって音が変わりすぎるのは困る
ユーザー側から見れば楽しい「音源による違い」ですが、ゲームメーカーから見ると問題もあります。
作曲者が、
> 「ここでは、このピアノとストリングスを、このバランスで聞いてほしい」
と思っていても、ユーザーの持っているMIDI音源が違えば、同じようには鳴らないことがあります。
- ピアノの音色が違う
- 音量バランスが違う
- エフェクトが違う
- 同時発音数が違う
- 同じ音色番号でも想定した楽器が出ない
しかも問題は「音質が違う」だけではありません。
ゲーム側で選んだMIDI音源と、実際につながっている音源や設定が合っていなければ、**BGMが鳴らない、一部のパートが聞こえない、まるで違う楽器で演奏される**といったことも起こりえます。
> **「ゲームは動いている。でもBGMが鳴らないと、なんかゲームとして成り立ってないな……」**
という状態になることもありました。
当時は、MIDIインターフェースの接続、使用する音源の選択、音源側のモードや初期化などまで含めて、ユーザーがサウンド環境を整える必要があったのです。
これでは、せっかく曲を作っても再生結果を揃えにくい。
> **いろいろな音源で鳴らせる柔軟さ**
> と
> **どの環境でも同じ音になるとは限らない不確実さ**
は、MIDIの表裏一体の特徴でした。
---
## そこでGeneral MIDIが登場する
この問題を減らすために整備されたのが **General MIDI(GM)** です。
[MIDI AssociationのGeneral MIDI資料](https://midi.org/general-midi?ref=geekjp.com)では、異なるGM対応機器でも、共通の音色セットや基本的な演奏環境を使えるようにするための規格として説明されています。
例えば、
- 楽器音色の並びを共通化する
- ドラム音の割り当てを共通化する
- 16 MIDIチャンネルを前提にする
- チャンネル10をリズムに使う
といったルールがあります。
これによって、少なくとも、
> 「ピアノを指定したのに、別の音源では全然違う楽器が鳴る」
といった問題を減らすことができます。
ただしGMは、**すべての音源を同じ音にする規格ではありません。**
「ピアノを鳴らす」という役割は揃っても、そのピアノ自体の音質や雰囲気は音源ごとに違います。
---
## GMからGS・XGへ
MIDI音源が高性能になると、GMの基本的な共通仕様だけでは足りない表現も増えていきました。
そこで各社は、GMとの互換性を意識しながら独自の拡張を行います。
### Roland GS
Rolandの**GS**は、GMをベースに音色や制御機能を拡張した仕様です。
[Rolandの社史](https://www.roland.com/jp/company/history/?ref=geekjp.com)では、1991年の**SC-55 Sound Canvas**をGSフォーマット第1号機としています。
Sound Canvasシリーズは、SC-55からSC-88、SC-88Proなどへ発展し、音色数や同時発音数も増えていきました。
### Yamaha XG
Yamahaは1994年に**XGフォーマット**を発表しました。
[YamahaのMUシリーズ史](https://jp.yamaha.com/products/contents/music%5Fproduction/synth%5F50th/anecdotes/008.html?ref=geekjp.com)によれば、XGはGMを拡張し、音色だけでなくエフェクトなどの詳細なパラメータまで含めて、より豊かな表現を狙った仕様です。
最初のXG対応音源が**MU80**でした。
### KORGなどのGM対応音源
KORGなどからもGM対応のMIDI音源が販売されました。
例えば**KORG 05R/W**では、KORG独自のAI²音源を使いながら、GMデータを再生できます。※13
ここで大切なのは、
> **GM・GS・XGは、MIDIを使って演奏するときの互換性や表現を広げるための規格**
であり、
> **LA音源、PCM音源、AI²などは、実際にどうやって音を作るかという音源方式**
だということです。
「MIDIの種類」と「音を作る方式」は、同じ分類ではありません。
---
## MIDI規格の上に、いろいろな音源が乗っていた
ここまでの関係を整理すると、MIDI、SMF、GM・GS・XG、音源方式は、それぞれ別の役割を持っていることが分かります。
| 分類 | 主な例 | 何を決めるものか |
| --------------- | --------------------- | -------------------------- |
| **演奏情報の通信規格** | MIDI | 音符や音色変更などの演奏情報を、機器間でどう伝えるか |
| **演奏情報のファイル形式** | SMF(.mid) | MIDIの演奏情報を、時間情報とともにどう保存するか |
| **互換性・拡張仕様** | GM / GS / XG | 音色の並びや制御方法などを、音源間でどうそろえるか |
| **実際の音源方式** | LA / PCM / AWM2 / AI² | 音源が実際の音をどのような方式で作るか |
例えば、機種と音源方式・規格の関係は次のようになります。
```text
Roland MT-32 / CM-32L → LA音源
Roland SCシリーズ → PCM系音源 + GS
Yamaha MUシリーズ → AWM2音源 + XG
KORG 05R/W → AI²音源 + GM
```
このように、**曲の演奏情報と、実際に音を作る装置は別々に発展**できました。
より高性能な音源へ交換すれば、同じ演奏データをさらに豊かな音で聞けます。しかし同時に、制作者がすべてのユーザーへ同じ音を保証しにくいという問題も生まれました。
---
## 日本のゲームでは、どんなMIDI音源が使われたのか
では実際に、日本のゲームではMIDI音源がどのように使われていたのでしょうか。
ここでは、当時の流れが分かりやすい作品を中心に、代表例を挙げます。網羅表ではありません。
また「対応」といっても、
- 特定の外部MIDI音源を選択できる
- 特定規格向けのデータを持つ
- MIDI版を制作上の基準としている
など、作品によって意味は異なります。
表の最初に挙げる2作品はX68000用です。そこで、その前提となるX68000のMIDI環境を先に確認しておきましょう。
### X68000では、外部MIDI音源の接続が前提だった
X68000は、FM音源とADPCM音源を本体に内蔵していましたが、MIDI音源は内蔵していませんでした。
そのため、X68000でMIDI対応をうたうゲームは、MIDIインターフェースを介してMT-32やSC-55などの**外部MIDI音源を接続して鳴らすのが基本**でした。
X68000版『出たな!!ツインビー』も、その一例です。MT-32 / SC-55などの外部MIDI音源に対応し、ユーザーは所有する音源に合わせてBGMの再生環境を選べました。[※1](https://www.vogonswiki.com/index.php/List%5Fof%5FMT-32-compatible%5Fcomputer%5Fgames?ref=geekjp.com)
| 年 | ゲーム・開発元 | 機種 | 音源・規格 | 対応内容 |
| ---- | ----------------------------------- | ------- | ------------------------ | ----------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 1991 | 『出たな!!ツインビー』(KONAMI) | X68000 | MT-32 / SC-55 | MT-32 / SC-55を外部接続して利用 [※1](https://www.vogonswiki.com/index.php/List%5Fof%5FMT-32-compatible%5Fcomputer%5Fgames?ref=geekjp.com) |
| 1992 | 『グラディウスII\-GOFERの野望-』(KONAMI) | X68000 | MT-32 / SC-55 | FM版、SC-55\[MIDI\]版、MT-32\[MIDI\]+FM音源ミックス版が存在 [※2](https://d4e.co.jp/20160108/2069?ref=geekjp.com) |
| 1996 | 『英雄伝説IV朱紅い雫』(日本ファルコム) | PC-98 | MIDI / FM / BEEP /SC-88系 | MIDI・FM音源・BEEPに対応。オリジナルMIDI音源を発展させた『MIDIスペシャル』や、SC-88版MIDIデータ集も展開[※3](https://www.falcom.co.jp/music-data/kica1186-7?ref=geekjp.com)・[※4](https://www.vector.co.jp/vpack/browse/person/an011597.html?ref=geekjp.com)・[※9](https://tk-nz.game.coocan.jp/ysmusic/screen/Shot%5FEdIV%5F98.html?ref=geekjp.com) |
| 1996 | 『雫』(Leaf) | PC-98 | MIDI / GS系 | 起動時にMIDI音源・FM音源・音源なしを選択。SC-55 / SC-88系GS音源を推奨し、まずMIDIで曲を仕上げてからFM音源版へ落としたとの証言がある [※5](https://www.famitsu.com/news/202310/29322123.html?ref=geekjp.com) |
| 1996 | 『痕』(Leaf) | PC-98 | MIDI / GS系 | 『雫』と同じLeafのPC-98期に、MIDI版とFM音源版を併用した代表例 [※5](https://www.famitsu.com/news/202310/29322123.html?ref=geekjp.com) |
| 1998 | 『Final Fantasy VII』Windows版(Square) | Windows | General MIDI /Yamaha XG | XG MIDI Dataを選択でき、XG対応サウンドカードに対応。Yamaha S-YXG70もゲームCDから導入できた[※6](https://support.na.square-enix.com/faqarticle.php?id=444&kid=54190&sc=0&ref=geekjp.com)・[※7](https://ascii.jp/elem/000/000/311/311463/?ref=geekjp.com) |
こうして見ると、MIDI対応は単なる「BGMのファイル形式」の問題ではなかったことが分かります。
『出たな!!ツインビー』や『グラディウスII』では、**ユーザーが所有する外部MIDI音源そのものをゲームのサウンド環境として選択**していました。
Embedded iFrame**映像:X68000実機で動作する『グラディウスII -GOFERの野望-』。**投稿者がX68000実機でのキャプチャテストとして公開している映像を、YouTubeの埋め込み機能で掲載しています。動画から静止画を抜き出して転載しているものではありません。なお、X68000版にFM音源版、SC-55[MIDI]版、MT-32[MIDI]+FM音源ミックス版が存在したことの根拠は、この動画ではなくD4エンタープライズの公式資料([※2](https://d4e.co.jp/20160108/2069?ref=geekjp.com))によります。『グラディウスII -GOFERの野望-』© KONAMI
LeafのPC-98作品では、後年の取材で、まずMIDI版を完成させ、その後FM音源向けへ落とし込むという制作工程だったことも語られています。
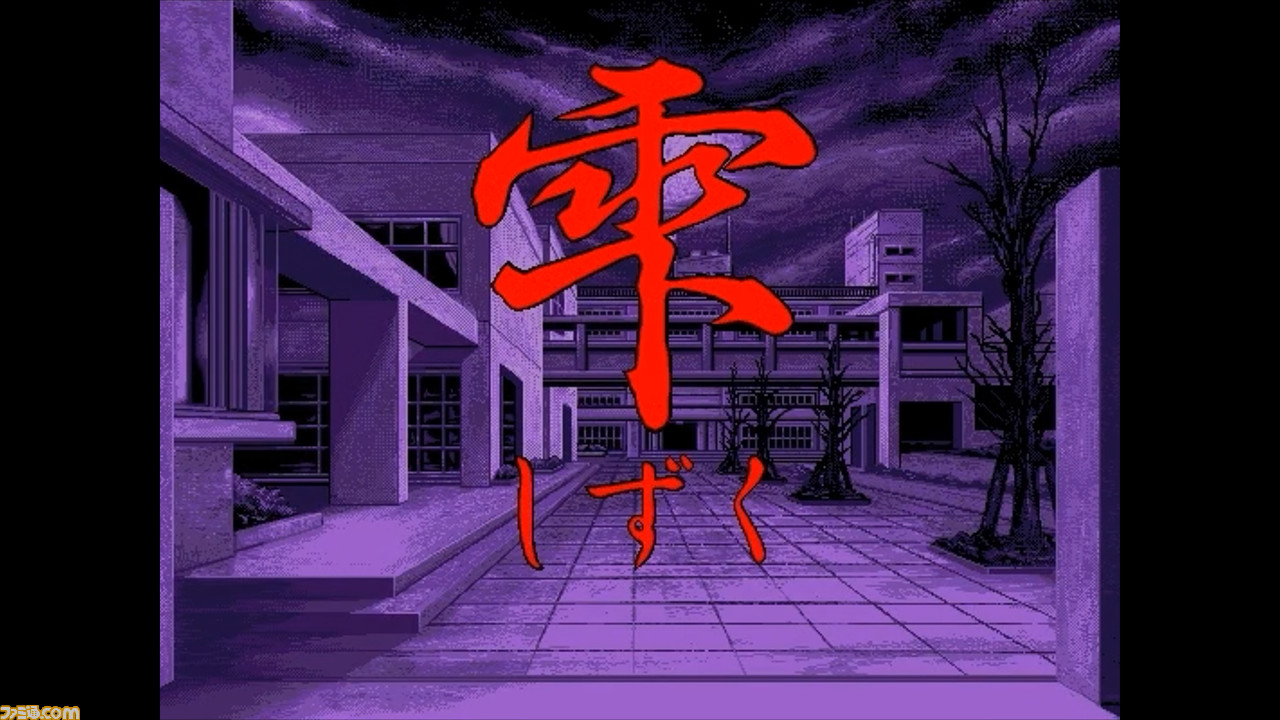
****図:1996年のPC-9801版『雫』。**ファミ通の同記事によれば、このタイトル画面が表示されるよりも前に「MIDI音源/FM音源/音源なし」の選択が行われました。つまり音源選択は、ゲームを始めてから変更する付加機能ではなく、起動時の基本設定として組み込まれていました。画像引用:[ファミ通.com「『雫』『痕』、そして『ToHeart』。ビジュアルノベルの誕生と繚乱」](https://www.famitsu.com/news/202310/29322123.html?ref=geekjp.com)。© AQUAPLUS
つまりMIDIは、単なる豪華版として後から付け足すものではなく、**作曲時の基準環境**になる場合もありました。
そして1998年のWindows版『Final Fantasy VII』では、**XG MIDI Data**が用意され、YamahaのXG対応環境がゲーム側から明確に意識されています。
ハードウェアMIDI音源だけでなく、S-YXG70のようなソフトウェアシンセサイザーも使われるようになり、MIDI音源のあり方そのものも変わり始めていました。
1990年代には、
> **どのMIDI音源でゲームを鳴らすかをユーザーが選ぶ**
こと自体が、PCゲームのサウンド環境の一部だったのです。
そして、ゲームやその環境をそろえたいという**コレクター心や、購入心、所有欲**のようなものまで満たしてくれる、夢のある世界でもありました。
「このゲームなら、この音源で鳴らしてみたい」「せっかくなら、もう少しいい音源がほしい」と、ゲームだけでなく周辺の機材まで少しずつそろえていく。新しい音源を手に入れれば、すでに持っているゲームの音楽が、それまでとはまた違って聞こえる。
今から振り返ると、不便なところも多かった時代です。でも、**ゲームと一緒に環境そのものをそろえていく楽しさ**があり、そういう意味では、なかなか夢のある世界ではあったと思います。
---
## 第1回のPSG・FM音源とは何が違う?
ここで第1回との関係を整理しておきましょう。
| 名前 | 何の話? |
| -------------- | ------------------- |
| **PSG** | 矩形波やノイズなどを使って音を作る方法 |
| **波形メモリ音源** | 短い波形を記憶して音を作る方法 |
| **FM音源** | 波形を変調して複雑な音色を作る方法 |
| **PCM/サンプル音源** | 記録した波形を再生する方法 |
| **MIDI** | 何を、いつ、どう演奏するかを伝える方法 |
つまり、**MIDIとFM音源は競合するものではありません。**
MIDIでFM音源を鳴らすこともできますし、PCMを使ったMIDI音源を鳴らすこともできます。
```text
MIDIによる演奏情報
│
├─→ FM音源
│
├─→ PCM音源
│
└─→ 外部シンセサイザー
```
ゲームの音楽で重要だったのは、**演奏情報と、実際に音を作る装置を分けられたこと**です。
---
## 余談:MMLという方法もあった
ここまで見てきたように、MIDIは完成した音声を送るのではなく、**演奏情報を音源へ渡して、音源に演奏させる仕組み**です。
ただし、同じように演奏情報から音源を鳴らす方法は、MIDIだけではありませんでした。
ゲームやパソコンの音楽では、\*\*MML(Music Macro Language)\*\*という、演奏内容を文字で記述する方法も使われてきました。
### MMLは、音源の種類を決めるものではない
SMFは、時間情報を付けたMIDIメッセージを保存するための標準ファイル形式です。つまり、SMFはMIDIを使って演奏することを前提にしています。
一方、MMLはMIDIのような通信規格でも、特定の音源方式でもありません。
MMLが表しているのは、
> **どの音を、どの長さで、どの順番に鳴らすか**
という演奏内容です。
その文字列を、機種やゲームに用意された処理系が読み取り、PSG音源、FM音源、ファミコンの内蔵音源、あるいはMIDI音源など、その環境で使う音源向けの演奏情報へ変換します。
そのため、**MMLという考え方自体は、特定の音源に縛られていません。**
ただし、実際の書式や使える命令は、機種や処理系、対象となる音源によって異なります。
### MMLは、文字を演奏情報へ変換する
MMLでは、音名や音の長さ、テンポなどを文字で並べて、演奏内容を書いていきます。
例えば、多くのMMLでは、
- `C D E F G A B`:音の高さ
- `R`:休符
- `T`:テンポ
- `O`:オクターブ
- `L`:音の長さ
といった文字や命令を使います。
処理系は、この文字列を順番に読み取り、実際の音源ドライバが扱える演奏情報へ変換します。
身近なところでは、**ファミリーベーシックでもMMLが使われていました。**
`PLAY` 文にMMLの文字列を渡すことで、ファミコンの音源を使って音楽を演奏できます。
例えば、
```basic
PLAY "CDEFG"
```
と書けば、処理系が文字列を解釈し、ファミコンの音源でド・レ・ミ・ファ・ソと演奏します。
ちなみに、**僕が初めて触れたプログラミング環境もファミリーベーシックでした。**
振り返ってみると、僕にとっては「プログラムを書いてコンピュータから音を鳴らす」という体験の入り口に、すでにMMLがあったことになります。
整理すると、
> **MMLは、人が文字で書く演奏記述**
> **SMFは、MIDIの演奏情報を保存する標準ファイル**
です。
どちらも録音済みの音声そのものではなく、最終的には音源を鳴らすための情報ですが、役割も形式も異なります。
ここでは、この程度の違いが分かれば十分です。
---
## まとめ:MIDIの全盛期は、なぜ長く続かなかったのか
ここまで見ると、MIDIはゲームにとって非常に都合のよい仕組みに見えます。
実際、容量の小さかった時代には、
> **演奏データだけを持ち、音は音源に作らせる**
という方法は非常に合理的でした。
> この時代のDTMパッケージについては、ローランド公式サイトにも当時を振り返る資料が残されています。
>
> - [「ミュージくん」発表時のニュースリリース(ローランド公式)](https://www.roland.com/jp/news/0874/?ref=geekjp.com)
> - [「ミュージ郎の思い出」(ローランド公式)](https://www.roland.com/jp/promos/gakuya/backnumber/bn%5F20180906/?ref=geekjp.com)
しかし1990年代、ゲーム機やPCの環境は急速に変わります。
- CD-ROMで大容量のデータを扱えるようになる
- RAMが増える
- PCM音源の性能が上がる
- 録音した楽器や声を扱いやすくなる
- 長い音声をストレージから再生できるようになる
すると、MIDI最大の利点だった\*\*「データが小さい」ことの重要性が少しずつ下がっていきます。\*\*
さらに、ここまでMIDIの魅力として見てきた、
> **音源を変えると同じゲームでも音が変わる**
という特徴も、ゲームメーカー側から見れば、
> **作曲者が完成させた音を、すべてのユーザーへ同じように届けられない**
という弱点になります。
ユーザーには楽しかった「音源による違い」が、時代が進むと制作側には不都合になっていったのです。
ただし、ここからいきなり「全部録音したBGM」へ切り替わったわけではありません。
1990年代には、
> **短いPCMサンプル + 演奏シーケンス**
という、MIDI的な考え方とサンプリング音源を組み合わせた方式も広く使われました。
そして、CD-ROM、大容量メモリ、PCM、圧縮音声、ストリーミングが普及すると、ゲーム音楽の作り方はさらに大きく変わっていきます。
次回は、
- PCMとは何か
- サンプリングとは何か
- CD-ROMで何が変わったのか
- 『Final Fantasy VII』ではどう音楽を鳴らしていたのか
- 『Unreal』のTracker音楽とは何だったのか
- なぜゲーム内でMIDIを直接再生する用途が急速に減っていったのか
を見ていきます。
> **前回:** [← ゲームの音はどう作られていた? ― 専用回路・PSG・FM音源の時代](https://www.geekjp.com/game-sound-history-psg-fm/)
>
> **次回:** [MIDIはなぜゲームから消えた? ― PCM・ストリーミングと現代ゲームサウンド →](https://www.geekjp.com/game-sound-history-pcm-streaming/)
---
## 参考資料
### 本文中の注記・出典
**※1 VOGONS Wiki「List of MT-32-compatible computer games」**
X68000版『出たな!!ツインビー』がMT-32 / SC-55対応作品として整理されている。技術コミュニティによる二次資料のため、ゲーム画面やマニュアル画像の転載元としては使用しない。
[資料を見る](https://www.vogonswiki.com/index.php/List%5Fof%5FMT-32-compatible%5Fcomputer%5Fgames?ref=geekjp.com)
**※2 D4エンタープライズ / ファミ通.com「X68000 グラディウスII GOFERの野望 COMPLETE SOUNDTRACKS」関連資料**
D4エンタープライズ公式告知で、X68000版に**FM音源版、SC-55[MIDI]版、MT-32[MIDI]+FM音源ミックス版**の3バージョンが存在することを確認できる。ファミ通.comの記事でも同内容を確認できる。
[D4エンタープライズ公式告知を見る](https://d4e.co.jp/20160108/2069?ref=geekjp.com)
[ファミ通.comの記事を見る](https://www.famitsu.com/news/201512/18095796.html?ref=geekjp.com)
**※3 日本ファルコム『英雄伝説IV MIDIスペシャル』**
日本ファルコム公式サイト。『朱紅い雫』のオリジナルMIDI音源を発展させたMIDI全曲集として1996年に発売されたことを確認できる。
[公式資料を見る](https://www.falcom.co.jp/music-data/kica1186-7?ref=geekjp.com)
**※4 日本ファルコム MIDIデータ商品一覧(Vector)**
日本ファルコムを作者とする『朱紅い雫・初期版MIDI全曲集(SC-88版)』など、SC-88向けMIDIデータの商品展開を確認できる。
[資料を見る](https://www.vector.co.jp/vpack/browse/person/an011597.html?ref=geekjp.com)
**※5 ファミ通.com「『雫』『痕』、そして『ToHeart』。ビジュアルノベルの誕生と繚乱」**
PC-98版『雫』のMIDI音源/FM音源選択、LeafがSC-55・SC-88などのGS音源を推奨していたこと、さらにアクアプラス取材時の証言として「まずMIDIで仕上げ、FM音源向けに落とす」制作工程が紹介されている。
[記事を見る](https://www.famitsu.com/news/202310/29322123.html?ref=geekjp.com)
**※6 Square Enix Support Center - FINAL FANTASY VII \[PC\] Sound**
Yamaha S-YXG70の導入方法に加え、FFVII ConfigurationにGeneral MIDIとXG MIDI Dataの選択肢があり、XG MIDI DataがXG対応サウンドカード向けであることを確認できる。
[公式サポートを見る](https://support.na.square-enix.com/faqarticle.php?id=444&kid=54190&sc=0&ref=geekjp.com)
**※7 ASCII.jp「PC版『Final Fantasy VII』にヤマハのXGソフトシンセを搭載、欧米で発売へ」**
1998年当時の記事。PC版FFVIIにYamahaのXGフォーマット対応ソフトシンセサイザーS-YXG70が採用されたことを報じている。
[当時の記事を見る](https://ascii.jp/elem/000/000/311/311463/?ref=geekjp.com)
**※8 『ドラゴンスレイヤー英雄伝説』PC-9801版 音楽使用場面資料**
PC-9801版の音源が「FM3音+SSG3音 / BEEP」で、FM音源ボードを搭載していない機種ではBEEP音で音楽を演奏することが記録されている。
[資料を見る](https://tk-nz.game.coocan.jp/ysmusic/screen/Shot%5FEd%5F98.html?ref=geekjp.com)
**※9 『英雄伝説IV 朱紅い雫』PC-9801版 音楽使用場面資料**
PC-9801版がMIDI、FM6音+SSG3音+リズム、FM3音+SSG3音、BEEPという複数の音源環境に対応していたことを確認できる。
[資料を見る](https://tk-nz.game.coocan.jp/ysmusic/screen/Shot%5FEdIV%5F98.html?ref=geekjp.com)
**※10 Roland「MT-32」「CM-32L」公式資料**
Rolandの公式資料で、MT-32が1987年に登場したLA方式の音源モジュールであること、CM-32Lが1989年のLAサウンド・モジュールであることを確認できる。
[MT-32の資料を見る](https://www.roland.com/jp/lp/catalog%5Fmuseum/pdf/NAM-2899.pdf?ref=geekjp.com)
[CM-32L取扱説明書を見る](https://cdn.roland.com/assets/media/pdf/CM-32L%5FOM.pdf?ref=geekjp.com)
**※11 Roland「SOUND Canvas」シリーズ公式資料**
SC-55が1991年、SC-88が1994年に発売されたこと、後継機では音色数や同時発音数が拡張されていったことを確認できる。
[公式資料を見る](https://www.roland.com/jp/company/press%5Freleases/2015/0642/?ref=geekjp.com)
**※12 Yamaha「MU80」展示コレクション**
MU80が1994年に登場した最初のXG対応マルチティンバー音源であり、32パート・64音同時発音のAWM2音源を搭載していたことを確認できる。
[公式資料を見る](https://www.yamaha.com/ja/about/experience/innovation-road/collection/detail/2026/?ref=geekjp.com)
**※13 KORG「05R/W Quick Guide」**
05R/WがAI²音源を搭載し、GM対応音源として使用できることを確認できる。
[公式資料を見る](https://cdn.korg.com/jp/support/download/files/bc85d29a396f6d29f35e200f6a636027.pdf?ref=geekjp.com)
---
### その他の主な参考資料
- [Family mruby project:BASIC と MicroPython ― Family BASIC互換PLAY文とMML](https://family-mruby.github.io/ja/other%5Flanguages/?ref=geekjp.com)
- [The MIDI Association: MIDI 1.0 Core Specifications](https://midi.org/midi-1-0-core-specifications?ref=geekjp.com)
- [The MIDI Association: Standard MIDI Files](https://midi.org/standard-midi-files?ref=geekjp.com)
- [The MIDI Association: General MIDI](https://midi.org/general-midi?ref=geekjp.com)
- [The MIDI Association: About MIDI Part 4 – MIDI Files](https://midi.org/about-midi-part-4midi-files?ref=geekjp.com)
- [Roland:ローランドの歩み](https://www.roland.com/jp/company/history/?ref=geekjp.com)
- [Roland 50th Anniversary:1980年代](https://www.roland.com/au/roland-50th-anniversary/1980s/?ref=geekjp.com)
- [Roland 50th Anniversary:1990年代](https://www.roland.com/jp/roland-50th-anniversary/1990s/?ref=geekjp.com)
- [Yamaha:MUシリーズ ― シンセサイザー50周年](https://jp.yamaha.com/products/contents/music%5Fproduction/synth%5F50th/anecdotes/008.html?ref=geekjp.com)
- [Yamaha:MU80取扱説明書・XG Format Overview](https://data.yamaha.com/files/download/other%5Fassets/8/320948/MU80E1.pdf?ref=geekjp.com)
- [KORG 05R/W Quick Guide](https://cdn.korg.com/jp/support/download/files/bc85d29a396f6d29f35e200f6a636027.pdf?ref=geekjp.com)
### ゲーム音楽とMIDI その1
URL: https://www.geekjp.com/gemuyin-le-tomidi-sono1/
Last updated: 2026-09-13T17:25:04.000Z
# ゲームの音はどう作られていた?
## ― 専用回路・PSG・FM音源の時代
> **ゲーム音源の歴史シリーズ**
>
> 1. **ゲームの音はどう作られていた? ― 専用回路・PSG・FM音源の時代 ← 今ここ**
> 2. [MIDIとは何だったのか? ― ゲーム音楽と演奏データの革命](https://www.geekjp.com/midi-game-music-history/)
> 3. [MIDIはなぜゲームから消えた? ― PCM・ストリーミングと現代ゲームサウンド](https://www.geekjp.com/gemuyin-le-tomidi-sono3/)
昔のゲームの音を「8bitのピコピコ音」と呼ぶことがあります。感覚的にはよく分かる表現なのですが、技術の説明としては少し注意が必要です。
当時のゲーム機が8bit CPUを使っていたことと、音声が8bitで記録されていたことは、同じ意味ではありません。そもそも初期のゲームでは、現在のWAVやMP3のような**録音済みの音声データを再生していない**場合が多かったからです。
では、音声ファイルがないのに、どうやって発射音や爆発音を鳴らし、音楽を演奏していたのでしょう?
この全3回のシリーズでは、ゲームが音を作る方法の変化を、次の順番でたどります。とはいえ、僕がいろんな手段でいろいろなところから集めてきたデータをまとめた研究・調査結果です。すべて正しそうに書いてはいますが、あくまで個人の調査です。
**専用音響回路 → 波形メモリ音源 → PSG → FM音源 → MIDI・シーケンス → PCM → ストリーミング → 現代のインタラクティブオーディオ**
第1回では、MIDIがゲームに広がる前の時代を見ていきます。主役は、電子回路、PSG、そしてFM音源です。
---
## まずはゲーム音源の歴史を一望してみよう
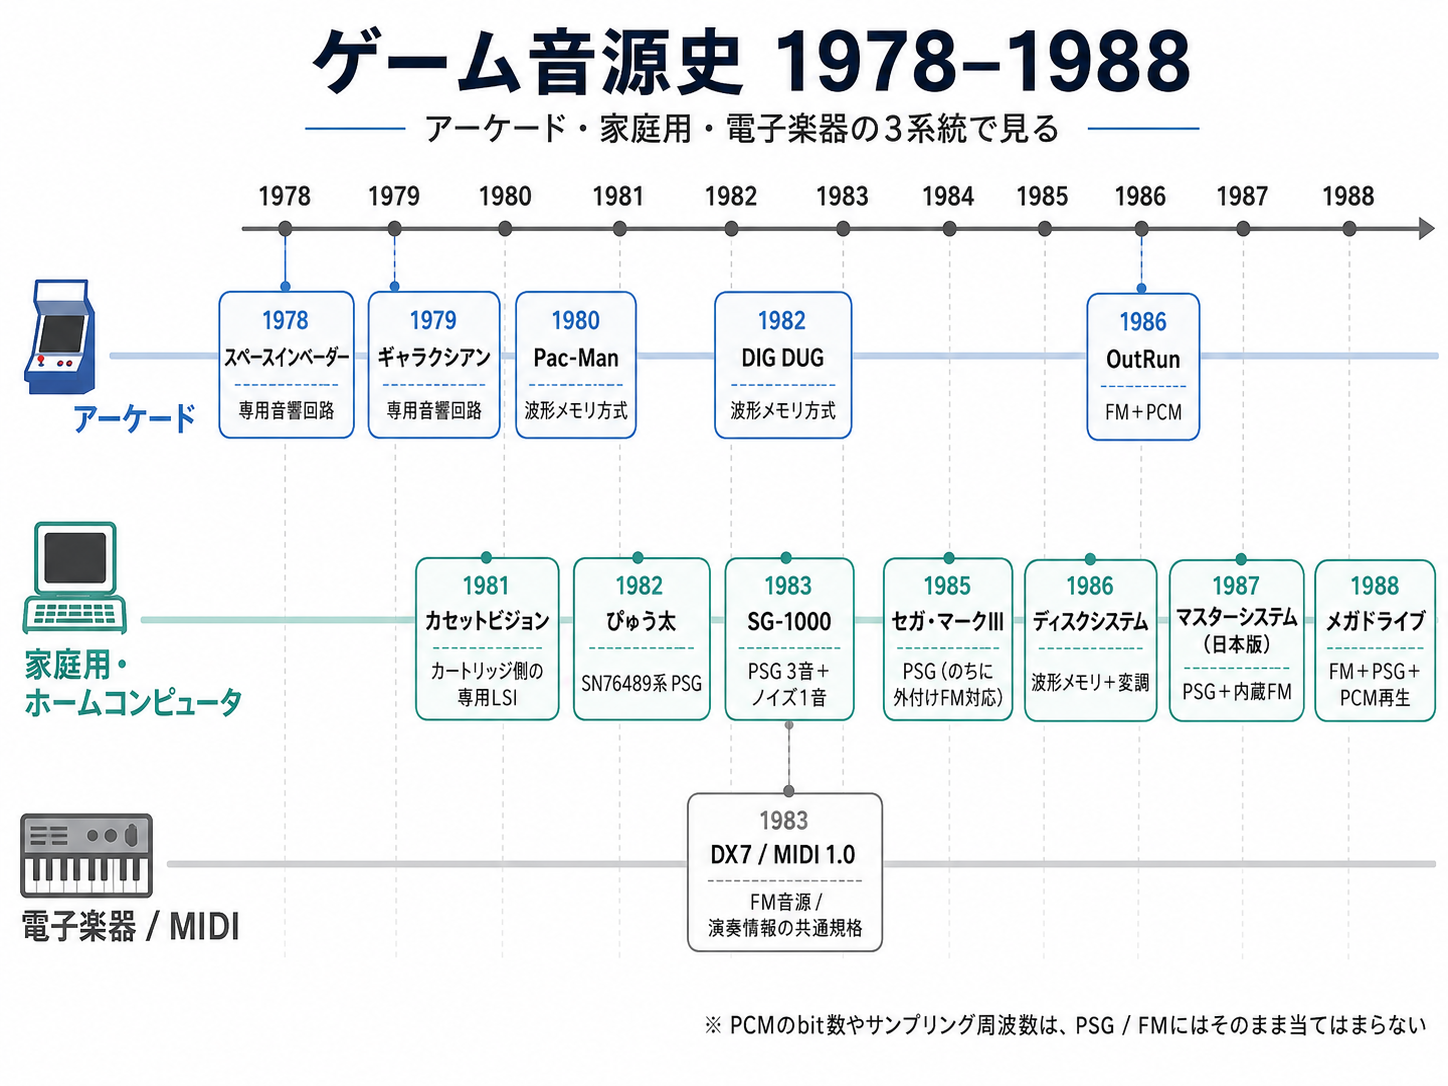
図 ゲーム音楽史
上の年表では、ゲームの音に関係する代表的な出来事を1978年から1988年まで並べました。ここで大切なのは、古い方式が消えて新しい方式へ一斉に入れ替わったわけではない、という点です。
専用回路、PSG、波形メモリ、FM、PCMは、しばらく並行して使われました。現在でも、表現したい音や機器の制約に応じて、これらの考え方は使われています。
| 年 | 代表例 | 分野 | 音を作る方法 | PCM・サンプリング |
| ---- | ------------- | --------- | --------------------- | ----------------------------- |
| 1978 | スペースインベーダー | アーケード | ゲーム専用の音響回路 | 録音PCMではないため該当なし |
| 1979 | ギャラクシアン | アーケード | ゲーム専用の音響回路 | 該当なし |
| 1980 | Pac-Man | アーケード | 3音の波形メモリ方式 | 波形表は4bit録音PCMの量子化bit数とは意味が異なる |
| 1981 | カセットビジョン | 家庭用 | カートリッジ側の専用LSIを中心とした構成 | 該当なし |
| 1982 | DIG DUG | アーケード | 3音の波形メモリ方式 | Pac-Man系と同様 |
| 1982 | ぴゅう太 | ホームコンピュータ | SN76489系矩形波3音+ノイズ | 該当なし |
| 1983 | SG-1000 | 家庭用 | PSG 3音+ノイズ1音 | 該当なし |
| 1983 | DX7/MIDI 1.0 | 電子楽器 | FM音源/演奏情報を交換する規格 | MIDIは音声データではない |
| 1985 | セガ・マークIII | 家庭用 | PSGのちに外付けFM音源へ対応 | 該当なし |
| 1986 | ディスクシステム | 家庭用 | 波形メモリ音源+変調機能 | 6bit値を64個並べた波形表録音PCMとは別物 |
| 1986 | OutRun | アーケード | FM音源+PCM | FMと録音サンプルを併用 |
| 1987 | マスターシステム(日本版) | 家庭用 | PSG+内蔵FM音源 | FM部分は該当なし |
| 1988 | メガドライブ | 家庭用 | FM+PSG+PCM再生機能 | 複数方式を併用 |
表の「該当なし」は、性能が低いという意味ではありません。PSGやFM音源は、録音波形を一定のサンプリング周波数と量子化bit数で保存して再生する方式ではないため、同じ物差しで比べられないという意味です。
---
## スペースインベーダーは、音の回路を鳴らしていた
1978年の『スペースインベーダー』には、敵が近づくにつれて速くなる低い音、発射音、爆発音、UFOの音など、印象に残る効果音があります。
現代の感覚では、ROMの中に「shot.wav」や「explosion.wav」のような音声ファイルが入っていて、必要なときに再生しているように思えるかもしれません。しかし、実際の基板では、CPUからの信号によって**それぞれの効果音を作る専用の電子回路**を動かしていました。
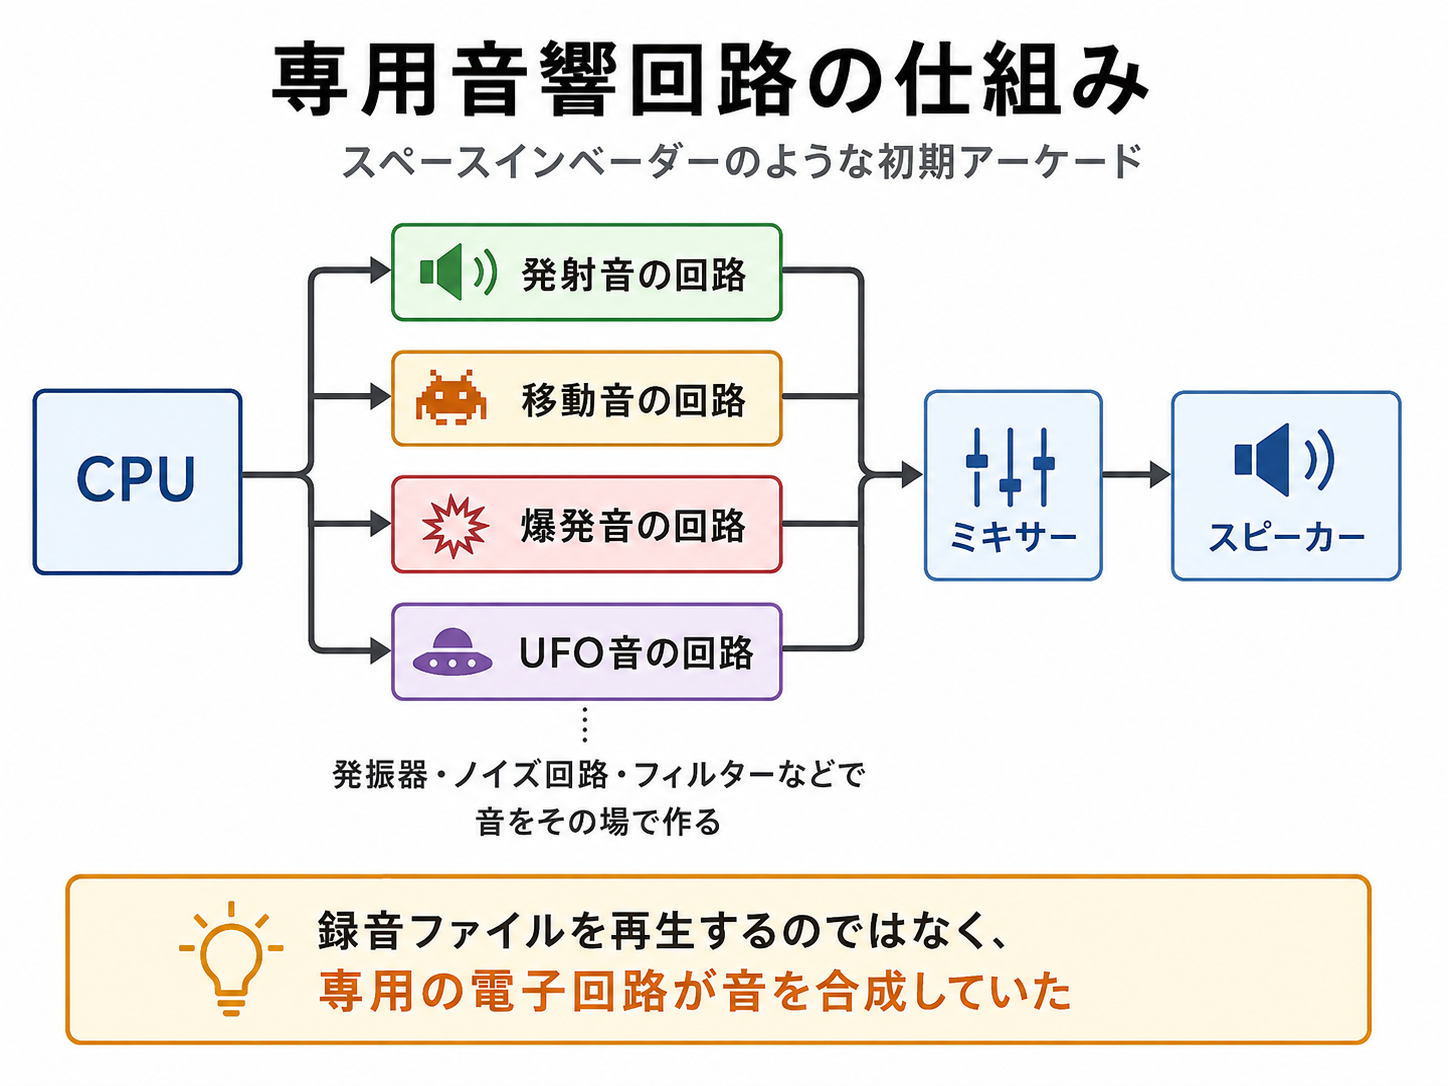
図 専用回路による発音
CPUが行うのは、「今、発射音を鳴らす」「爆発音を鳴らす」といったきっかけを送ることです。実際の波形は、発振器、ノイズ回路、フィルターなどを組み合わせた音響回路が作ります。
つまり、音を録音しておく代わりに、**音が必要になるたびに回路で合成していた**わけです。[MAMEのスペースインベーダー用実装](https://github.com/mamedev/mame/blob/master/src/mame/midw8080/8080bw.cpp?ref=geekjp.com)でも、当時の基板を再現するために、こうした回路を構成する部品や接続をモデル化しています。
翌1979年の『ギャラクシアン』も、専用の回路を組み合わせて音を作る時代のゲームです。ゲームごとに個性的な音を作れる一方、別のゲームを作るたびに音響回路の設計も必要になります。
この頃は、まだ「どんなゲームにも使える汎用の楽器」のようなゲーム音源が確立していませんでした。すべてがフルスクラッチ・専用開発・一品ものでした。
---
## Pac-Manは「短い波形」を楽器として使った
1980年の『Pac-Man』では、音作りの考え方が一歩進みます。
基板上には、音の形を表す小さな数値表が用意されていました。その短い波形を繰り返し読み出し、読み出す速さを変えることで音程を作ります。さらに音量と鳴らすタイミングを変えれば、同じ波形からメロディーを演奏できます。
考え方を単純化すると、次の組み合わせです。少しソフトウェア的になってきましたね。
> **波形 + 音程 + 音量 + 鳴らすタイミング**
『Pac-Man』と『DIG DUG』で使われたナムコの方式は、[MAMEのNamco WSG技術資料](https://github.com/mamedev/mame/blob/master/src/devices/sound/namco.cpp?ref=geekjp.com)では、PROMに波形を持つ**3音のWaveform Sound Generator(WSG)**として整理されています。波形表の各値は4bitですが、これは「4bitで録音したBGMを流している」という意味ではありません。ごく短い一周期分の形を、音色の材料として使っているのです。
専用回路の時代が「この回路は爆発音を作る」という設計だったとすれば、波形メモリ方式は「この音色を、この高さと音量で鳴らす」という、楽器に近い仕組みです。
ゲームのプログラム側には、音程や長さを並べた演奏データを持たせられます。効果音のための回路から、**少ないデータで曲を演奏できる音源**へと進んできました。
---
## 家庭用ゲーム機では、価格も大きな制約だった
アーケード基板は、一つのゲームを動かすための専用ハードウェアです。一方、家庭用ゲーム機では、本体価格を抑えながら複数のゲームを動かさなければなりません。
1981年発売のカセットビジョンは、後世のゲーム機とは少し違う構成でした。本体側にCPUとゲームROMをまとめて置くのではなく、ゲームを動かすための1チップLSIをカートリッジ側に持たせ、本体側は電源、コントローラー、映像・音声の出力などを受け持つ構成でした。
当時エポック社でハードウェア設計に関わった堀江正幸氏は、[CLASSIC VIDEOGAME STATION ODYSSEYのインタビュー](https://www.ne.jp/asahi/cvs/odyssey/creators/horie/7p.html?ref=geekjp.com)で、当時のテレビゲーム用LSIは1チップ化されており、CPUとROMを分離して外部ROMを接続する方式は、技術面でもコスト面でも難しかったと説明しています。[Centre for Computing Historyの収蔵資料](https://www.computinghistory.org.uk/det/60612/Epoch-Cassette-Vision/?ref=geekjp.com)でも、カセットビジョンはCPUをカートリッジ側に持ち、本体が電源・操作系・映像/音声出力を受け持つ独特な構成だったことが紹介されています。
その後の家庭用ゲーム機やホームコンピュータでは、CPUとは別に、複数のゲームから共通して使える音源ICを載せる構成が広がります。1982年の『ぴゅう太』や1983年の『SG-1000』は、その代表例です。
[セガの公式資料](https://www.sega.jp/history/hard/sg1000/index.html?ref=geekjp.com)では、SG-1000のサウンドは**「PSG音源3音+ノイズ1音」**と記載されています。使われたSN76489系の音源は、3系統のトーンと1系統のノイズを持ち、それぞれの周波数と音量をプログラムから設定できます。
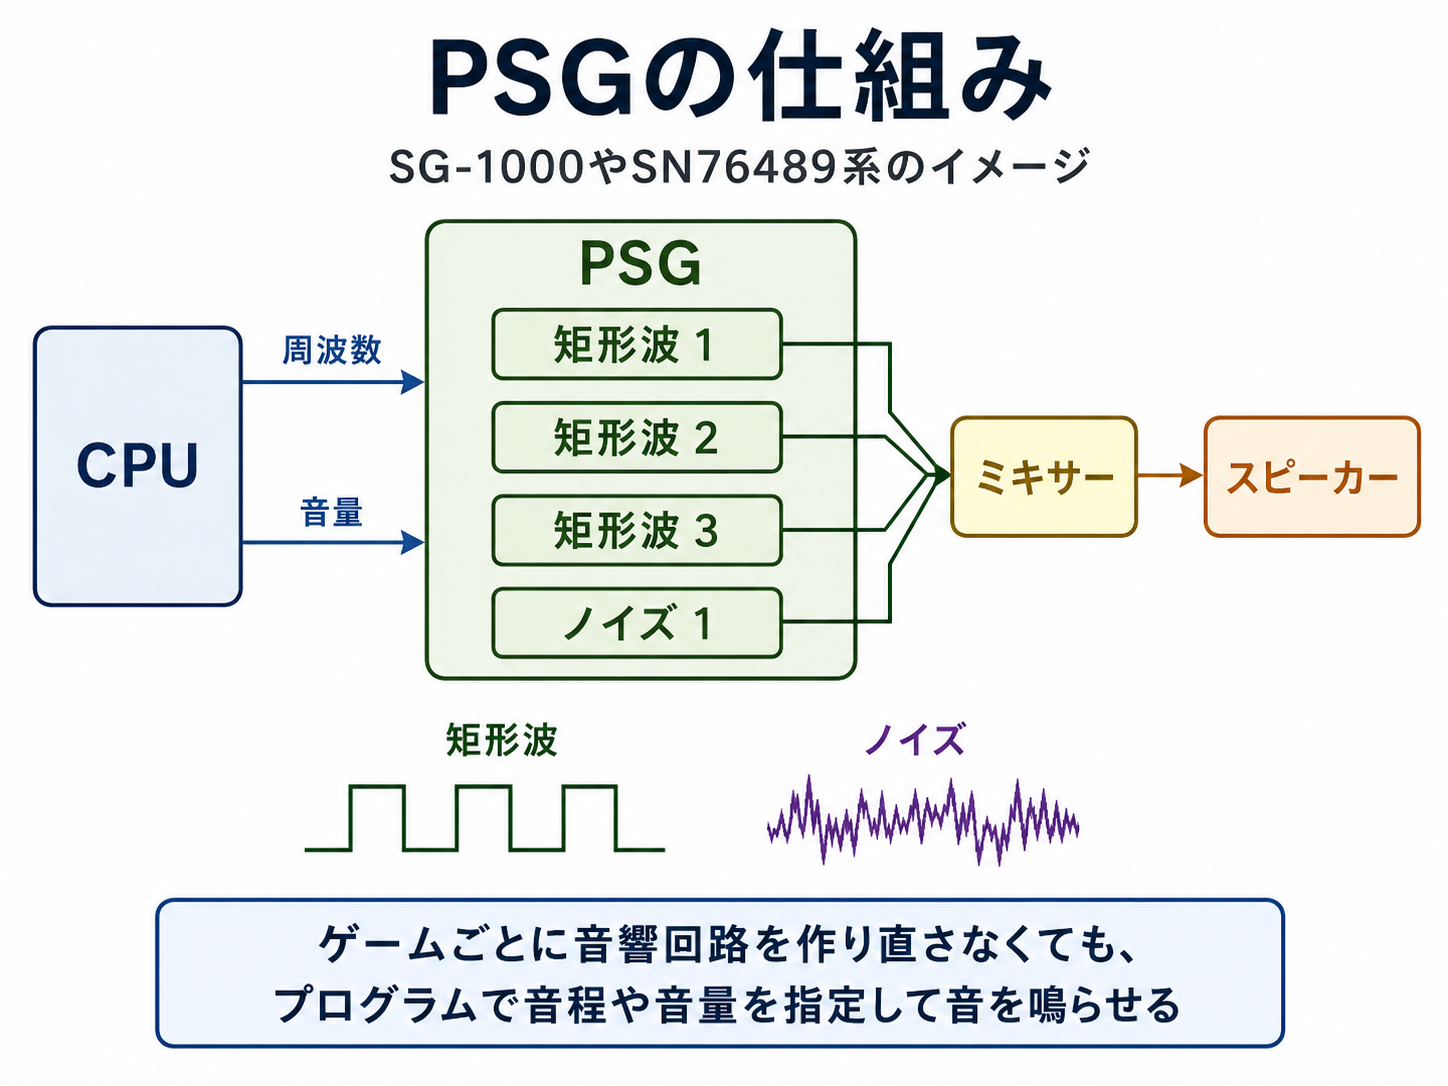
図 PSG音源の仕組み
ゲームごとに音響回路を作り直さなくても、プログラムが音源ICへ数値を書き込めば、音楽や効果音を鳴らせるようになりました。
---
## PSGとは何か
PSGは、Programmable Sound Generatorの略です。名前のとおり、プログラムから制御できる音の発生装置を指します。
ただし、「PSG」という言葉の範囲には少し揺れがあります。狭い意味ではGeneral Instrument社のAY-3-8910とその互換系を指し、広い意味ではSN76489のような、単純な波形とノイズをプログラムで鳴らす音源も含めて呼ばれます。この記事では、当時のメーカー資料での呼び方に合わせ、広い意味で使います。
SG-1000のようなPSGで中心になるのは、次の要素です。
- **矩形波**:電圧の高い状態と低い状態が、四角く切り替わる波形
- **ノイズ**:爆発、風、打楽器などの材料になる不規則な信号
- **周波数**:音の高さを決める値
- **音量**:各音をどれだけ大きく鳴らすか
- **チャンネル**:同時に扱える音の系統
矩形波は構造が単純で、少ない回路で安定して作れます。その代わり、そのまま鳴らすと音色はよく似ます。そこで作曲者やサウンドプログラマーは、高速で音程を切り替えて和音に聞かせたり、音量を細かく変えて余韻を作ったり、ノイズを打楽器として使ったりしました。
「3音しか出せない」ことは単なる弱点ではありません。その制約の中で、ベース、メロディー、伴奏、効果音をどう分けるかが、ゲーム音楽の作り方そのものになったのです。
---
## FM音源は、波を使って別の波を変化させる
PSGより複雑な音色を作る方法として、1980年代に大きな存在感を持ったのがFM音源です。
FM音源では、波形を作る一つ一つの発振器を**オペレータ**と呼びます。単純化すると、一つのオペレータが作る波を、別のオペレータで高速に変化させます。
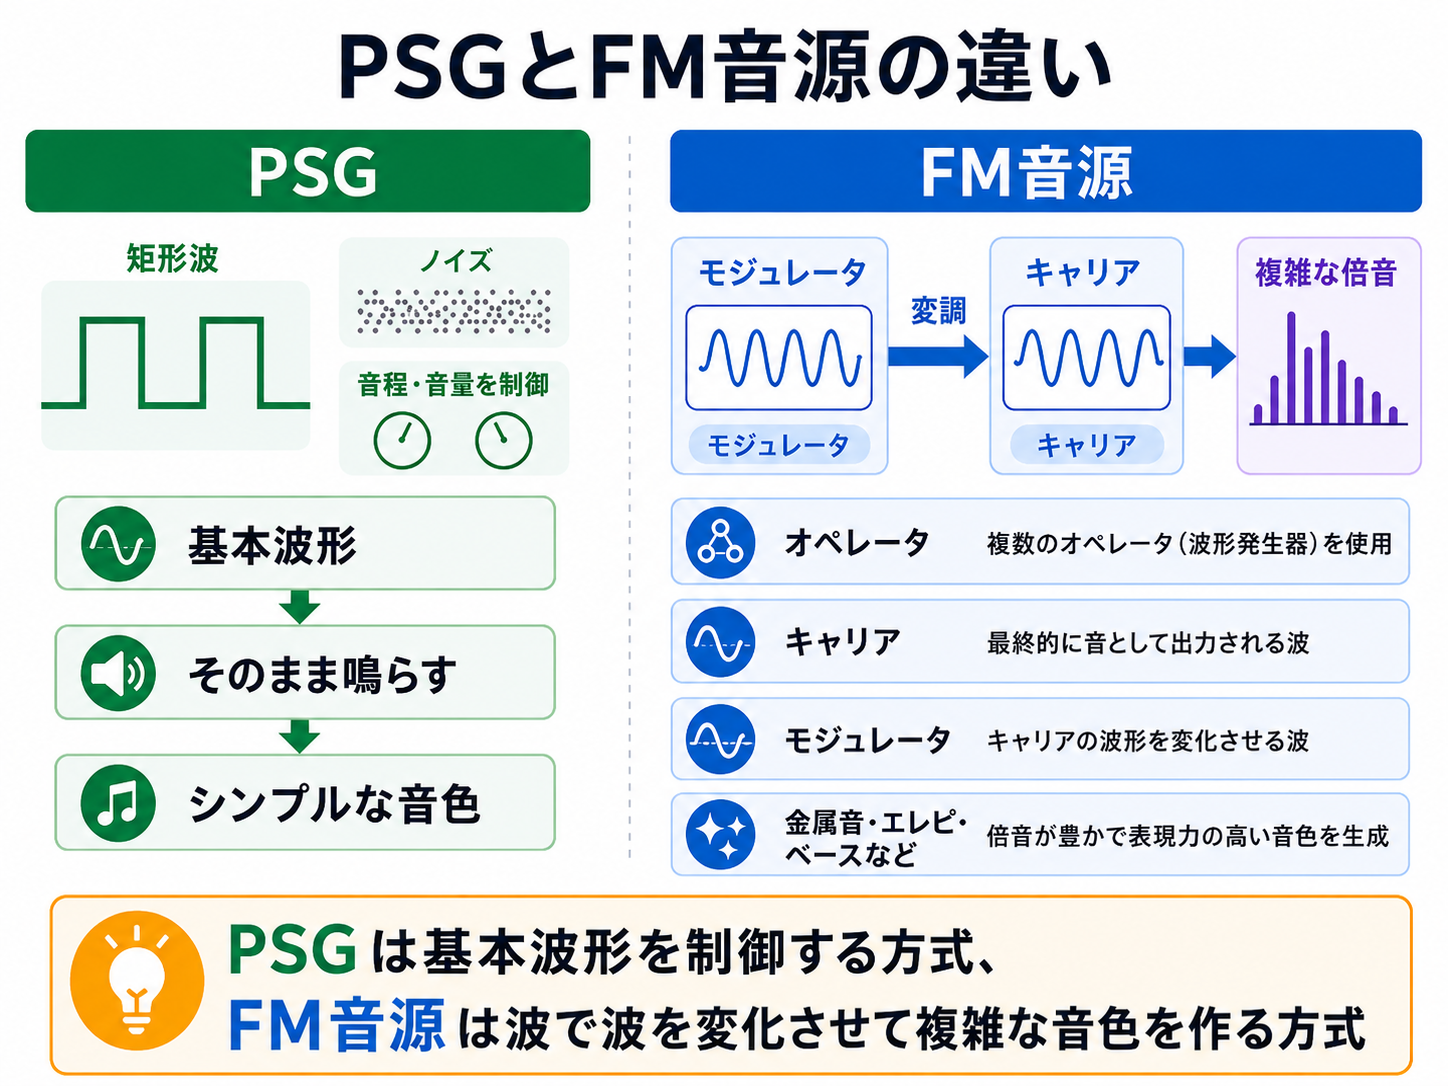
図 PSGとFM音源の違い
- **キャリア**:最終的に音として聞こえる側の波
- **モジュレータ**:キャリアの周波数を変化させる側の波
- **変調の深さ**:どれくらい強く変化させるか
- **周波数比**:二つのオペレータをどんな音程関係にするか
これらを変えると、ベルのような金属音、エレクトリックピアノのような音、ベース、ブラス、打楽器的な音まで作れます。さらに複数のオペレータをどの順番で接続するかによって、音色は大きく変わります。
FM音源も、完成した音声ファイルを保存して再生する方式ではありません。音色を決めるパラメータと演奏情報をもとに、音をその場で計算して作ります。
[ヤマハのFM音源史](https://usa.yamaha.com/products/contents/music%5Fproduction/synth%5F50th/history/chapter002.html?ref=geekjp.com)によると、同社は1981年に最初のFM音源製品を発売し、1983年のDX7でFM音源を広く普及させました。その後、FM音源ICはアーケード基板、パソコン、家庭用ゲーム機でも使われるようになります。
---
## セガのゲーム機で音源の変化を追ってみよう
セガの家庭用ゲーム機を縦に並べると、PSGからFM音源へ進み、さらに複数方式を組み合わせていく流れが見えやすくなります。
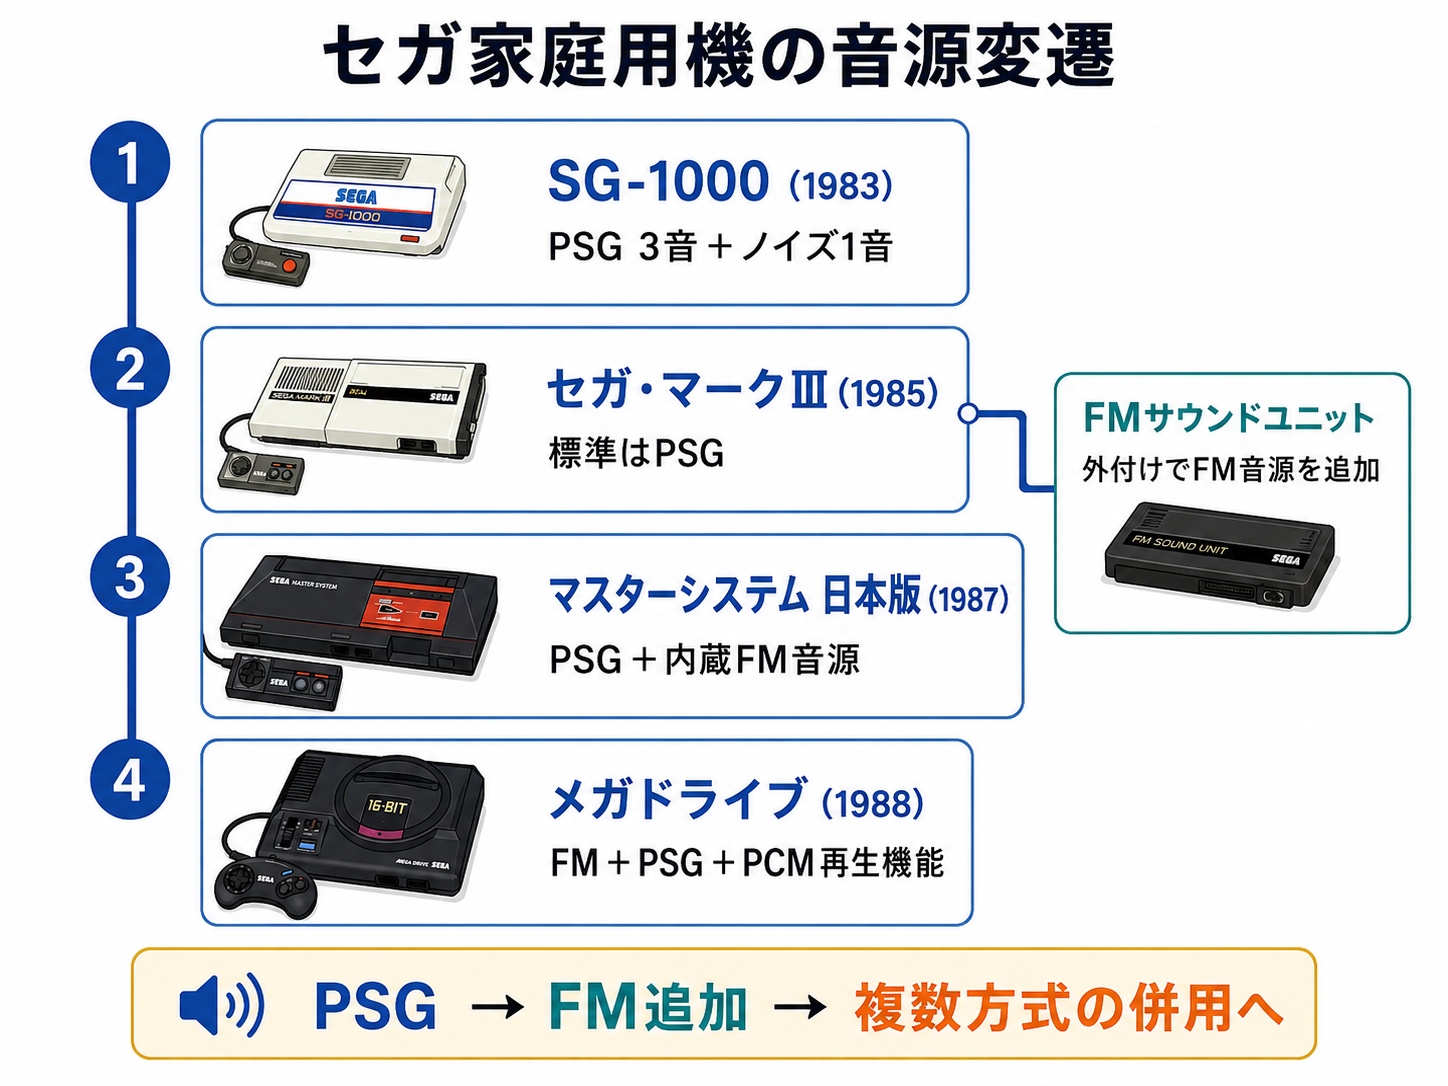
図 セガの家庭用ゲーム機と音源の変遷
### SG-1000:PSG 3音+ノイズ1音
1983年のSG-1000は、3つのトーンと1つのノイズを使うPSGを搭載していました。CPUが周波数や音量を音源へ指定し、音源が波形を作ります。
### セガ・マークIII:標準はPSG、周辺機器でFMを追加
1985年のセガ・マークIIIも、標準音源はPSG 3音+ノイズ1音です。のちに[FMサウンドユニット](https://www.sega.jp/history/hard/segamark3/devices.html?ref=geekjp.com)が発売され、対応ソフトでは標準PSGにFM音源9音を加えて使えるようになりました。
### マスターシステム:日本版はFM音源を本体へ内蔵
1987年に日本で発売された[マスターシステム](https://www.sega.jp/history/hard/mastersystem/index.html?ref=geekjp.com)は、マークIIIにFMサウンドユニットなどの機能を組み込んだ構成でした。外付けだったFM音源が、本体の標準機能になったわけです。
### メガドライブ:FMとPSGを一緒に使う
1988年の[メガドライブ](https://www.sega.jp/history/hard/megadrive/?ref=geekjp.com)は、FM音源とPSGを搭載し、PCMの再生にも対応しました。新しい方式が古い方式を単純に捨てたのではなく、音色の得意分野に応じて一緒に使っています。
アーケードでは、家庭用より早い段階でFMとPCMの併用が進んでいました。たとえば1986年の『OutRun』の基板では、YM2151によるFM音源と、セガのPCM機能が組み合わされています。FMで音色を合成しながら、録音した短い音も使える構成です。
ここからも、ゲーム音源の歴史が一直線の「置き換え」ではなく、**使える音の道具を増やしていく歴史**だったことが分かります。
---
## 任天堂は波形メモリとカートリッジで音を拡張した
同じ時代、任天堂のファミリーコンピュータでも音の拡張が行われました。ただし、セガと同じFM音源へ進んだわけではありません。
1986年のディスクシステムには、ファミコン本体の音源に加え、自由に設定した短い波形を繰り返して鳴らす**波形メモリ音源**が追加されています。さらに、音程を周期的に揺らす変調機能も持っていました。[NESdevの技術資料](https://www.nesdev.org/wiki/FDS%5Faudio?ref=geekjp.com)では、64個の6bit値で波形を作るチャンネルとして整理されています。
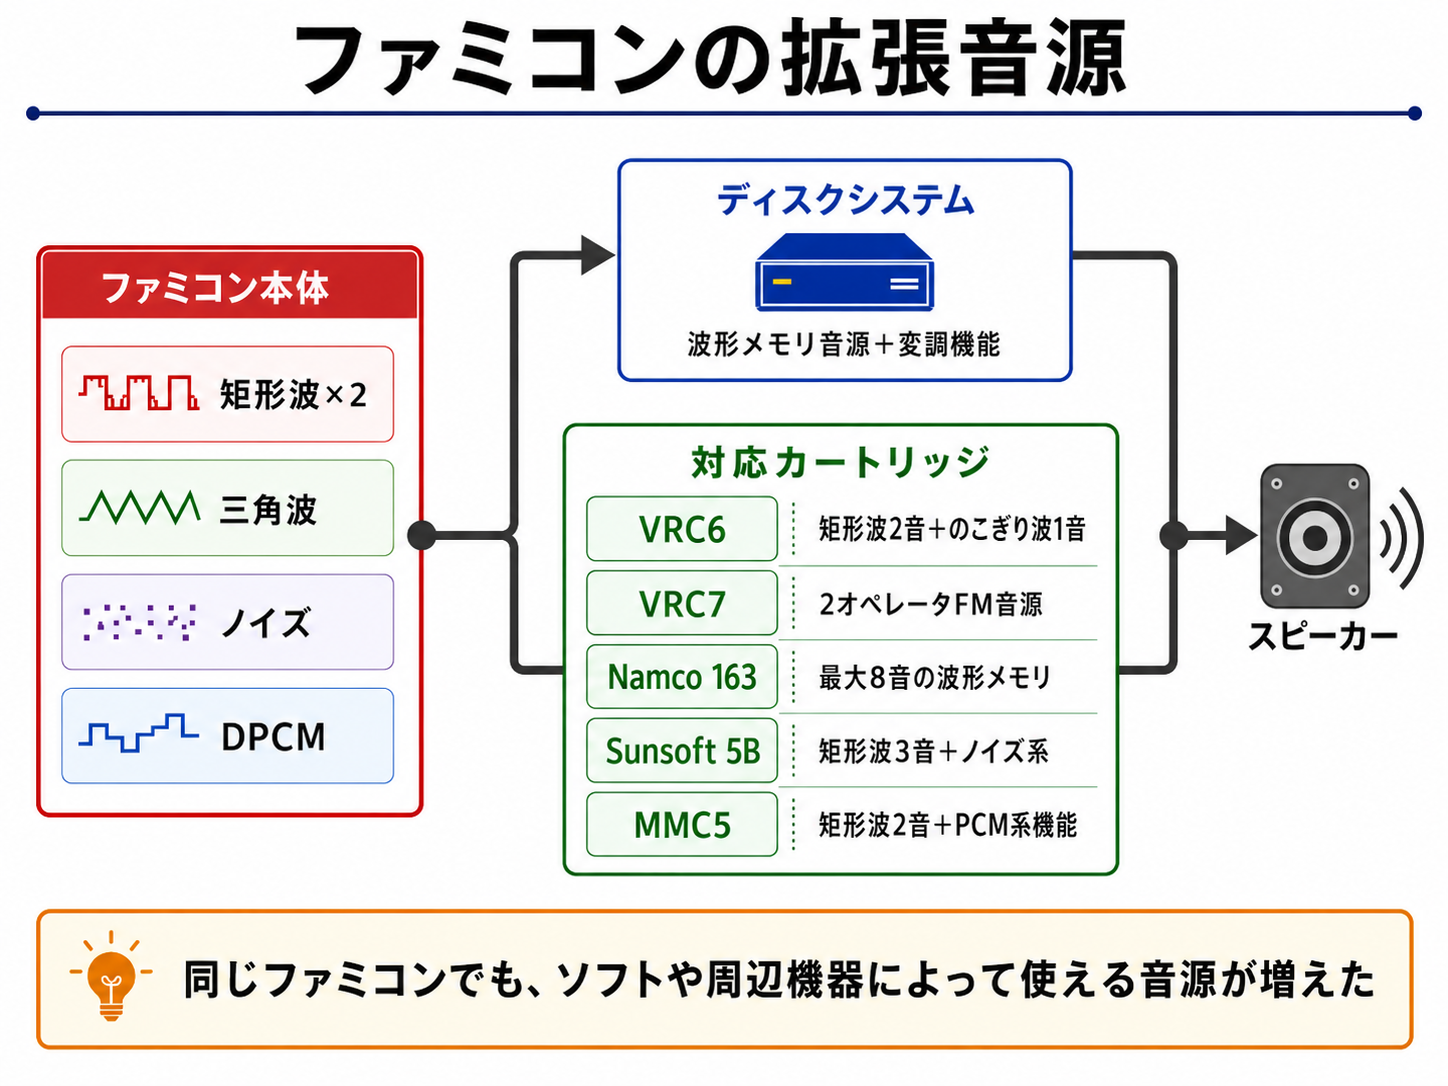
図 ファミコンの音源拡張
ディスクシステムの追加音源を「FM音源」と説明している文章を見かけることがありますが、仕組みは異なります。正確には、**波形メモリ音源+変調機能**です。(僕もディスクシステムでFM音源が拡張されたって思ってました😰)
また、一部のファミコン用カートリッジには、カートリッジそのものに追加音源が搭載されました。
| 拡張音源 | 追加される主な音源機能 | 実際の使用例 |
| -------------- | ------------------ | ------------------------------------------------------- |
| **VRC6** | 矩形波2音+のこぎり波1音 | 『悪魔城伝説』『魍魎戦記MADARA』『エスパードリーム2 新たなる戦い』 |
| **VRC7** | 2オペレータFM音源・6音 | 『ラグランジュポイント』 |
| **Namco 163** | 最大8音の波形メモリ音源 | 『女神転生II』『キングオブキングス』『えりかとさとるの夢冒険』『ローリングサンダー』『ファイナルラップ』など |
| **Sunsoft 5B** | 矩形波3音+ノイズ・エンベロープ機能 | 『ギミック!』 |
| **MMC5** | 矩形波2音+PCM系の出力機能 | 『ジャストブリード』『メタルスレイダーグローリー』『新4人打ちマージャン 役満天国』など |
💡
****※ KONAMIのVRCシリーズすべてが拡張音源を持つわけではありません。**
『がんばれゴエモン!からくり道中』などで使われたVRC1や、VRC2・VRC4は主にROMのバンク切り替えなどを行うチップで、追加音源は持っていません。音源機能を持つVRC6・VRC7とは区別する必要があります。
💡
※ Sunsoft 5B自体はノイズ・エンベロープ機能を持ちますが、『ギミック!』では主に矩形波3音が使用されています。
VRC7は少し特殊です。VRC7を搭載したカートリッジがすべてFM音源を使ったわけではなく、**市販ファミコンソフトでVRC7のFM音源をゲーム音楽に使用した代表例は『ラグランジュポイント』**です。このように、「拡張チップを搭載していること」と「その音源機能を実際に使用していること」は分けて考える必要があります。
すべてのゲームが追加音源を使ったわけではありません。対応する一部のソフトだけが、本体の音源とカートリッジ側の音源を混ぜて鳴らしました。
そのため、**同じファミコンでも、挿すソフトによって使える音源が違う**ことがありました。ゲームソフトが音のハードウェアまで拡張する、面白い設計です。
セガはFM音源で複雑な音色を合成し、任天堂は波形メモリやカートリッジ側の追加回路で音色を広げました。優劣というより、コスト、互換性、発売時期、ゲームの狙いに応じて、異なる方法を選んだと見るのがよいでしょう。
---
## 「何を鳴らすか」と「実際に音を作る装置」が分かれていった
ここまでの流れを、もう一度整理します。
初期の専用音響回路では、CPUが「発射音の回路を動かせ」と合図し、専用回路がその音を作りました。
PSGでは、CPUが「この周波数、この音量で鳴らせ」と数値を送り、PSGが矩形波やノイズを作りました。
FM音源では、CPUやサウンド用プロセッサが「この音色設定で、この音程を鳴らせ」と指示し、FM音源が複雑な波形を合成しました。
つまり1980年代には、次の二つがはっきり分かれてきます。
> **何を、いつ、どのように鳴らすかを決めるデータ**
> **その指示を受けて、実際の音を作る装置**
これは、次回扱うMIDIを理解するための大切な準備になります。
ただし、ここで紹介したゲーム機の制御データを、そのままMIDIと呼ぶことはできません。各機種・各音源のレジスタへ書き込む独自の命令や、ゲーム独自のシーケンスデータです。
一方、電子楽器の世界では、メーカーの違う機器どうしで「どの音を、いつ鳴らすか」をやり取りする必要が高まっていました。そして1983年、演奏情報を交換するための共通規格としてMIDI 1.0が登場します。[MIDI Associationの歴史資料](https://midi.org/midi-history-chapter-6-midi-begins-1981-1983?ref=geekjp.com)には、1983年1月の公開デモと、同年のMIDI 1.0成立までの経緯がまとめられています。
MIDIは音源でも、録音された音声でもありません。では、何を記録し、なぜゲームに向いていたのでしょうか。
次回は、ゲーム音楽の歴史の中央にあるMIDIを詳しく見ていきます。
> [**次回:** MIDIとは何だったのか? ― ゲーム音楽と演奏データの革命 →](https://www.geekjp.com/midi-game-music-history/)
---
## 主な参考資料・参考URL
- [SEGA「SG-1000」ハード概要](https://www.sega.jp/history/hard/sg1000/index.html?ref=geekjp.com)
- [SEGA「セガ・マークIII」関連・周辺機器:FMサウンドユニット](https://www.sega.jp/history/hard/segamark3/devices.html?ref=geekjp.com)
- [SEGA「マスターシステム」ハード概要](https://www.sega.jp/history/hard/mastersystem/index.html?ref=geekjp.com)
- [SEGA「メガドライブ」ハード概要](https://www.sega.jp/history/hard/megadrive/?ref=geekjp.com)
- [Yamaha, FM Tone Generators and the Dawn of Home Music Production](https://usa.yamaha.com/products/contents/music%5Fproduction/synth%5F50th/history/chapter002.html?ref=geekjp.com)
- [MAME source: Namco WSG sound driver](https://github.com/mamedev/mame/blob/master/src/devices/sound/namco.cpp?ref=geekjp.com)
- [MAME source: Pac-Man hardware and sound registers](https://github.com/mamedev/mame/blob/master/src/mame/pacman/pacman.cpp?ref=geekjp.com)
- [MAME source: Space Invaders hardware](https://github.com/mamedev/mame/blob/master/src/mame/midw8080/8080bw.cpp?ref=geekjp.com)
- [MAME source: Sega OutRun hardware](https://github.com/mamedev/mame/blob/master/src/mame/sega/segaorun.cpp?ref=geekjp.com)
- [NESdev Wiki: FDS audio](https://www.nesdev.org/wiki/FDS%5Faudio?ref=geekjp.com)
- [The MIDI Association: MIDI Begins, 1981–1983](https://midi.org/midi-history-chapter-6-midi-begins-1981-1983?ref=geekjp.com)
- [CLASSIC VIDEOGAME STATION ODYSSEY:エポック社・堀江正幸氏インタビュー(カセットビジョンの主旨)](https://www.ne.jp/asahi/cvs/odyssey/creators/horie/7p.html?ref=geekjp.com)
- [Centre for Computing History: Epoch Cassette Vision](https://www.computinghistory.org.uk/det/60612/Epoch-Cassette-Vision/?ref=geekjp.com)
- [NESdev Wiki: List of games with expansion audio](https://www.nesdev.org/wiki/List%5Fof%5Fgames%5Fwith%5Fexpansion%5Faudio?ref=geekjp.com)
### 自前ゲームエンジンにおける古くて大事なこと:ゲームオブジェクト型エンジン
URL: https://www.geekjp.com/objectbaseengine/
Last updated: 2026-08-11T04:09:57.000Z
# はじめに
UnityやUnreal Engineなどの出来合いのゲームエンジンを使えば、エンジンそのものの仕組みを深く知らなくてもゲームを作ることはできます。
しかし、ゲームプログラマーとしてコンシューマーゲームやAAAタイトル、その土台になるゲームエンジンの開発を目指すのであれば、それだけでは十分とは言えません。C++で大規模なプログラムを組み、DirectXを使って描画やリソースを扱い、必要であればメモリやハードウェアに近いところまで理解していく力が必要になります。
この記事では、**そうした分野を目指す学生にとって、C++とDirectXを使ってゲームの土台を組めることは避けて通れない**、という立場で話を進めます。
今回扱うのは、`GameObject`を基底クラスとして、プレイヤー、敵、弾、アイテムなどを共通の仕組みで管理する昔ながらの**ゲームオブジェクト型エンジン**です。
これは最新の設計ではありません。現在ではコンポーネント指向やECS、データ指向設計など、さらに発展した方法も使われています。
しかし、古いからといって知らなくてよいわけではありません。ゲームループ、クラス、継承、仮想関数、オーバーライド、ポリモーフィズム、生成と削除、オブジェクトの寿命管理といった、ゲームプログラミングの基本事項がこの中に詰まっています。
**古いけれど、ゲームプログラマーを目指すなら避けて通れない。**
この記事では、C言語でゲームを作る場合の基本形から出発し、何がつらくなり、C++のクラス、継承、仮想関数によってそれをどう整理し、ゲームオブジェクト型エンジンへ発展させていくのかを順番に見ていきます。
---
## 1.ゲームは「初期化・更新・描画」で動いている
ゲームプログラムの基本的な処理は、大きく次の3つに分けられます。
1. **初期化**:ゲームに必要なデータを準備する
2. **更新**:キャラクターの位置や状態を変化させる
3. **描画**:現在の状態を画面へ表示する
初期化はゲームやステージを開始するときに一度行い、その後は更新と描画を何度も繰り返します。
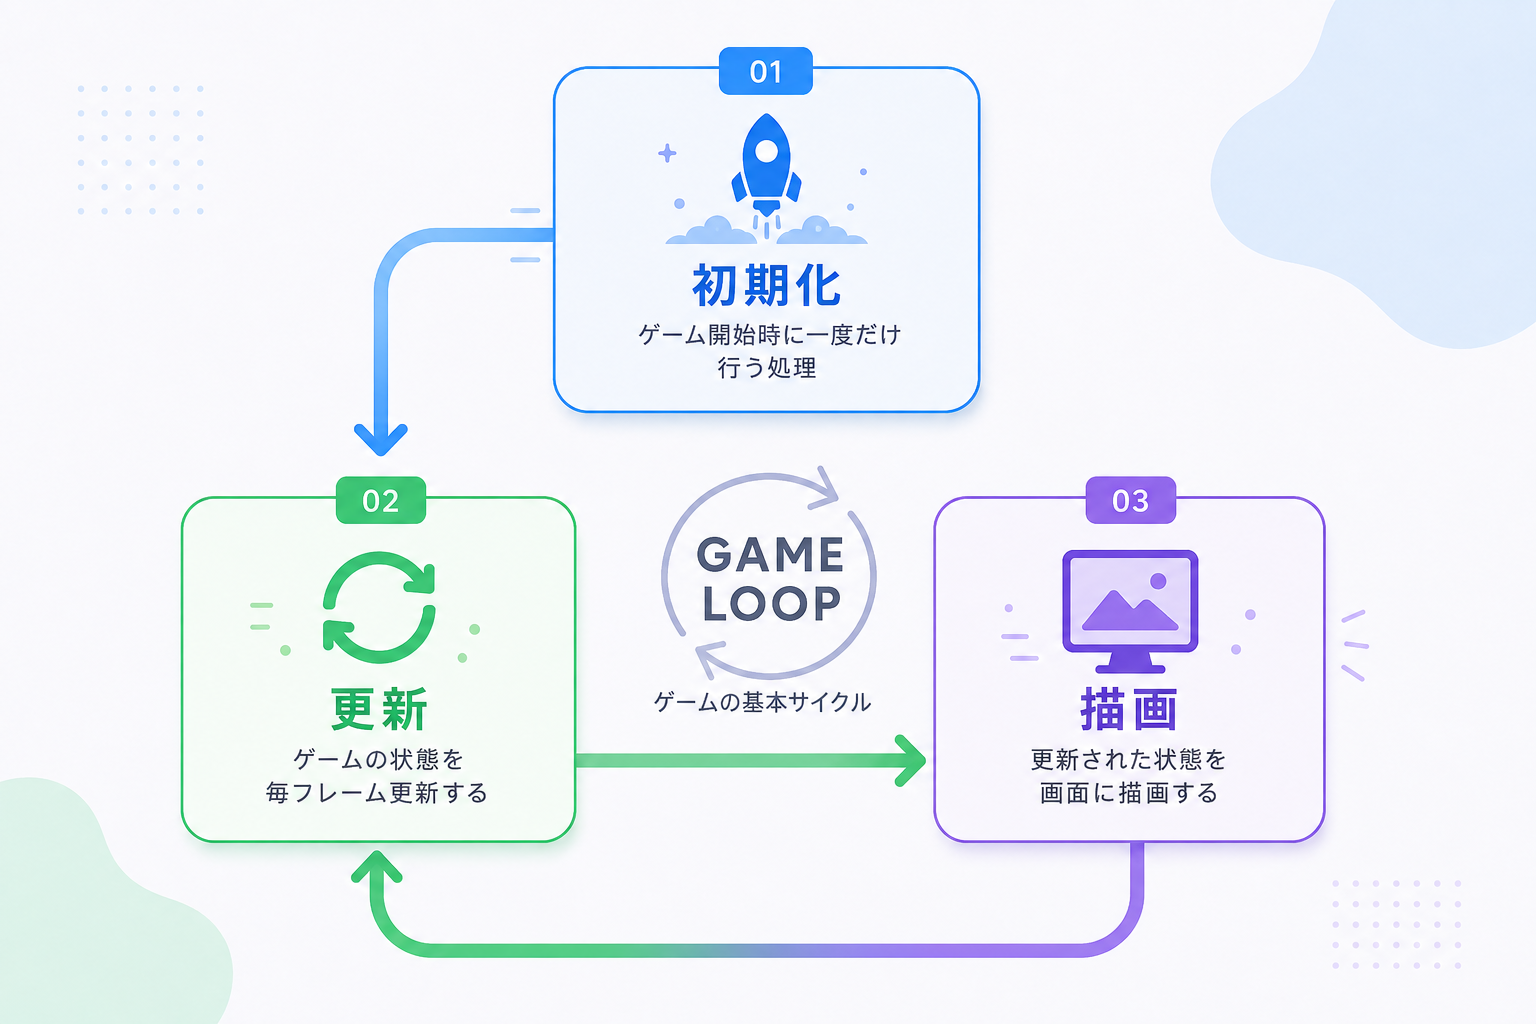
図 ゲームループ
この繰り返しが**ゲームループ**です。60fpsのゲームであれば、基本的には更新と描画を1秒間に約60回繰り返します。
実際には入力、衝突判定、物理演算、AI、サウンドなどもありますが、それらも大きく見れば初期化・更新・描画のどこかへ組み込まれています。
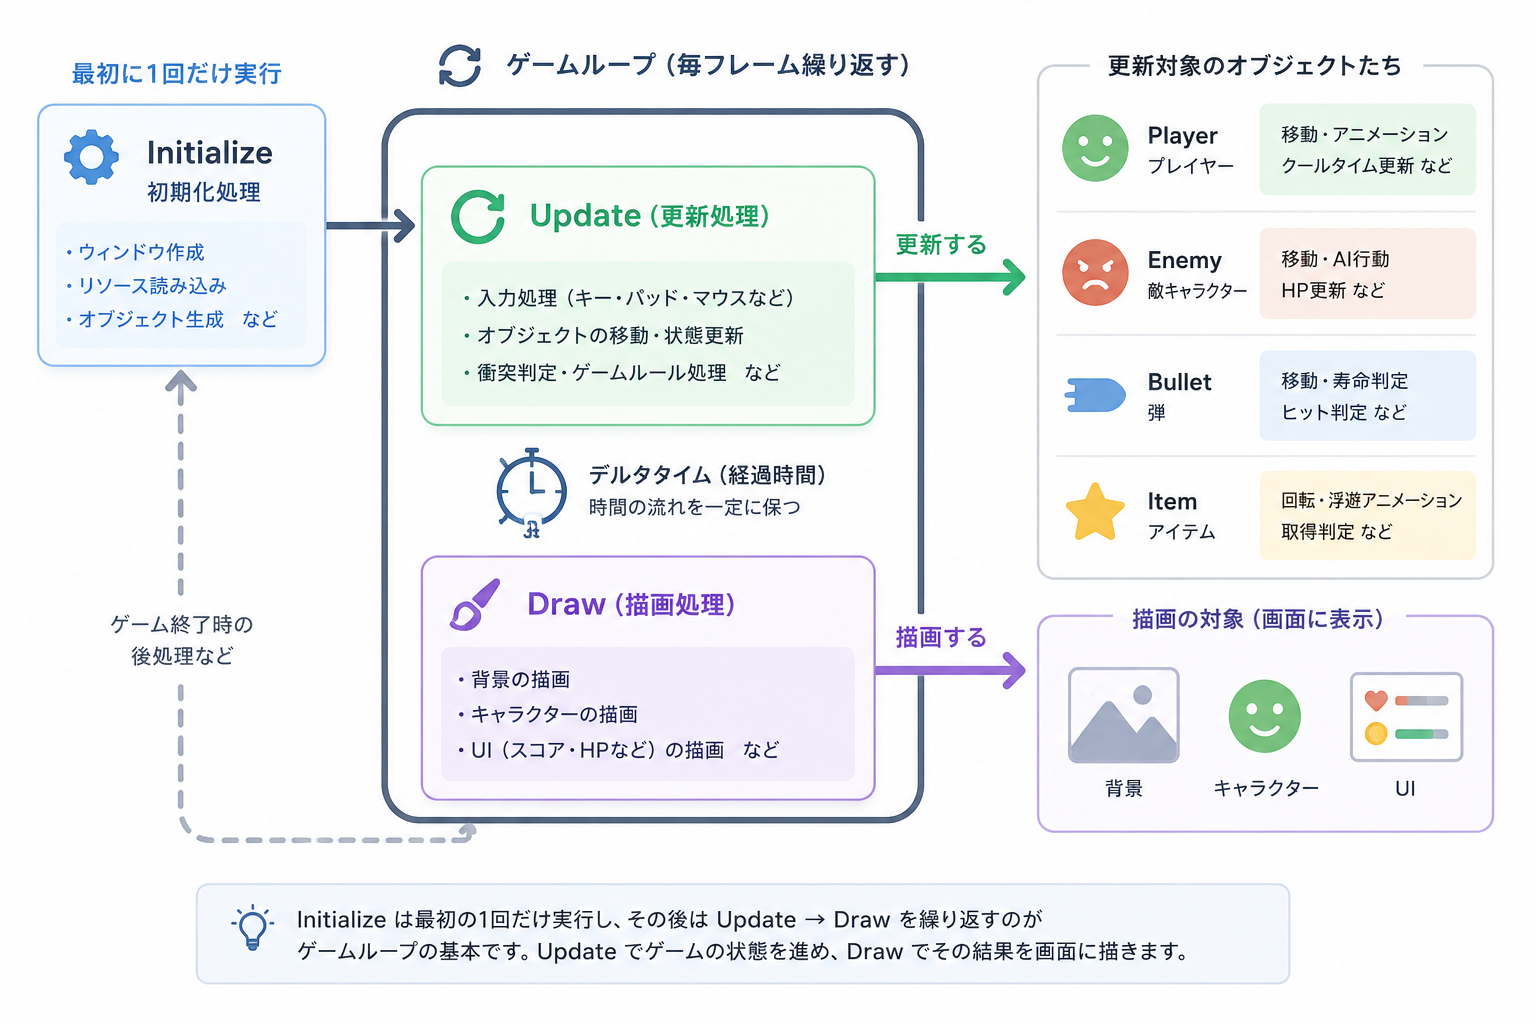
図 ゲームループとオブジェクト
---
## 2.C言語で作っていくと
### 構造体と関数を組み合わせて作る
C言語でプレイヤーのオブジェクト(自機とか、マ◯オ)を作る場合、まずデータを構造体にまとめます。
```c
struct Player
{
float x;
float y;
int hp;
};
```
しかし、構造体はデータを保存する箱です。`Player`構造体が自分で移動したり、自分を描画したりすることはありません。
そこで、構造体を操作する関数を別に作ります。
```c
void Player_Initialize(struct Player* player);
void Player_Update(struct Player* player);
void Player_Draw(const struct Player* player);
```
ゲーム側では、構造体と関数を組み合わせて使います。
```c
struct Player player;
Player_Initialize(&player);
while (Game_IsRunning())
{
Player_Update(&player);
Player_Draw(&player);
}
```
C言語では、次のものが別々に存在しています。
```text
Playerのデータ → Player構造体
Playerの初期化 → Player_Initialize関数
Playerの更新 → Player_Update関数
Playerの描画 → Player_Draw関数
```
人間から見れば、すべて「プレイヤーに関係するもの」です。しかし、C言語の仕組みとして、構造体と関数が一つのオブジェクトに結び付いているわけではありません。(普段C++で書いてるとこう見えてしまいます。Cで書いてるとそりゃそう作るだろって思うんだけどね。)
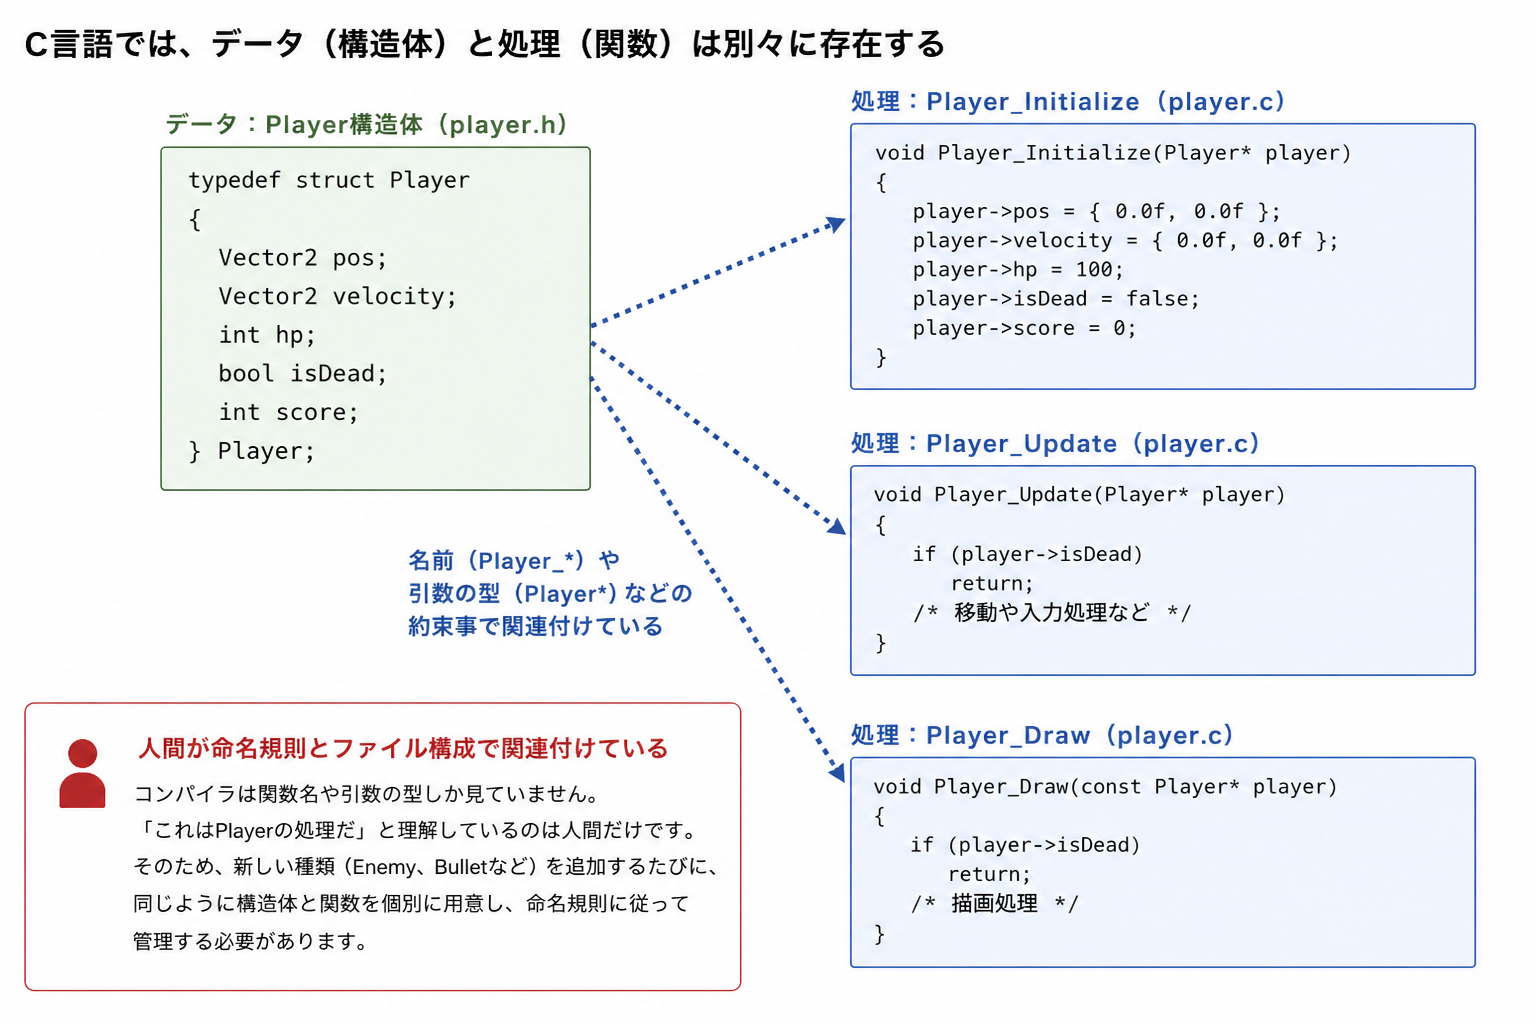
図 C言語のデータと、データ処理ロジック
---
## 3.オブジェクトが増えると、データと処理ロジックも増える
ゲームに敵を追加するなら、敵用の構造体と関数が必要です。
```c
struct Enemy
{
float x;
float y;
int hp;
};
void Enemy_Initialize(struct Enemy* enemy);
void Enemy_Update(struct Enemy* enemy);
void Enemy_Draw(const struct Enemy* enemy);
```
弾を追加するなら、弾用の構造体と関数も必要です。
```c
struct Bullet
{
float x;
float y;
float speed;
};
void Bullet_Initialize(struct Bullet* bullet);
void Bullet_Update(struct Bullet* bullet);
void Bullet_Draw(const struct Bullet* bullet);
```
さらに、敵や弾は複数登場します。そのため、種類ごとの配列と個数も管理しなければなりません。
```c
struct Player player;
struct Enemy enemies[100];
struct Bullet bullets[1000];
int enemyCount;
int bulletCount;
```
更新処理も、種類ごとに書きます。
```c
Player_Update(&player);
for (int i = 0; i < enemyCount; i++)
{
Enemy_Update(&enemies[i]);
}
for (int i = 0; i < bulletCount; i++)
{
Bullet_Update(&bullets[i]);
}
```
描画も同じです。
```c
Player_Draw(&player);
for (int i = 0; i < enemyCount; i++)
{
Enemy_Draw(&enemies[i]);
}
for (int i = 0; i < bulletCount; i++)
{
Bullet_Draw(&bullets[i]);
}
```
ボス、アイテム、エフェクト、NPC、扉、宝箱、動く床を追加するたびに、次の一式が増えていきます。
```text
構造体
初期化関数
更新関数
描画関数
配列
現在の個数
種類ごとの繰り返し処理
```
小さなゲームなら、この方法でも問題ありません。しかし、ゲームが大きくなるほど、**物量を増やして対応する構造**になっていきます。
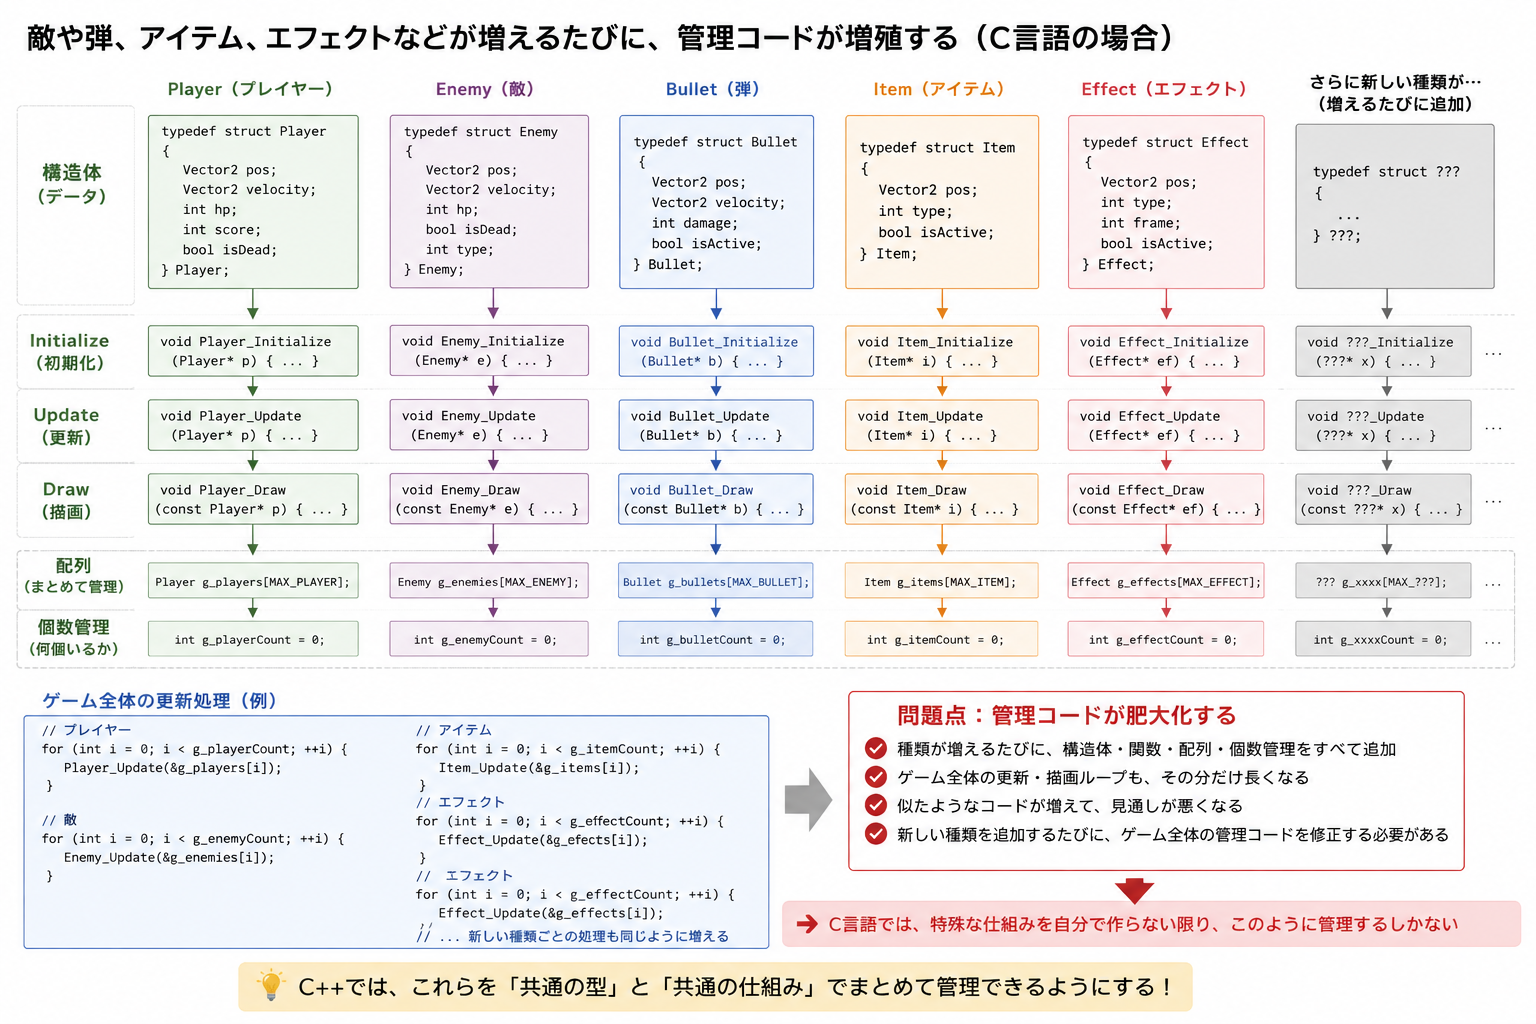
図 データと処理ロジックの増加
---
## 4.本当の問題は、コードが長くなることではない
この問題の本質は、単にコード量が増えることではありません。
Player、Enemy、Bulletなどを種類ごとに別々に管理しているため、初期化・更新・描画といった共通の処理も、それぞれに対して個別に書かなければなりません。
新しく`Dragon`を追加したら、`Dragon`の構造体と関数を作るだけでは終わりません。ゲーム全体の初期化、更新、描画へ、Dragon用の処理を書き足す必要があります。
また、ゲーム全体の更新方法や描画の流れを変更したい場合も、種類ごとに書かれた管理処理へ、それぞれ変更を反映しなければなりません。
つまり、ゲームに登場するものが増えるほど管理する側の処理も一緒に増え、ゲーム内容を追加したり共通の処理を変更したりするたびに、ゲーム全体の管理処理まで修正することになります。
C言語では、特殊な仕組みを自分で作らない限り、このように種類ごとにデータと処理を管理するしかありません。
C++ではこの辺のことをうまく解決することが出来ます。(と、言われています笑)
---
## 5.C++のクラスの役割
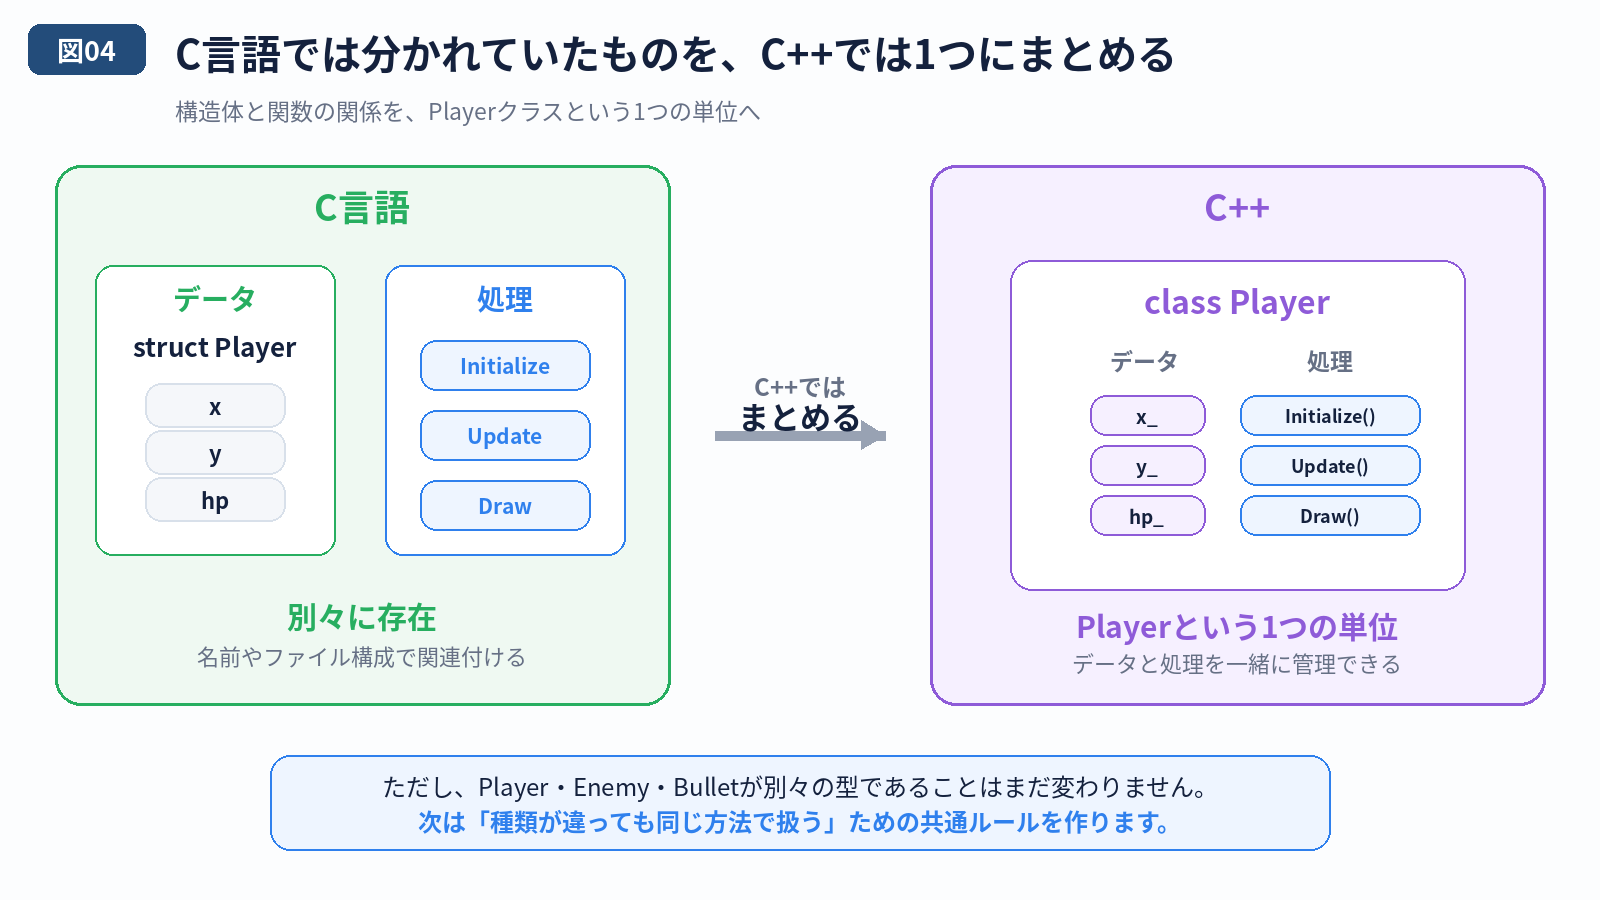
C言語では、キャラクターのデータを構造体に入れ、そのデータを操作する関数を別に用意していました。
C++のクラスでは、こうした**データと、そのデータを扱う処理を一つの単位としてまとめる**ことができます。(ある程度C++わかっている前提で話します)
```cpp
class Player
{
private:
float x_ = 0.0f;
float y_ = 0.0f;
int hp_ = 100;
bool isDead_ = false;
public:
void Initialize();
void Update();
void Draw() const;
void Damage(int damage);
bool IsDead() const;
};
```
C言語では別々に存在していた`Player`のデータと処理が、`Player`クラスという一つの単位にまとまりました。(これだけでも価値がありそうだよね!)
```text
Player
├─ x座標
├─ y座標
├─ HP
├─ Initialize
├─ Update
└─ Draw
```
呼び出す側も、次のようになります。
「誰」の「何」を処理するよ。というのが構造的にも、見た目的にもわかりやすくなります。
```cpp
Player player;
player.Initialize();
while (Game_IsRunning())
{
player.Update();
player.Draw();
}
```
クラスにまとめる利点は、関連するデータと関数を同じ場所へ置けることだけではありません。**そのデータを、どのような手順で変更するかもクラスに任せられます。**
例えば、プレイヤーが敵と接触したとき、当たり判定を行った側がHPを直接減らすのではなく、`Player`へダメージ処理を依頼します。
```cpp
if (IsHitPlayerAndEnemy())
{
player.Damage(20);
}
```
ここで呼び出す側が伝えているのは、「プレイヤーが20ダメージを受けた」という情報だけです。(hp=とか, isDead=とかをプレイヤーの外部から書かない)
HPを減らし、0未満にならないように補正し、必要であれば死亡状態へ変更する処理は、`Player`クラス自身が担当します。
```cpp
void Player::Damage(int damage)
{
hp_ -= damage;
if (hp_ <= 0)
{
hp_ = 0;
isDead_ = true;
}
}
bool Player::IsDead() const
{
return isDead_;
}
```
このようにすると、敵との接触、弾への命中、ステージギミックなど、ダメージを受ける原因が増えても、呼び出す側は同じように`Damage()`を呼ぶだけです。HPを0未満にしない処理や、どの条件で死亡状態になるのかを、それぞれの場所へ書く必要はありません。
外側の処理がプレイヤーの死亡状態を知りたい場合は、`IsDead()`を使って`Player`へ問い合わせます。
また、`hp_`と`isDead_`のアクセス指定を`private`にしておけば、外部から状態を直接書き換えられなくなります。C言語では、同じスコープ内の変数であれば自由に書き換え可能でしたが、その状態は多数のオブジェクトや似たようなプロフィールのオブジェクト(同じ構造体由来で、名前の違う似たような関数で似たような内容を処理する状態)では、引数の受け渡しミスや、代入ミスが何時起こっても不思議ではないです。(Cでプログラムを少し本気で作ってみればすぐその状態が理解できるよ!)
C++では、そのような状態を言語の仕組み上(public, private指定)でガードできます。
```cpp
player.hp_ -= 20; // privateなので書き換えられない
player.isDead_ = true; // privateなので書き換えられない
```
`private`にすること自体が目的なのではありません。**Playerが持つデータを、どのようなルールで変更するかを指定できるところ**に旨味があります。「**誰**」が「**どんな動作をしたら**」変数が変更されるか、を**public**な**メンバ関数**として外部に見せることができます。
## 6.クラスにまとめただけでは、一括管理できない
クラスによってデータと処理は整理できました。しかし、`Player`、`Enemy`、`Bullet`が別々の型であることに変わりはありません。
```cpp
Player player;
std::vector enemies;
std::vector bullets;
```
更新も、まだ種類ごとに必要です。
```cpp
player.Update();
for (Enemy& enemy : enemies)
{
enemy.Update();
}
for (Bullet& bullet : bullets)
{
bullet.Update();
}
```
C言語より整理しやすくなりましたが、更新や描画を種類ごとに個別に呼び出している点は変わっていません。新しい種類を追加すれば、その種類のための更新・描画処理を管理側へ書き足す必要があります。
そこで、種類が違っても同じ方法で初期化・更新・描画できるように、ゲームに登場するものが従う**共通のルール**を作ります。
---
## 7.すべてをGameObjectとして扱う
プレイヤーと敵では、持っているデータも動きも異なります。しかし、ゲームエンジンから見ると、次の点は共通しています。
- ゲームへ登場するときに初期化する
- 毎フレーム更新する
- 毎フレーム描画する
- 必要がなくなったら削除する
そこで、共通ルールとして`GameObject`クラスを作ります。
```cpp
class GameObject
{
private:
bool destroyRequested_ = false;
public:
virtual ~GameObject() = default;
virtual void Initialize() = 0;
virtual void Update() = 0;
virtual void Draw() const = 0;
void Destroy() { destroyRequested_ = true; }
bool IsDestroyRequested() const { return destroyRequested_; }
};
```
`GameObject`は具体的なキャラクターではありません。
「ゲーム内に存在するものは、初期化・更新・描画ができる」という、エンジンとゲームオブジェクトの間の約束です。
`Player`や`Enemy`は、このルールを継承します。
```cpp
class Player : public GameObject
{
public:
void Initialize() override;
void Update() override;
void Draw() const override;
};
class Enemy : public GameObject
{
public:
void Initialize() override;
void Update() override;
void Draw() const override;
};
```
それぞれの処理内容は違いますが、外側から見れば、どちらも`GameObject`です。
### なぜコンストラクタだけで初期化しないのか
C++にはコンストラクタがあるため、「`Initialize()`は不要ではないか」と思うかもしれません。
コンストラクタは、そのオブジェクトが成立するために必ず必要な初期値を設定する場所です。一方、ゲームエンジンでは、モデルや画像の読み込み、他オブジェクトの検索、エンジン機能への登録などを、オブジェクト生成後に行いたいことがあります。
そのため自前エンジンでは、コンストラクタと`Initialize()`を役割分担させる設計がよく使われます。ただし、何でも`Initialize()`へ押し込むのではなく、コンストラクタだけで安全な状態になるように作ることが大切です。基本的に**メンバ変数の初期化**は、コンストラクタに任せる設計がよいでしょう。
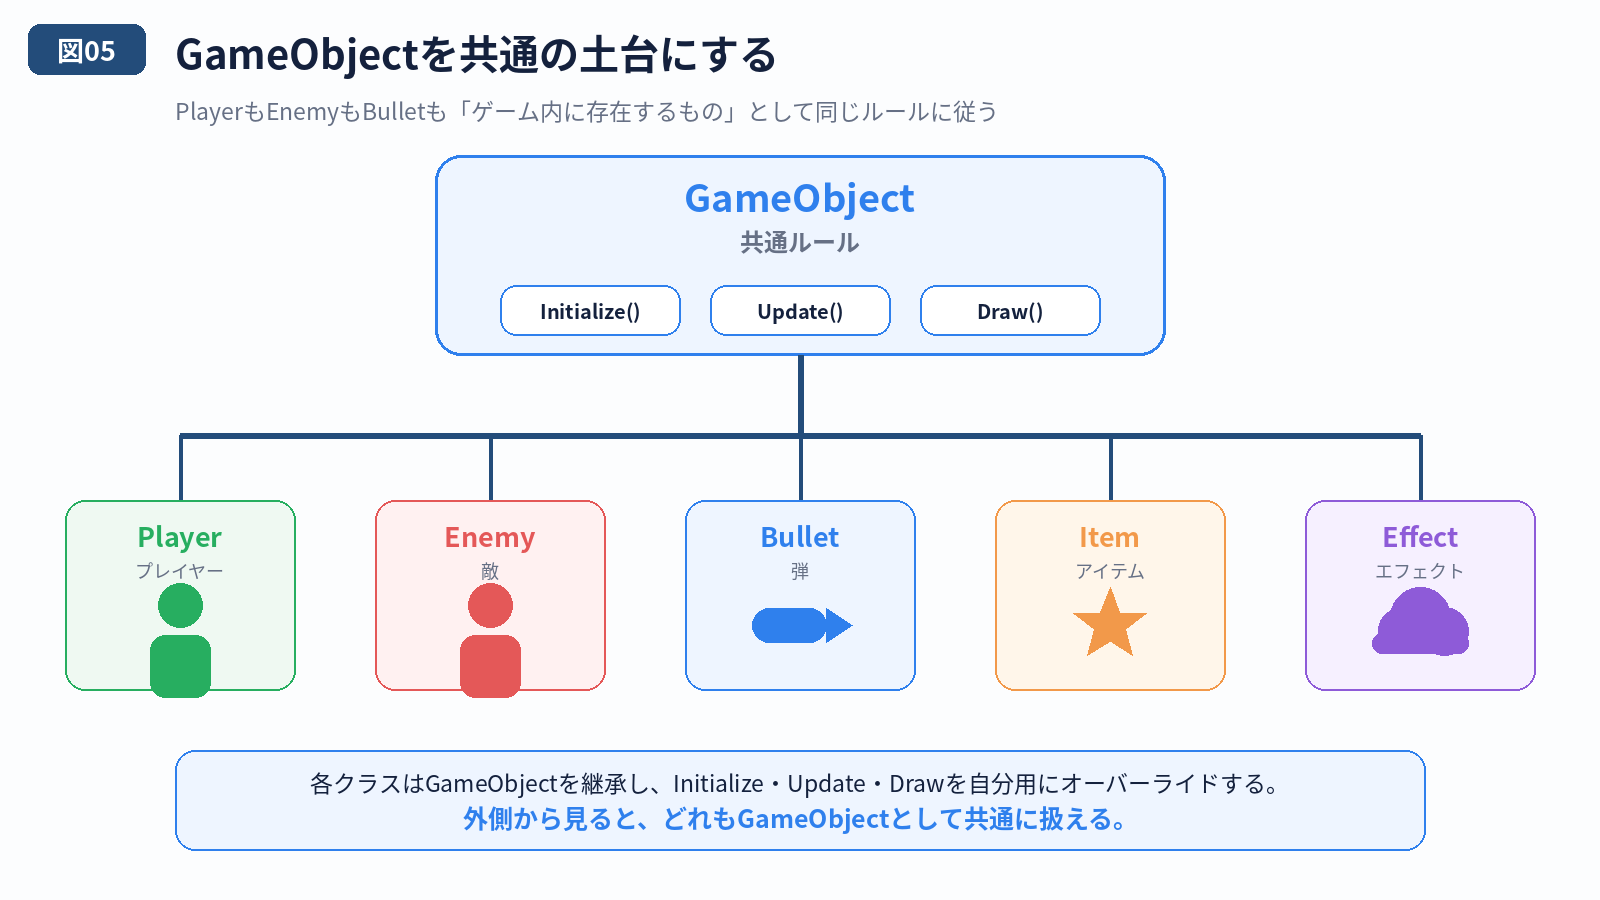
---
## 8.異なるクラスを同じ配列へ入れる
`Player`、`Enemy`、`Bullet`では、`GameObject`から受け継いだ`Update()`を、それぞれのクラスに必要な処理へ**オーバーライド(親クラスの処理の上書き)**します。
`Update()`の実装部分だけを抜き出すと、例えば次のようになります。
```cpp
void Player::Update()
{
// プレイヤーの更新処理
}
void Enemy::Update()
{
// 敵の更新処理
}
void Bullet::Update()
{
// 弾の更新処理
}
```
このように、それぞれが同じ`Update()`という名前の関数を持ちながら、中身は自分専用の処理にできます。`Initialize()`や`Draw()`も同じように、それぞれのクラスでオーバーライドします。
そして、すべてが`GameObject`を継承しているため、`GameObject*`として同じ配列へ入れられます。
```cpp
std::vector objects;
objects.push_back(new Player());
objects.push_back(new Enemy());
objects.push_back(new Bullet());
```
ここでは型の関係を見やすくするために生ポインタを使っています。オブジェクトを誰が所有し、どこで破棄するかはエンジンの設計によって異なるため、ここでは一括管理の仕組みに話を絞ります。
配列の型は、すべて`GameObject*`です。しかし、実際に指しているものは異なります。
```text
GameObject* → Player
GameObject* → Enemy
GameObject* → Bullet
```
この状態で、すべてのオブジェクトに同じように`Update()`を呼び出します。
```cpp
for (GameObject* object : objects)
{
object->Update();
}
```
`object`の型はすべて`GameObject*`ですが、`Update()`は仮想関数として定義され、それぞれのクラスでオーバーライドされています。そのため、呼び出されたときには実際のオブジェクトに対応した`Update()`が実行されます。
```text
実体がPlayer → Player::Update()
実体がEnemy → Enemy::Update()
実体がBullet → Bullet::Update()
```
このコードには、`Player`、`Enemy`、`Bullet`という名前を使った呼び分け処理はありません。それでも、オーバーライドした関数が実体に応じて選ばれます。
このように、同じ`GameObject*`として扱い、同じ`Update()`を呼び出しているにもかかわらず、実体に応じて異なる処理が実行される仕組みを、\*\*ポリモーフィズム(多態性)\*\*と呼びます。
よくあるオブジェクト指向の説明では、「同じ命令で違う処理が呼ばれる」と説明されます。しかし、ゲームエンジンで本当に重要なのは、その先です。
> エンジン側が、Player用、Enemy用、Bullet用と種類ごとの処理を書き分けなくても、一括して処理できる。
これが、ゲームオブジェクト型エンジンにおけるポリモーフィズムの実践的な価値です。
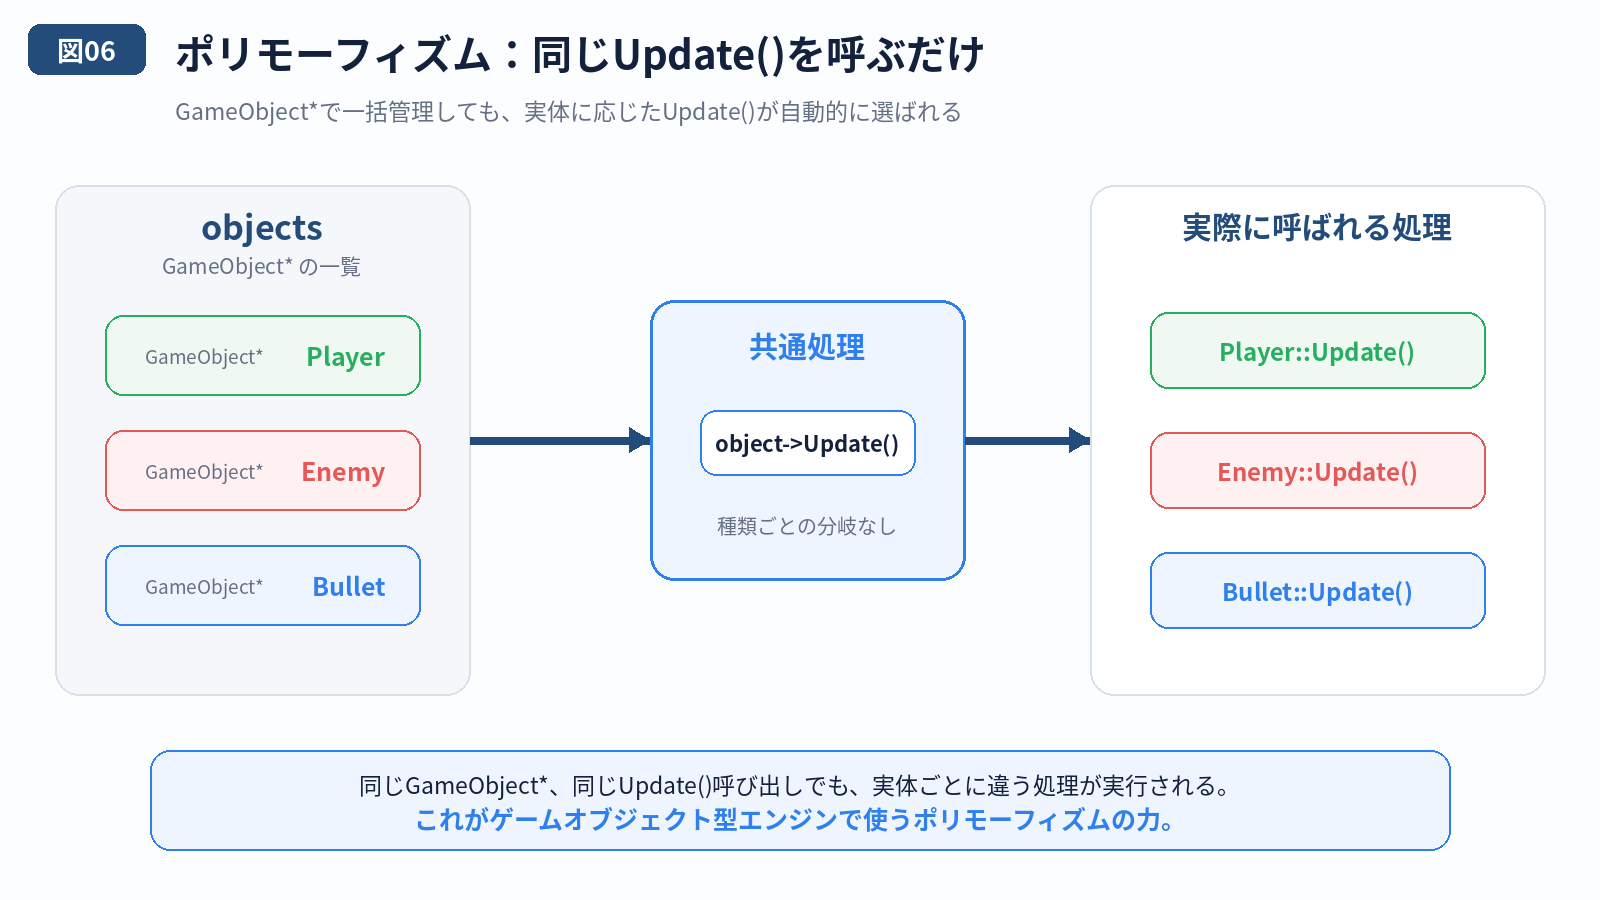
### 少しマニアックな話:virtualの裏側
多くのC++コンパイラでは、仮想関数を\*\*仮想関数テーブル(vtable)\*\*と呼ばれる関数一覧表で実現します。オブジェクトは自分の型に対応する表を参照し、`object->Update()`を呼ばれたときに、実体に合った関数を選びます。
C++規格がvtableという実装を必須にしているわけではありませんが、一般的な処理系ではこれに近い方法が使われます。そのため仮想関数呼び出しは完全に無料ではありません。
ただし、ここで重要なのは数命令の削減ではありません。`Player`、`Enemy`、`Bullet`ごとに更新処理を書き分けていた管理コードを、`GameObject`への共通の呼び出しへまとめられることです。
一方で、大量の頂点やパーティクルまで一個ずつ仮想関数で処理すればよい、という話ではありません。仮想関数はゲームオブジェクトを共通の方法で管理するために使い、重い大量処理では別の方法を選ぶ、という使い分けが重要になります。
---
## 9.新しい敵を追加しても、エンジン側は変えない
新しく`Dragon`を追加するとします。
```cpp
class Dragon : public GameObject
{
public:
void Initialize() override
{
// モデルや初期位置を準備する
}
void Update() override
{
// 空を飛び、炎を吐く
}
void Draw() const override
{
// ドラゴンを描画する
}
};
```
作成した`Dragon`を、ほかのゲームオブジェクトと同じリストへ追加します。
```cpp
objects.push_back(new Dragon());
```
必要なのは、`Dragon`クラスを作って管理対象へ加えることです。更新処理へDragon専用の呼び出しを追加する必要はありません。
```cpp
for (GameObject* object : objects)
{
object->Update();
}
```
`Dragon`を`objects`へ追加すれば、更新処理側に`Dragon`専用の呼び出しを追加する必要はありません。既存の`object->Update()`という共通処理から、実体に応じて`Dragon::Update()`が呼び出されます。
ゲーム固有の種類を増やしても、エンジン側の一括処理は変更しない。これがゲームオブジェクト型エンジンの大きな利点です。
ただし、クラスを作っただけで自動的にゲームへ登場するわけではありません。インスタンスを生成し、ゲームで管理しているオブジェクトの一覧へ加える処理は必要です。
ポリモーフィズムが自動化するのは、**登録されたオブジェクトに対して正しい処理を呼び分ける部分**です。
---
## 10.生成と削除、寿命管理まで含めてゲームエンジン
ゲームでは、敵のHPが0になったり、弾が画面外へ出たりすると、オブジェクトが不要になります。
ここで注意したいのは、**ゲーム上の「死亡」と、プログラム上の「オブジェクトを破棄する」は別の話**だということです。例えばプレイヤーが死亡しても、死亡演出やリザルト処理のために、しばらくオブジェクトを残しておくことがあります。
そのため`GameObject`側では、HPのようなゲーム内容の状態とは分けて、「このオブジェクトは削除してよい」という削除予約を管理します。先ほどの`destroyRequested_`はそのためのフラグです。
不要になったオブジェクトは`Destroy()`を呼びます。
```cpp
void Bullet::Update()
{
// 弾を移動する
if (画面外へ出た)
{
Destroy();
}
}
```
しかし、更新の繰り返し中にその場で配列から削除すると、走査中の配列が変化して繰り返し処理を壊すことがあります。
そこで`Destroy()`では、その場で`delete`したり配列から消したりせず、削除予約だけを行います。実際の削除は、すべての更新が終わった後など、安全なタイミングでまとめて行います。
```text
全オブジェクトをUpdate
↓
削除予約されたオブジェクトを除去
↓
残ったオブジェクトをDraw
```
### ObjectManagerにまとめると寿命管理が楽になる
ここまでの説明では、仕組みを見やすくするために`objects`というリストを直接扱ってきました。
しかし、ゲームが大きくなると、オブジェクトの追加、初期化、更新、描画、削除予約の確認、実際の削除といった処理を、ゲームループのあちこちへ書きたくはありません。
そこで自前エンジンでは、このような処理を`ObjectManager`のような専用クラスへまとめる設計がよく使われます。
```cpp
class ObjectManager
{
public:
void Add(GameObject* object);
void UpdateAll();
void RemoveDestroyedObjects();
void DrawAll() const;
};
```
ゲームループ側は、例えば次のようにできます。
```cpp
objectManager.UpdateAll();
objectManager.RemoveDestroyedObjects();
objectManager.DrawAll();
```
`ObjectManager`を作る利点は、単にゲームループが短くなることではありません。
- オブジェクトをどこへ登録するか
- いつ`Initialize()`するか
- いつ`Update()`するか
- `Destroy()`されたものをいつ実際に除去するか
- 削除中に新しいオブジェクトが追加された場合にどう扱うか
といった、**オブジェクトの寿命に関するルールを一か所へ集められる**ことが大きな利点です。
ただし、`ObjectManager`が必ずオブジェクトそのものを所有するとは限りません。`std::unique_ptr`でManagerが所有する設計もあれば、Sceneが所有する設計、オブジェクトプールやハンドルで管理する設計もあります。
大切なのは、所有方法を一つに決めつけることではなく、**生成・登録・削除のルールを明確にし、寿命管理を一元化しやすくすること**です。
`GameObject`のデストラクタが`virtual`なのも重要です。
```cpp
virtual ~GameObject() = default;
```
基底クラスのポインタを通して派生クラスのオブジェクトを破棄する設計では、基底クラスのデストラクタを`virtual`にしておく必要があります。そうでない状態で基底クラスのポインタから`delete`すると、C++では未定義動作になります。
ゲームエンジンは、単に`Update()`と`Draw()`を呼ぶ仕組みではありません。オブジェクトを作り、登録し、安全なタイミングで削除する、**寿命管理の仕組み**でもあります。
ただし、〇〇マネージャーってクラスを作ることをこよなく憎んでいる層も居るので、機能は同じでも名前の付け方に気をつけたほうがいいかもしれないです。
あと、どこかに書いた気もするけど、最近はこの管理方法を**スマートポインタ**に任せてしまうのが定石になりつつあります。
ただ、未だに、生ポインタを教えずにスマートポインタから教える人はかなり少ないと思いますので(その意味ではC++の前にC教えるのもだよね)この資料では、主に生ポインタを扱います。
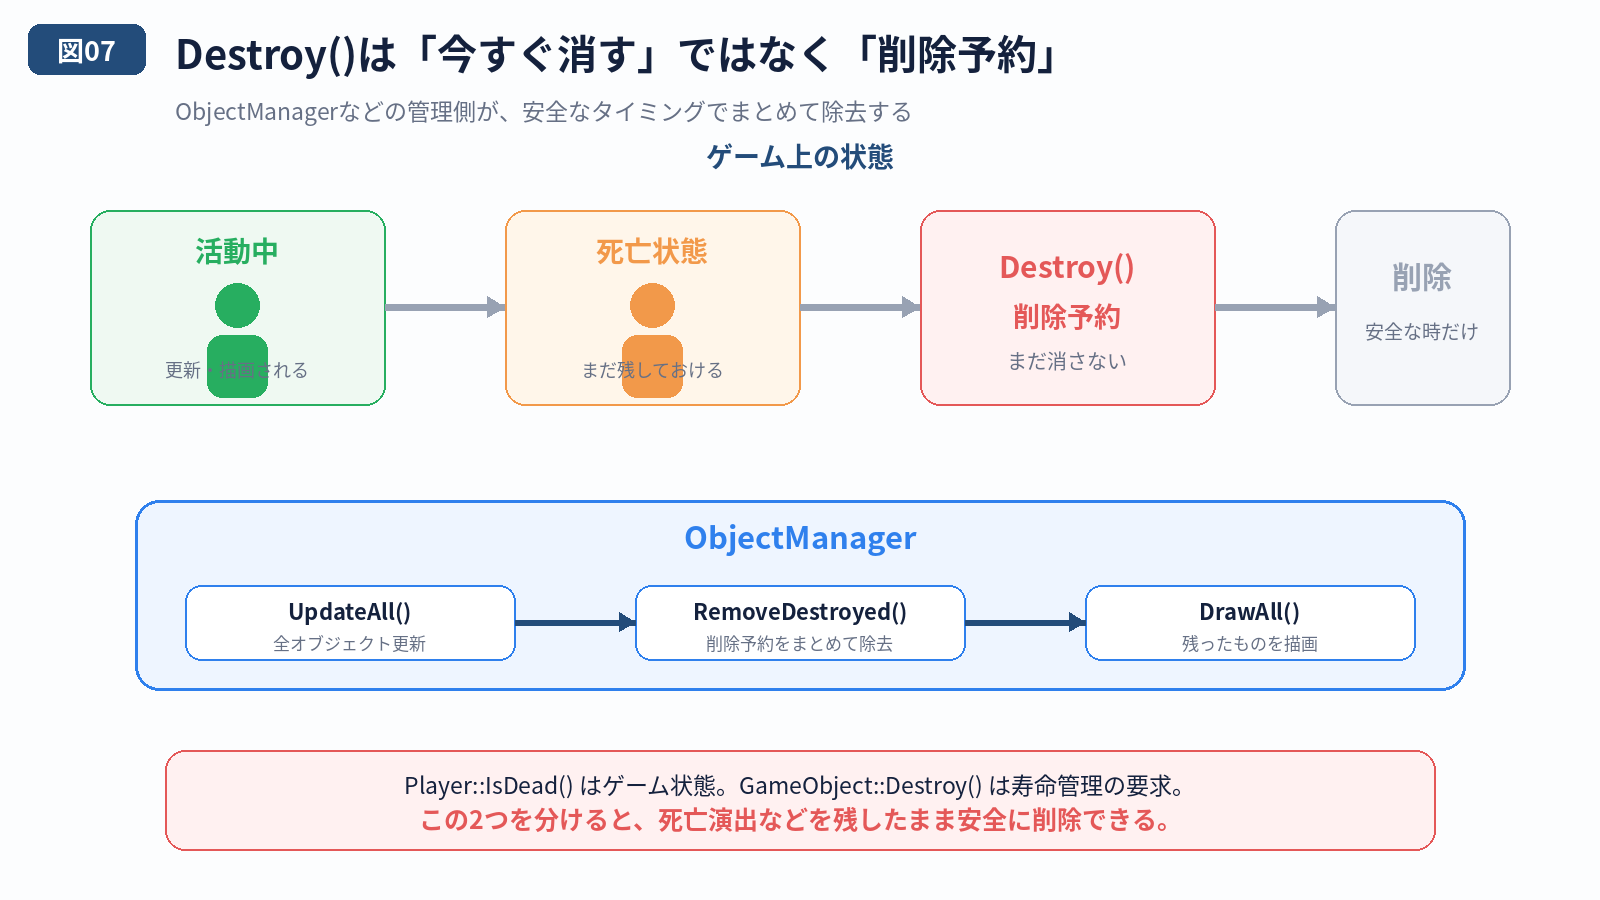
---
## 11.なぜC++なのか
ここまで見てきた`GameObject`、継承、仮想関数、ポリモーフィズムは、C++がゲームエンジンで力を発揮する理由の一部です。しかし、C++が使われる理由は「オブジェクト指向ができるから」だけではありません。
特にDirectXを使って自前で描画基盤まで作ろうとすると、ゲームエンジンには相反する二つの要求が出てきます。
1. 大量の機能を整理できる、高い抽象化能力
2. メモリやハードウェアを細かく制御できる、低レベルな操作能力
C++は、この両方を扱えます。
### クラスで大規模な機能を整理できる
ゲームエンジンには、`GameObject`以外にも、`Scene`、`Renderer`、`Camera`、`Input`、`Sound`、`ResourceManager`など、多くの仕組みがあります。C++では、これらをクラスとして整理し、役割を分けられます。
### 必要なら低レベルまで降りられる
ゲームエンジンは、GPUバッファ、画像データ、音声データ、ファイル、メモリアドレスなどを直接扱います。
```cpp
void* mappedMemory;
unsigned char* imageData;
ID3D11Buffer* vertexBuffer;
```
`GameObject`や`Renderer`のような高水準なクラスを使いながら、DirectXへ渡すGPUリソースやメモリを扱うところでは、C言語に近い低レベルな操作まで降りられます。
### オブジェクトの寿命を管理できる
C++では、変数の寿命が終わるとデストラクタが呼ばれます。メモリ、ファイル、GPUリソース、サウンドなどの解放を、オブジェクトの寿命と結び付けられます。この考え方が**RAII**です。
ゲームでは大量のリソースを扱うため、「いつ解放されるか」を把握できることが重要です。
### オブジェクト指向だけを強制されない
C++では、すべてを継承と仮想関数で作る必要はありません。
ゲーム全体の管理にはGameObject型のポリモーフィズムを使い、重い計算では単純な配列をまとめて処理できます。
```cpp
for (Transform& transform : transforms)
{
transform.position += transform.velocity * deltaTime;
}
```
C++では、手続き型、オブジェクト指向、ジェネリックプログラミング、データ指向、低レベルプログラミングを、目的に応じて使い分けられます。
つまり、C++がゲームエンジンに向いている理由は、単にオブジェクト指向言語だからではありません。
> 高度な抽象化を使いながら、必要になればメモリやハードウェアに近い場所まで降りられる。
この柔軟性が、ゲームエンジンと相性がよいのです。
---
## 12.古い設計だからこそ、理解する意味がある
`GameObject`を継承し、仮想関数で`Update()`と`Draw()`を呼ぶ設計は、現代のゲームエンジンにおける唯一の正解ではありません。
継承だけで機能を増やすと、クラス階層が深くなります。
```text
GameObject
└─ Character
└─ Enemy
└─ FlyingEnemy
└─ ShootingFlyingEnemy
```
そのため、現代のゲームエンジンでは、機能を部品として組み合わせるコンポーネント型の設計が使われます。
```text
GameObject
├─ Transform
├─ Renderer
├─ Collider
├─ Controller
└─ AudioSource
```
さらに、大量のオブジェクトを高速に処理するため、ECSやデータ指向設計も利用されます。
しかし、GameObject型エンジンが古いことと、学ぶ必要がないことは別です。
コンポーネント型が何を解決したのかを理解するには、その前に、継承型のGameObjectがどこで苦しくなるのかを知る必要があります。ECSを理解するにも、まずオブジェクト単位で管理する方式を知る必要があります。
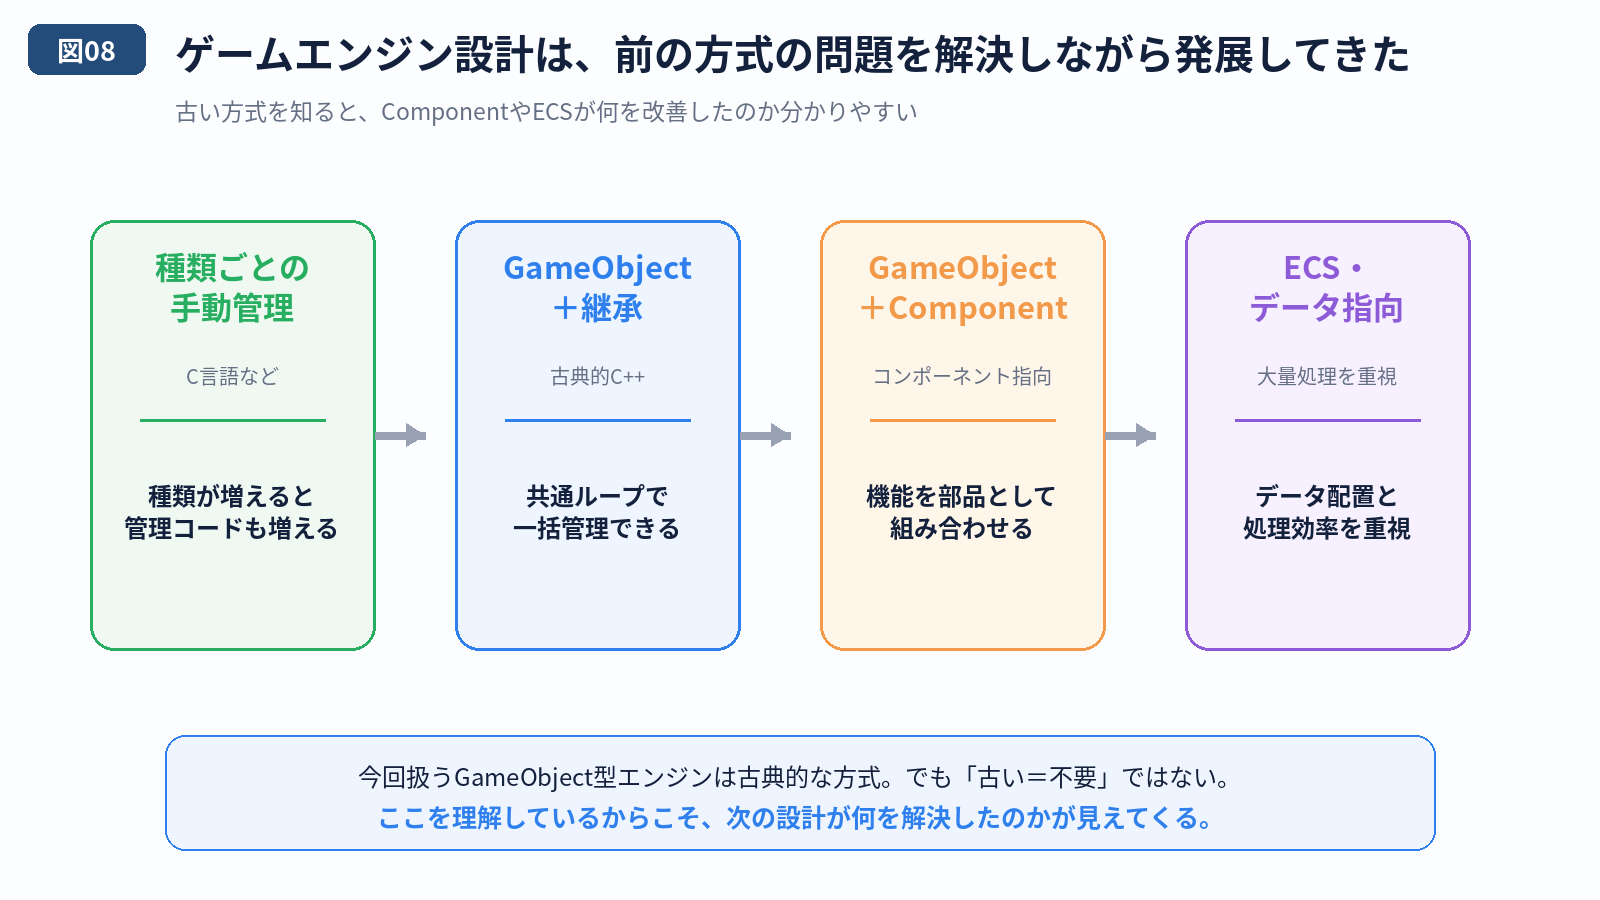
---
## 13.ゲーム業界を目指すなら、ここは避けて通れない
ゲームオブジェクト型エンジンは、最新技術ではありません。
しかし、ここにはゲームループ、クラス、継承、仮想関数、オーバーライド、ポリモーフィズム、オブジェクトの生成と削除、寿命管理、所有権をどこへ置くかという設計判断、共通の管理処理と各オブジェクト固有処理の役割分担といった基本事項が詰まっています。
コンシューマーゲームやAAAタイトル、その基盤となるゲームエンジン側を目指すのであれば、C++やDirectXを「使ったことがある」だけでは足りません。なぜこのような構造にするのか、どの問題を解決するための仕組みなのかまで理解して、自分で組み立てられる必要があります。
`GameObject`、継承、仮想関数、ポリモーフィズムも、用語として説明できるだけでは足りません。
```cpp
for (GameObject* object : objects)
{
object->Update();
}
```
この短いコードが、C言語で種類ごとに書いていた大量の更新処理をどのように置き換え、種類の違うオブジェクトを同じ管理処理で扱えるようにしたのか。さらに、`Destroy()`で削除予約を行い、`ObjectManager`のような管理側で安全なタイミングにまとめて除去することで、オブジェクトの寿命をどう整理できるのか。
そこまでつながって、初めてゲームエンジンの中でオブジェクト指向が何のために使われているのかを実践的に理解したと言えます。古い仕組みです。しかし、古いということは、長い間ゲーム開発の基礎として使われ、そこから次の設計へ発展してきた仕組みでもあります。
**自前でゲームエンジンを作るなら避けて通れない基本事項です。**
現代風のプログラミングでは、どうしても、これらにスマートポインタが絡んできます。この古い仕組みをスマートポインタで実装するところから始めるのもいい修行になるかと思います。
---
## 付録:C言語でも同じ仕組みは作れるのか
C言語にも関数ポインタがあるため、GameObject型エンジンに近い仕組みを作ることはできます。
```c
struct GameObject;
typedef void (*InitializeFunction)(struct GameObject* object);
typedef void (*UpdateFunction)(struct GameObject* object);
typedef void (*DrawFunction)(const struct GameObject* object);
struct GameObject
{
InitializeFunction initialize;
UpdateFunction update;
DrawFunction draw;
};
```
プレイヤー構造体の先頭に、共通部分となる`GameObject`を置きます。
```c
struct Player
{
struct GameObject base;
float x;
float y;
int hp;
};
```
以下は、更新処理だけを抜粋した例です。関数ポインタへ、GameObject用の窓口となる関数を手動で登録します。
```c
void Player_UpdateObject(struct GameObject* object)
{
struct Player* player = (struct Player*)object;
// Player固有の更新処理
}
void Player_Setup(struct Player* player)
{
player->base.update = Player_UpdateObject;
}
```
呼び出す側は、次のように共通化できます。
```c
object->update(object);
```
技術的には可能です。しかし、実際には次のような規約を人間が管理しなければなりません。
- 基底構造体を必ず先頭へ置く
- 関数ポインタを正しく登録する
- 登録忘れや誤登録を防ぐ
- 派生型へのキャストを正しく行う
- 初期化と終了処理を正しい順番で呼ぶ
C++では、クラス、継承、仮想関数、`override`、コンストラクタ、デストラクタ、アクセス制御、型チェックによって、これらの多くを言語とコンパイラが支援してくれます。
C言語でも不可能ではありません。しかし、ゲームエンジンのように多くの種類と大量のオブジェクトを扱うプログラムでは、手作業で守る規約が増えすぎます。
**作れるかどうかと、継続的に安全に管理できるかどうかは別の問題です。**
### WinAPIのWNDCLASSA・WNDCLASSW・WNDCLASSEXA・WNDCLASSEXWの違いってなんだ?
URL: https://www.geekjp.com/aroundwindowsclass/
Last updated: 2026-08-01T12:18:22.000Z
Win32 APIでウィンドウを作ろうとすると、`RegisterClass`や`RegisterClassEx`という関数を使って、ウィンドウの属性や動作をあらかじめWindowsへ登録する場面が出てきます。
このとき設定するのが、**ウィンドウクラス**です。
ここでいうウィンドウクラスは、C++の`class`とは別物です。ウィンドウのアイコン、マウスカーソル、背景色、ウィンドウプロシージャなどをまとめた、いわば**ウィンドウの設計情報**です。
ところが、このウィンドウクラスを設定しようとすると、いきなり次の4種類が登場します。
```cpp
WNDCLASSA
WNDCLASSW
WNDCLASSEXA
WNDCLASSEXW
```
名前がほとんど同じなので、初めて見ると次のような疑問が出てきます。
- `WNDCLASS`と`WNDCLASSEX`は何が違うのか
- 末尾の`A`と`W`には何の意味があるのか
- なぜ文字列に`L`を付けるコードがあるのか
- `WNDCLASSEX`とだけ書かれているサンプルは何なのか
- Visual Studioの「Unicode文字セットを使用する」と関係があるのか
この記事では、この4種類の違いを順番に整理します。
結論から言うと、違いは次の2つだけです。
```text
WNDCLASS / WNDCLASSEX
基本版か拡張版か
A / W
扱う文字列の種類
```
4種類を個別に暗記する必要はありません。`EX`の意味と、`A`・`W`の意味を理解すれば整理できます。
## 4種類の違いを先に整理する
| 構造体 | 基本・拡張 | 使用する文字列 | クラス名の型 |
| ----------- | ----- | --------- | ------- |
| WNDCLASSA | 基本版 | char系 | LPCSTR |
| WNDCLASSW | 基本版 | wchar\_t系 | LPCWSTR |
| WNDCLASSEXA | 拡張版 | char系 | LPCSTR |
| WNDCLASSEXW | 拡張版 | wchar\_t系 | LPCWSTR |
名前を分解すると、次のようになります。
```text
WNDCLASS + A
WNDCLASS + W
WNDCLASSEX + A
WNDCLASSEX + W
```
つまり、覚えることは次の2点です。
```text
EXが付く
→ 拡張版
AまたはWが付く
→ 文字列の種類が変わる
```
まずは、`WNDCLASS`と`WNDCLASSEX`の違いから確認します。
---
## 1.WNDCLASSとWNDCLASSEXの違い
最初に、末尾の`A`と`W`を無視して考えます。
```text
WNDCLASS
WNDCLASSEX
```
`WNDCLASSEX`は、`WNDCLASS`を拡張した構造体です。
### WNDCLASSの構造
Unicode版の`WNDCLASSW`は、概略として次のメンバを持っています。
```cpp
typedef struct tagWNDCLASSW
{
UINT style;
WNDPROC lpfnWndProc;
int cbClsExtra;
int cbWndExtra;
HINSTANCE hInstance;
HICON hIcon;
HCURSOR hCursor;
HBRUSH hbrBackground;
LPCWSTR lpszMenuName;
LPCWSTR lpszClassName;
} WNDCLASSW;
```
ウィンドウクラスには、次のような設定を登録します。
- ウィンドウの動作を表すスタイル
- メッセージを処理するウィンドウプロシージャ
- アプリケーションのインスタンス
- アイコン
- マウスカーソル
- 背景ブラシ
- メニュー名
- ウィンドウクラス名
ここでいう「ウィンドウクラス」は、C++の`class`とは別物です。
Win32 APIにおけるウィンドウクラスは、これから生成するウィンドウの共通設定をまとめたものです。
```text
ウィンドウクラス
ウィンドウの設計情報
ウィンドウ
その設計情報を使って実際に生成されたもの
```
### WNDCLASSEXの構造
拡張版の`WNDCLASSEXW`は、概略として次のメンバを持っています。
```cpp
typedef struct tagWNDCLASSEXW
{
UINT cbSize;
UINT style;
WNDPROC lpfnWndProc;
int cbClsExtra;
int cbWndExtra;
HINSTANCE hInstance;
HICON hIcon;
HCURSOR hCursor;
HBRUSH hbrBackground;
LPCWSTR lpszMenuName;
LPCWSTR lpszClassName;
HICON hIconSm;
} WNDCLASSEXW;
```
`WNDCLASSW`と比較すると、次の2つが追加されています。
```cpp
UINT cbSize;
HICON hIconSm;
```
### cbSize
`cbSize`には、使用する構造体全体のサイズを指定します。
```cpp
WNDCLASSEXW windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXW);
```
`WNDCLASSEXW`を使用しているのに、別の構造体のサイズを指定してはいけません。
```cpp
WNDCLASSEXW windowClass{};
// 間違い
windowClass.cbSize =
sizeof(WNDCLASSW);
```
使用している構造体自身のサイズを指定します。
```cpp
windowClass.cbSize =
sizeof(WNDCLASSEXW);
```
### hIconSm
`hIconSm`には、ウィンドウクラスで使用する小さいアイコンを指定します。
```cpp
windowClass.hIconSm =
LoadIconW(
nullptr,
IDI_APPLICATION
);
```
従来からある`hIcon`には、通常サイズのアイコンを指定します。
```cpp
windowClass.hIcon =
LoadIconW(
nullptr,
IDI_APPLICATION
);
```
`WNDCLASSEX`と`WNDCLASS`の構造上の違いは、基本的に次の2つです。
| 追加メンバ | 役割 |
| ------- | -------------- |
| cbSize | 構造体全体のサイズを指定する |
| hIconSm | 小さいアイコンを指定する |
### 登録関数も異なる
`WNDCLASS`と`WNDCLASSEX`では、対応する登録関数も異なります。
| 構造体 | 登録関数 |
| ----------- | ---------------- |
| WNDCLASSA | RegisterClassA |
| WNDCLASSW | RegisterClassW |
| WNDCLASSEXA | RegisterClassExA |
| WNDCLASSEXW | RegisterClassExW |
例えば、`WNDCLASSEXW`を使う場合は`RegisterClassExW`で登録します。
```cpp
WNDCLASSEXW windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXW);
RegisterClassExW(
&windowClass
);
```
次の組み合わせは間違いです。
```cpp
WNDCLASSEXW windowClass{};
// WNDCLASSW用の関数なので型が合わない
RegisterClassW(
&windowClass
);
```
### WNDCLASSとWNDCLASSEXの比較
| 項目 | WNDCLASS | WNDCLASSEX |
| -------------- | ------------- | --------------- |
| 基本的なウィンドウクラス設定 | できる | できる |
| 構造体サイズの指定 | なし | cbSize |
| 小さいアイコンの指定 | なし | hIconSm |
| 対応する登録関数 | RegisterClass | RegisterClassEx |
| 新規コードでの選択 | 使用可能 | 基本的にこちらでよい |
したがって、新しくコードを書く場合は、拡張版の`WNDCLASSEX`を選べばよいでしょう。
---
## 2.末尾のAとWの違い
次に、末尾の`A`と`W`を見ていきます。
```text
A
Windowsコードページ版
W
Unicode版・Wide Character版
```
一般には、次のように説明されることが多いです。
```text
A
ANSI版
W
Wide版
```
ただし、A版の「ANSI」という呼び方は歴史的なものです。
実際には、A版APIはWindowsのコードページに基づく`char`文字列を扱います。必ずしも特定のANSI規格そのものを意味するわけではありません。
### A版で使う文字列
A版では、`char`系の文字列を使用します。
```cpp
WNDCLASSEXA windowClass{};
windowClass.lpszClassName =
"SampleWindowClass";
```
`WNDCLASSEXA::lpszClassName`の型は`LPCSTR`です。
`LPCSTR`は、実質的には次の型です。
```cpp
const char*
```
したがって、通常の文字列リテラルを代入できます。
```cpp
"SampleWindowClass"
```
登録にはA版の関数を使用します。
```cpp
RegisterClassExA(
&windowClass
);
```
ウィンドウ生成にもA版を使用します。
```cpp
CreateWindowExA(
0,
"SampleWindowClass",
"Sample Window",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
```
### W版で使う文字列
W版では、`wchar_t`系のワイド文字列を使用します。
```cpp
WNDCLASSEXW windowClass{};
windowClass.lpszClassName =
L"SampleWindowClass";
```
`WNDCLASSEXW::lpszClassName`の型は`LPCWSTR`です。
`LPCWSTR`は、実質的には次の型です。
```cpp
const wchar_t*
```
そのため、文字列リテラルの先頭に`L`を付けます。
```cpp
L"SampleWindowClass"
```
登録にはW版の関数を使用します。
```cpp
RegisterClassExW(
&windowClass
);
```
ウィンドウ生成にもW版を使用します。
```cpp
CreateWindowExW(
0,
L"SampleWindowClass",
L"サンプルウィンドウ",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
```
### 普通の文字列とL付き文字列は型が違う
次の2つは、見た目が似ていますが、C++上では異なる型です。
```cpp
"SampleWindowClass"
```
```cpp
L"SampleWindowClass"
```
対応を整理すると次のようになります。
| 書き方 | 文字型 | ポインター型 | 対応するWin32 API |
| ------ | -------- | ---------------- | ------------- |
| "ABC" | char | const char\* | A版 |
| L"ABC" | wchar\_t | const wchar\_t\* | W版 |
文字列の先頭に付いている`L`は、表示される文字ではありません。
コンパイラに対して、文字列を`wchar_t`の配列として作るように指定する接頭辞です。
### A版とW版の対応
| 項目 | A版 | W版 |
| ------- | ---------------- | ---------------- |
| 構造体 | WNDCLASSEXA | WNDCLASSEXW |
| クラス名の型 | LPCSTR | LPCWSTR |
| 実質的な型 | const char\* | const wchar\_t\* |
| 文字列リテラル | "ABC" | L"ABC" |
| 登録関数 | RegisterClassExA | RegisterClassExW |
| ウィンドウ生成 | CreateWindowExA | CreateWindowExW |
| 文字の扱い | Windowsコードページ | UTF-16 |
構造体だけをW版にしても、登録関数や文字列がA版のままでは型が合いません。
```text
WNDCLASSEXW
↓
RegisterClassExW
↓
CreateWindowExW
↓
L"文字列"
```
このように、構造体、関数、文字列を同じ系統へそろえる必要があります。
---
## 3.マルチバイト文字列とは
A版の説明では、`char`系の文字列とWindowsコードページが登場しました。
では、A版でよく使われる「マルチバイト文字列」とは何でしょうか。
マルチバイト文字列は、`char`を使いながら、1文字を1バイトまたは複数バイトで表現する方式です。
日本語Windowsで古くから使われてきたコードページでは、英数字などを1バイト、日本語の多くを2バイトで表現します。
```text
A
1バイト
あ
2バイトになることがある
```
このため、見た目の文字数とバイト数が一致しない場合があります。
```cpp
const char* text = "日本語";
```
この文字列を`char`単位で調べると、1つの日本語文字が複数の要素に分かれます。
### A版APIはWindowsコードページを使う
A版のWin32 APIは、`char`の文字列をWindowsコードページに従って解釈します。
```cpp
MessageBoxA(
nullptr,
"メッセージ",
"タイトル",
MB_OK
);
```
ここで重要なのは、A版が必ずUTF-8を扱うわけではないという点です。
```text
std::string
= 自動的にUTF-8ではない
char文字列
= 自動的にShift_JISでもない
```
`char`や`std::string`は、バイトを保存するための型です。
中身がUTF-8なのか、Windowsコードページなのかは、型だけでは判断できません。
A版APIは実行環境のWindowsコードページに依存するため、別の言語環境への移植や、扱えない文字を含む場合に問題が起きやすくなります。
そのため、新規のWindowsアプリケーションではUnicode版の利用が推奨されます。
---
## 4.Unicode文字列とは
Unicodeは、世界中の文字に共通の番号を割り当てるための規格です。
Unicodeの文字をコンピューター上に保存する方法には、次のようなものがあります。
```text
Unicode
├─ UTF-8
├─ UTF-16
└─ UTF-32
```
つまり、UnicodeとUTF-16は同じ意味ではありません。
```text
Unicode
文字を整理する規格
UTF-16
Unicodeの文字を保存する方式の1つ
```
### Win32 APIのW版はUTF-16を使う
WindowsのW版APIは、基本的にUTF-16の文字列を使用します。
C++では主に次の型で扱います。
```cpp
wchar_t
const wchar_t*
std::wstring
```
Win32 APIでは、次の型名が使われます。
```cpp
WCHAR
LPWSTR
LPCWSTR
```
対応を整理すると次のようになります。
| C++の型 | Win32の型 | 意味 |
| ---------------- | ------- | ------------- |
| wchar\_t | WCHAR | ワイド文字の1コード単位 |
| wchar\_t\* | LPWSTR | 書き換え可能なワイド文字列 |
| const wchar\_t\* | LPCWSTR | 読み取り専用のワイド文字列 |
例えば、次のコードは`LPCWSTR`へ代入できます。
```cpp
LPCWSTR className =
L"SampleWindowClass";
```
`LPCWSTR`は特殊な文字列クラスではありません。
実質的には`const wchar_t*`へ付けられたWindows独自の型名です。
### 1文字が必ず1個のwchar\_tとは限らない
Windowsの`wchar_t`は、UTF-16の1コード単位を格納します。
多くの日本語や英数字は1個の`wchar_t`で表現できますが、Unicodeのすべての文字が必ず1個に収まるわけではありません。
絵文字や一部の文字は、2個のUTF-16コード単位で表現されます。
したがって、`std::wstring::size()`が返す値は、必ずしも人間が見た文字数と一致しません。
この記事では、まず次の対応を押さえておけば十分です。
```text
A版
char
LPCSTR
"文字列"
W版
wchar_t
LPCWSTR
L"文字列"
```
---
## 5.4種類をもう一度整理する
文字列の違いまで含めて、4種類を確認します。
### WNDCLASSA
```text
WNDCLASS
基本版
A
char系・Windowsコードページ
```
```cpp
WNDCLASSA windowClass{};
windowClass.lpszClassName =
"SampleWindowClass";
RegisterClassA(
&windowClass
);
```
### WNDCLASSW
```text
WNDCLASS
基本版
W
wchar_t系・UTF-16
```
```cpp
WNDCLASSW windowClass{};
windowClass.lpszClassName =
L"SampleWindowClass";
RegisterClassW(
&windowClass
);
```
### WNDCLASSEXA
```text
WNDCLASSEX
拡張版
A
char系・Windowsコードページ
```
```cpp
WNDCLASSEXA windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXA);
windowClass.lpszClassName =
"SampleWindowClass";
RegisterClassExA(
&windowClass
);
```
### WNDCLASSEXW
```text
WNDCLASSEX
拡張版
W
wchar_t系・UTF-16
```
```cpp
WNDCLASSEXW windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXW);
windowClass.lpszClassName =
L"SampleWindowClass";
RegisterClassExW(
&windowClass
);
```
新規コードでは、最後の`WNDCLASSEXW`を使うのが分かりやすいでしょう。
---
## 6.AもWも付いていないWNDCLASSEXは何なのか
ここまでで、4種類の違いは説明できました。
```text
WNDCLASS / WNDCLASSEX
基本版か拡張版か
A / W
使用する文字列の種類
```
ところが、実際のサンプルコードを見ると、新しい疑問が出てきます。
次のように、末尾の`A`や`W`が付いていない型が使われていることがあるからです。
```cpp
WNDCLASSEX windowClass{};
```
関数名も同様です。
```cpp
RegisterClassEx(
&windowClass
);
```
```cpp
CreateWindowEx(
// 引数
);
```
これは、第5の構造体や第3の関数が存在するという意味ではありません。
末尾のない名前は、プリプロセッサによってA版またはW版へ置き換えられます。
この切り替えの条件として使われるのが、`UNICODE`というプリプロセッサマクロです。
### UNICODEマクロとは
`UNICODE`は、末尾のないWin32 APIの型名や関数名を、W版へ切り替えるために使われるマクロです。
プリプロセッサマクロとは、C++のコードを本格的にコンパイルする前に、名前の置き換えや条件分岐を行う仕組みです。
Windowsのヘッダーでは、概念的に次のような切り替えが行われています。
```cpp
#ifdef UNICODE
#define WNDCLASSEX WNDCLASSEXW
#define RegisterClassEx RegisterClassExW
#define CreateWindowEx CreateWindowExW
#else
#define WNDCLASSEX WNDCLASSEXA
#define RegisterClassEx RegisterClassExA
#define CreateWindowEx CreateWindowExA
#endif
```
実際のWindowsヘッダーでは、型の別名や関数マクロが個別に定義されていますが、考え方は同じです。
つまり、`UNICODE`が定義されているかどうかによって、末尾なしの名前がA版・W版のどちらになるかが決まります。
### UNICODEが定義されている場合
```text
WNDCLASS
→ WNDCLASSW
WNDCLASSEX
→ WNDCLASSEXW
RegisterClassEx
→ RegisterClassExW
CreateWindowEx
→ CreateWindowExW
```
### UNICODEが定義されていない場合
```text
WNDCLASS
→ WNDCLASSA
WNDCLASSEX
→ WNDCLASSEXA
RegisterClassEx
→ RegisterClassExA
CreateWindowEx
→ CreateWindowExA
```
では、この`UNICODE`はどこで定義されるのでしょうか。
ここで初めて、Visual Studioのプロジェクト設定にある次の項目が登場します。
```text
Unicode文字セットを使用する
マルチバイト文字セットを使用する
```
この設定は、先ほどまで説明していた4種類そのものを直接選択する画面ではありません。
末尾のない`WNDCLASSEX`や`RegisterClassEx`を、A版とW版のどちらへ切り替えるかを決める設定です。
---
## 7.Visual Studioの「文字セット」設定との関係
Visual StudioのC++プロジェクトには、次の設定があります。
```text
文字セット
```
一般的には、次の手順で確認できます。
```text
ソリューション エクスプローラー
↓
対象のプロジェクトを右クリック
↓
プロパティ
↓
構成プロパティ
↓
詳細設定
↓
文字セット
```
Visual Studioやプロジェクトの種類によっては、`構成プロパティ > 全般`に表示される場合もあります。
設定には、主に次の選択肢があります。
```text
Unicode文字セットを使用する
マルチバイト文字セットを使用する
設定なし
```
この設定は、末尾のないWin32 APIの型名や関数名をA版・W版のどちらとしてコンパイルするかに関係します。
---
### Unicode文字セットを使用する場合
Visual Studioで次を選択します。
```text
Unicode文字セットを使用する
```
この設定では、プロジェクトに主に次のプリプロセッサマクロが定義されます。
```cpp
UNICODE
_UNICODE
```
`_MBCS`は定義されない構成になります。
Windowsのヘッダーは、主に`UNICODE`マクロを見てA版とW版を切り替えます。
そのため、次のコードは、
```cpp
WNDCLASSEX windowClass{};
RegisterClassEx(
&windowClass
);
```
実質的に次の組み合わせになります。
```cpp
WNDCLASSEXW windowClass{};
RegisterClassExW(
&windowClass
);
```
`CreateWindowEx`もW版になります。
```text
CreateWindowEx
→ CreateWindowExW
```
したがって、文字列にはワイド文字列が必要です。
```cpp
WNDCLASSEX windowClass{};
windowClass.lpszClassName =
L"SampleWindowClass";
```
次のコードは型が一致しません。
```cpp
WNDCLASSEX windowClass{};
windowClass.lpszClassName =
"SampleWindowClass";
```
Unicode設定では、`WNDCLASSEX`が`WNDCLASSEXW`になっているためです。
```text
必要な型
LPCWSTR
const wchar_t*
渡している型
const char*
```
---
### マルチバイト文字セットを使用する場合
Visual Studioで次を選択します。
```text
マルチバイト文字セットを使用する
```
この設定では、主に次のマクロが定義されます。
```cpp
_MBCS
```
通常、`UNICODE`と`_UNICODE`は定義されません。
そのため、末尾のないWin32 APIの名前はA版になります。
```text
WNDCLASS
→ WNDCLASSA
WNDCLASSEX
→ WNDCLASSEXA
RegisterClassEx
→ RegisterClassExA
CreateWindowEx
→ CreateWindowExA
```
次のコードは、
```cpp
WNDCLASSEX windowClass{};
RegisterClassEx(
&windowClass
);
```
実質的に次の組み合わせになります。
```cpp
WNDCLASSEXA windowClass{};
RegisterClassExA(
&windowClass
);
```
`lpszClassName`は`LPCSTR`になるため、通常の文字列を使用します。
```cpp
windowClass.lpszClassName =
"SampleWindowClass";
```
---
### 設定なしの場合
文字セットを`設定なし`にすると、その設定からは`UNICODE`、`_UNICODE`、`_MBCS`が定義されません。
`UNICODE`が定義されていないため、末尾のないWin32 API名は基本的にA版になります。
```text
WNDCLASSEX
→ WNDCLASSEXA
```
ただし、ソースコードや別のプロジェクト設定で`UNICODE`を手動定義している場合は、その定義が使われます。
---
### 文字セット設定による変化
| Visual Studioの設定 | 主なマクロ | WNDCLASSEX | RegisterClassEx | CreateWindowEx |
| ---------------- | ----------------- | ----------- | ---------------- | --------------- |
| Unicode文字セット | UNICODE、\_UNICODE | WNDCLASSEXW | RegisterClassExW | CreateWindowExW |
| マルチバイト文字セット | \_MBCS | WNDCLASSEXA | RegisterClassExA | CreateWindowExA |
| 設定なし | 通常はいずれもなし | WNDCLASSEXA | RegisterClassExA | CreateWindowExA |
### UNICODEと\_UNICODEの違い
「Unicode文字セットを使用する」を選ぶと、通常は`UNICODE`と`_UNICODE`の両方が定義されます。
名前は似ていますが、主な役割が異なります。
```text
UNICODE
Windowsヘッダーが使用
Win32 APIのA版・W版を切り替える
_UNICODE
CランタイムやMFCなどが使用
TCHAR系の機能を切り替える
_MBCS
マルチバイト文字セット用の機能に影響する
```
`WNDCLASSEX`、`RegisterClassEx`、`CreateWindowEx`などの切り替えに直接関係するのは`UNICODE`です。
Visual Studioの文字セット設定を使うと、`UNICODE`と`_UNICODE`が矛盾しないようにまとめて設定されます。
---
## 8.TEXTマクロとの関係
末尾のない型名や関数名と一緒に、次のようなコードを見かけることがあります。
```cpp
TEXT("SampleWindowClass")
```
または、次の書き方です。
```cpp
_T("SampleWindowClass")
```
これらは、プロジェクト設定に応じて文字列の型を切り替えるためのマクロです。
### Unicode文字セットの場合
```cpp
TEXT("SampleWindowClass")
```
は、概念的には次の文字列になります。
```cpp
L"SampleWindowClass"
```
### マルチバイト文字セットの場合
```cpp
TEXT("SampleWindowClass")
```
は、通常の文字列になります。
```cpp
"SampleWindowClass"
```
したがって、末尾のない型と関数を使う場合は、文字列にも`TEXT`を使うとA/Wをまとめて切り替えられます。
```cpp
WNDCLASSEX windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEX);
windowClass.lpszClassName =
TEXT("SampleWindowClass");
RegisterClassEx(
&windowClass
);
CreateWindowEx(
0,
TEXT("SampleWindowClass"),
TEXT("Sample Window"),
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
```
この書き方は、同じソースコードをUnicode版とマルチバイト版の両方でビルドしたい場合に使われます。
ただし、新しくW版専用のコードを書くなら、次のように明示した方が読みやすい場合もあります。
```cpp
WNDCLASSEXW windowClass{};
windowClass.lpszClassName =
L"SampleWindowClass";
RegisterClassExW(
&windowClass
);
```
---
## 9.重要:「Unicode文字セット」はソースファイルの保存設定ではない
ここは非常に間違えやすいところです。
Visual Studioの次の設定は、
```text
文字セット
Unicode文字セットを使用する
```
`.cpp`や`.h`ファイルをUTF-8形式で保存する設定ではありません。
この設定が主に行うことは、次のマクロを定義することです。
```cpp
UNICODE
_UNICODE
```
そして、末尾のないWin32 APIの型名や関数名をW版へ切り替えます。
```text
WNDCLASSEX
→ WNDCLASSEXW
RegisterClassEx
→ RegisterClassExW
CreateWindowEx
→ CreateWindowExW
```
一方、ソースファイルの保存形式は別の設定です。
```text
プロジェクトの文字セット
Win32 APIをA版・W版のどちらにするか
ソースファイルのエンコーディング
.cppや.hをどのバイト列で保存するか
```
### ソースファイルのエンコーディング
ソースコードは、例えば次の形式で保存できます。
```text
UTF-8
UTF-8 with BOM
Shift_JIS系のコードページ
UTF-16
```
コンパイラにソースファイルをUTF-8として解釈させる設定には、次のオプションなどがあります。
```text
/utf-8
/source-charset:utf-8
```
これは、Visual Studioの「Unicode文字セットを使用する」とは別の話です。
### 2つは独立している
例えば、次のような組み合わせも理屈上は存在します。
```text
プロジェクトの文字セット
Unicode文字セット
ソースファイル
Shift_JIS系で保存
```
逆に、次の組み合わせもあり得ます。
```text
プロジェクトの文字セット
マルチバイト文字セット
ソースファイル
UTF-8で保存
```
ソースファイルがUTF-8だからといって、`CreateWindowEx`が自動的に`CreateWindowExW`になるわけではありません。
また、プロジェクトをUnicode文字セットにしたからといって、`.cpp`ファイルが自動的にUTF-8へ変換されるわけでもありません。
この2つは分けて考える必要があります。
---
## 10.プロジェクト設定を変更するときの注意
Visual Studioのプロジェクトプロパティは、構成とプラットフォームごとに値を持つ場合があります。
設定画面の上部には、次の項目があります。
```text
構成
Debug
Release
すべての構成
プラットフォーム
Win32
x64
すべてのプラットフォーム
```
例えば、`Debug | x64`を選んだ状態で文字セットを変更すると、Release側には反映されない場合があります。
プロジェクト全体をUnicodeへ統一するなら、次のように設定します。
```text
構成
すべての構成
プラットフォーム
すべてのプラットフォーム
```
その上で、文字セットを変更します。
```text
文字セット
Unicode文字セットを使用する
```
---
## 11.よくあるエラー
### エラー1:LPCWSTRにconst char\*を代入できない
Unicode文字セットのプロジェクトで、次のコードを書いたとします。
```cpp
WNDCLASSEX windowClass{};
windowClass.lpszClassName =
"SampleWindowClass";
```
Unicode設定では、`WNDCLASSEX`は`WNDCLASSEXW`になります。
そのため、`lpszClassName`が要求する型は`LPCWSTR`です。
```text
要求される型
LPCWSTR
const wchar_t*
渡している型
const char*
```
修正するには、ワイド文字列を使います。
```cpp
windowClass.lpszClassName =
L"SampleWindowClass";
```
末尾なしの書き方を維持するなら、`TEXT`も使えます。
```cpp
windowClass.lpszClassName =
TEXT("SampleWindowClass");
```
---
### エラー2:WNDCLASSEXWとRegisterClassExを混ぜる
次のコードを考えます。
```cpp
WNDCLASSEXW windowClass{};
RegisterClassEx(
&windowClass
);
```
プロジェクトがUnicode文字セットなら、`RegisterClassEx`は`RegisterClassExW`になるため型が一致します。
しかし、マルチバイト文字セットの場合は、次の組み合わせになります。
```cpp
WNDCLASSEXW windowClass{};
RegisterClassExA(
&windowClass
);
```
`RegisterClassExA`が要求するのは`WNDCLASSEXA*`なので、型が一致しません。
```text
必要
const WNDCLASSEXA*
実際
WNDCLASSEXW*
```
修正方法は、W版へ統一することです。
```cpp
WNDCLASSEXW windowClass{};
RegisterClassExW(
&windowClass
);
```
または、すべて末尾なしへ統一します。
```cpp
WNDCLASSEX windowClass{};
RegisterClassEx(
&windowClass
);
```
混ぜないことが重要です。
---
### エラー3:WNDCLASSEXAとRegisterClassExWを混ぜる
逆の組み合わせでも同じ問題が起きます。
```cpp
WNDCLASSEXA windowClass{};
RegisterClassExW(
&windowClass
);
```
A版の構造体はA版の関数へ渡します。
```cpp
WNDCLASSEXA windowClass{};
RegisterClassExA(
&windowClass
);
```
---
### エラー4:CreateWindowExWへ普通の文字列を渡す
次のコードは型が一致しません。
```cpp
CreateWindowExW(
0,
"SampleWindowClass",
"Sample Window",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
```
`CreateWindowExW`は`LPCWSTR`を要求します。
文字列をワイド文字列にします。
```cpp
CreateWindowExW(
0,
L"SampleWindowClass",
L"Sample Window",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
```
---
### エラー5:キャストで無理やり直す
次のようにキャストすると、コンパイルエラーだけが消える場合があります。
```cpp
const char* className =
"SampleWindowClass";
windowClass.lpszClassName =
reinterpret_cast(
className
);
```
しかし、これは文字コード変換ではありません。
`char`のバイト列を、そのまま`wchar_t`の配列だと思って読み込ませているだけです。
```text
キャスト
型の見方を変える
文字コード変換
データの並びを別の文字表現へ変換する
```
A版文字列をW版文字列へ変換する必要がある場合は、`MultiByteToWideChar`などを使用します。
この変換については、別の記事で詳しく扱います。
---
## 12.どの書き方に統一するべきか
主な書き方は2種類あります。
### 方法1:末尾なしの名前で統一する
プロジェクト設定に応じて、A版とW版を切り替える方法です。
```cpp
WNDCLASSEX windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEX);
windowClass.lpszClassName =
TEXT("SampleWindowClass");
RegisterClassEx(
&windowClass
);
```
利点は、プロジェクト設定を変更するだけでA版とW版を切り替えられることです。
ただし、型が設定によって変わるため、初学者には実際に何を使っているのか分かりにくい場合があります。
### 方法2:W版を明示して統一する
新規コードでは、W版を明示する方法が分かりやすいでしょう。
```cpp
WNDCLASSEXW windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXW);
windowClass.lpszClassName =
L"SampleWindowClass";
RegisterClassExW(
&windowClass
);
```
この方法なら、Visual Studioの文字セット設定を見なくても、コードを読んだだけで使用する型が分かります。
```text
WNDCLASSEXW
W版
RegisterClassExW
W版
L"文字列"
wchar_t文字列
```
既存コードが`TCHAR`や末尾なしのAPIを多く使っている場合は、無理に書き換えず、プロジェクト全体の方針へ合わせます。
新しく学習用・教材用のコードを書くなら、次の方針が特に分かりやすいでしょう。
```text
Visual Studio
Unicode文字セットを使用する
Win32 API
W版を明示する
```
---
## 13.WNDCLASSEXWを使った最小例
最後に、W版へ統一した最小例を示します。
```cpp
#include
namespace
{
constexpr wchar_t WINDOW_CLASS_NAME[] =
L"SampleWindowClass";
}
LRESULT CALLBACK WindowProc(
HWND hWnd,
UINT message,
WPARAM wParam,
LPARAM lParam
)
{
switch (message)
{
case WM_DESTROY:
PostQuitMessage(0);
return 0;
}
return DefWindowProcW(
hWnd,
message,
wParam,
lParam
);
}
int WINAPI wWinMain(
HINSTANCE hInstance,
HINSTANCE,
PWSTR,
int nCmdShow
)
{
WNDCLASSEXW windowClass{};
windowClass.cbSize =
sizeof(WNDCLASSEXW);
windowClass.style =
CS_HREDRAW |
CS_VREDRAW;
windowClass.lpfnWndProc =
WindowProc;
windowClass.hInstance =
hInstance;
windowClass.hIcon =
LoadIconW(
nullptr,
IDI_APPLICATION
);
windowClass.hCursor =
LoadCursorW(
nullptr,
IDC_ARROW
);
windowClass.hbrBackground =
reinterpret_cast(
COLOR_WINDOW + 1
);
windowClass.lpszClassName =
WINDOW_CLASS_NAME;
windowClass.hIconSm =
LoadIconW(
nullptr,
IDI_APPLICATION
);
if (RegisterClassExW(
&windowClass
) == 0)
{
return -1;
}
HWND hWnd =
CreateWindowExW(
0,
WINDOW_CLASS_NAME,
L"Win32 API Sample",
WS_OVERLAPPEDWINDOW,
CW_USEDEFAULT,
CW_USEDEFAULT,
1280,
720,
nullptr,
nullptr,
hInstance,
nullptr
);
if (hWnd == nullptr)
{
return -1;
}
ShowWindow(
hWnd,
nCmdShow
);
MSG message{};
while (GetMessageW(
&message,
nullptr,
0,
0
) > 0)
{
TranslateMessage(
&message
);
DispatchMessageW(
&message
);
}
return static_cast(
message.wParam
);
}
```
このコードでは、次の要素をすべてW版へ統一しています。
```cpp
WNDCLASSEXW
RegisterClassExW
CreateWindowExW
DefWindowProcW
GetMessageW
DispatchMessageW
```
文字列もワイド文字列です。
```cpp
L"SampleWindowClass"
L"Win32 API Sample"
```
---
## 14.まとめ
`WNDCLASSA`、`WNDCLASSW`、`WNDCLASSEXA`、`WNDCLASSEXW`の違いは、次の2軸で整理できます。
```text
WNDCLASS
基本版
WNDCLASSEX
cbSizeとhIconSmを追加した拡張版
```
```text
A
char系
Windowsコードページ
W
wchar_t系
UTF-16
```
4種類を整理すると、次のようになります。
| 構造体 | 基本・拡張 | 文字列 |
| ----------- | ----- | ------------------ |
| WNDCLASSA | 基本版 | char・Windowsコードページ |
| WNDCLASSW | 基本版 | wchar\_t・UTF-16 |
| WNDCLASSEXA | 拡張版 | char・Windowsコードページ |
| WNDCLASSEXW | 拡張版 | wchar\_t・UTF-16 |
対応する登録関数もそろえます。
| 構造体 | 登録関数 |
| ----------- | ---------------- |
| WNDCLASSA | RegisterClassA |
| WNDCLASSW | RegisterClassW |
| WNDCLASSEXA | RegisterClassExA |
| WNDCLASSEXW | RegisterClassExW |
末尾のない`WNDCLASSEX`や`RegisterClassEx`は、Visual Studioの「文字セット」設定と`UNICODE`マクロによってA版・W版へ切り替わります。
```text
Unicode文字セットを使用する
↓
WNDCLASSEXW
RegisterClassExW
CreateWindowExW
```
```text
マルチバイト文字セットを使用する
↓
WNDCLASSEXA
RegisterClassExA
CreateWindowExA
```
また、Visual Studioの「Unicode文字セットを使用する」は、ソースコードをUTF-8で保存する設定ではありません。
```text
プロジェクトの文字セット
Win32 APIのA/Wを切り替える
ソースファイルのエンコーディング
.cppや.hをUTF-8などのどの形式で保存するか
```
新しくWin32アプリケーションを作る場合は、次の構成へ統一すると分かりやすくなります。
```text
Visual Studio
Unicode文字セットを使用する
```
```cpp
WNDCLASSEXW
RegisterClassExW
CreateWindowExW
L"文字列"
```
エラーが出たときは、次の4点を確認します。
```text
1. WNDCLASSかWNDCLASSEXか
2. A版かW版か
3. Visual Studioの文字セット設定はどちらか
4. 構造体・関数・文字列が同じ系統にそろっているか
```
`std::string`、`std::wstring`、`LPSTR`、`LPCWSTR`、UTF-8とUTF-16の変換については、次の記事で詳しく扱います。
> 次の記事:C++とWin32 APIの文字列型を整理する――string・wstring・LPSTR・LPCWSTR・UTF-8・UTF-16
### XMFLOATなのかXMVECTORなのか問題
URL: https://www.geekjp.com/aboutxmvector/
Last updated: 2026-08-01T12:19:05.000Z
## DirectXMathの使い分けを調べてみた
DirectXMathを使い始めると、最初に迷いやすいのが`XMVECTOR`と`XMFLOAT3`の使い分けです。
どちらも3次元ベクトルを扱えそうに見えますが、DirectXMathの関数の引数などを見るとどうやらなんかしらの使い分けがありそうです。
公式のドキュメントなどを参照してみると、基本方針は次のとおりの様です。
> **`XMFLOAT3`はデータを保存するための型、`XMVECTOR`は計算するための型として使う。**
クラスや構造体のメンバ変数には`XMFLOAT3`を使い、計算が必要になったら`XMLoadFloat3()`で`XMVECTOR`へ読み込みます。計算が終わったら、`XMStoreFloat3()`で結果を`XMFLOAT3`へ戻します。
```text
XMFLOAT3に保存
↓ XMLoadFloat3()
XMVECTORで計算
↓ XMStoreFloat3()
XMFLOAT3に保存
```
そこで、この記事では`XMVECTOR`と`XMFLOAT3`の基本的な違いから、`XMLoadFloat3()`と`XMStoreFloat3()`、ゲーム内での移動計算、`Transform`クラスでの設計例まで順番に説明します。
記事の最後には、公式ドキュメントでよく見かける`FXMVECTOR`、`GXMVECTOR`、`HXMVECTOR`、`CXMVECTOR`、`XM_CALLCONV`についての付録も用意しています。これらはおまけとして調べてみましたので、特に気にせずXMVECTORのシノニムだと思って使って良いと思います(はじめのうちは)。
## この記事でわかること
- `XMVECTOR`と`XMFLOAT3`の違い
- 保存用と計算用を分ける理由
- `XMLoadFloat3()`と`XMStoreFloat3()`の使い方
- ゲームオブジェクトの位置を更新する実装例
- 位置・方向・法線を行列変換するときの違い
- `Transform`クラスのメンバ型と関数設計
- 付録:`FXMVECTOR`系と`XM_CALLCONV`が必要な理由
- 頂点バッファや定数バッファでの使い方
---
## XMVECTORとXMFLOAT3の違い
まずは、それぞれの役割を比較します。
| 項目 | XMVECTOR | XMFLOAT3 |
| --------- | ------------------ | ------------------------ |
| 主な用途 | ベクトル計算 | データの保存 |
| 要素数 | 4要素 | 3要素 |
| SIMD演算 | DirectXMath関数で利用する | そのままでは利用しない |
| メンバへのアクセス | 基本的に専用関数を使う | .x、.y、.zでアクセスできる |
| クラスのメンバ | 一時的な計算値向き | 状態の保持に向く |
| 頂点データ | 通常は使わない | 位置や法線に使いやすい |
| ファイル保存 | 扱いにくい | 扱いやすい |
| 関数内の中間計算 | 向いている | DirectXMath関数を使うにはロードが必要 |
簡単に表現するなら、次のように考えるとわかりやすいでしょう。
> **`XMFLOAT3`は倉庫、`XMVECTOR`は作業台。**
ゲームオブジェクトの位置は`XMFLOAT3`として倉庫に保存しておきます。移動や回転などの計算が必要になったときだけ、`XMVECTOR`という作業台へ持ってきて処理します。
つまり、ベクトルの3または4要素をまるっと一度に計算する場面では、XMVECTOR使ったほうが、効率いいし速そうだよ。ってことです。
---
## XMVECTORとは
`XMVECTOR`は、DirectXMathライブラリでベクトル演算を行うための中心的な型です。
```cpp
#include
using namespace DirectX;
XMVECTOR a = XMVectorSet(1.0f, 2.0f, 3.0f, 0.0f);
XMVECTOR b = XMVectorSet(4.0f, 5.0f, 6.0f, 0.0f);
XMVECTOR result = XMVectorAdd(a, b);
```
`XMVECTOR`は、4個の32ビット値をまとめて扱います。
```text
x, y, z, w
```
SSEを使用する環境では`__m128`、ARM NEONを使用する環境では`float32x4_t`など、対象環境に応じたSIMD型として定義されます。
DirectXMathの現在のヘッダーでは、概念的に次のように切り替えられています。
```cpp
// SSEを使用する環境
using XMVECTOR = __m128;
// ARM NEONを使用する環境
using XMVECTOR = float32x4_t;
```
そのため、`XMVECTOR`を普通の構造体だと考えて、常に次のようなアクセスができるとは限りません。
```cpp
// 基本的には、このような直接アクセスを前提にしない
vector.x = 10.0f;
```
要素を取得するときは、DirectXMathのアクセサ関数を使用します。
```cpp
float x = XMVectorGetX(vector);
float y = XMVectorGetY(vector);
float z = XMVectorGetZ(vector);
float w = XMVectorGetW(vector);
```
値を変更するときも、専用関数を使用できます。
```cpp
vector = XMVectorSetX(vector, 10.0f);
vector = XMVectorSetY(vector, 20.0f);
```
ただし、個々の成分を何度も取り出して計算するのであれば、そもそも`XMVECTOR`を使う意味が薄くなります。`XMVECTOR`は、DirectXMathのベクトル関数を使って、複数の成分をまとめて処理するための型です。
---
## XMFLOAT2・XMFLOAT3・XMFLOAT4とは
`XMFLOAT`系は、浮動小数点数をメモリ上に保存するための構造体です。
代表的な型には、次のものがあります。
```cpp
XMFLOAT2 uv;
XMFLOAT3 position;
XMFLOAT4 color;
XMFLOAT4 quaternion;
XMFLOAT4X4 matrix;
```
`XMFLOAT3`は、実質的に次のような構造です。
```cpp
struct XMFLOAT3
{
float x;
float y;
float z;
};
```
そのため、通常のC++の構造体と同じ感覚で扱えます。
```cpp
XMFLOAT3 position(10.0f, 20.0f, 30.0f);
position.x += 5.0f;
position.y = 0.0f;
```
`XMFLOAT3`が向いている主な用途は次のとおりです。
- ゲームオブジェクトの位置・回転・スケールの保持
- 頂点バッファの位置・法線データ
- ファイルへの保存と読み込み
- エディターやデバッグ画面への表示
- ネットワーク送信用のデータ
- `XMVECTOR`で計算した結果の格納
`XMFLOAT3`は保存しやすく、メンバへ直接アクセスできます。ただし、`XMVectorAdd()`や`XMVector3Normalize()`などの関数へ、そのまま渡すことはできません。
```cpp
XMFLOAT3 position(1.0f, 2.0f, 3.0f);
// XMFLOAT3をそのまま渡すことはできない
// XMVECTOR result = XMVector3Normalize(position);
```
DirectXMathのベクトル関数で計算するときは、`XMVECTOR`へロードします。
---
## XMLoadFloat3とXMStoreFloat3
`XMFLOAT3`と`XMVECTOR`の間では、ロード関数とストア関数を使用します。
### XMFLOAT3からXMVECTORへ読み込む
```cpp
XMFLOAT3 position(1.0f, 2.0f, 3.0f);
XMVECTOR positionVector = XMLoadFloat3(&position);
```
`XMLoadFloat3()`は、`XMFLOAT3`の`x`、`y`、`z`を`XMVECTOR`へ読み込みます。
`XMFLOAT3`には`w`が存在しないため、ロード後の`w`成分は`0.0f`になります。
```text
XMFLOAT3 XMVECTOR
x = 1.0 → x = 1.0
x = 2.0 → y = 2.0
z = 3.0 → z = 3.0
w = 0.0
```
### XMVECTORからXMFLOAT3へ保存する
```cpp
XMVECTOR positionVector = XMVectorSet(1.0f, 2.0f, 3.0f, 0.0f);
XMFLOAT3 position;
XMStoreFloat3(&position, positionVector);
```
`XMStoreFloat3()`は、`XMVECTOR`の`x`、`y`、`z`を`XMFLOAT3`へ書き込みます。`w`成分は保存されません。
### 基本的なデータの流れ
```cpp
XMFLOAT3 position(1.0f, 2.0f, 3.0f);
XMFLOAT3 velocity(4.0f, 0.0f, 0.0f);
// 1. 保存用データを計算用の型へロード
XMVECTOR p = XMLoadFloat3(&position);
XMVECTOR v = XMLoadFloat3(&velocity);
// 2. XMVECTORで計算
p = XMVectorAdd(p, v);
// 3. 計算結果を保存用データへストア
XMStoreFloat3(&position, p);
```
これが、DirectXMathを使うときの基本パターンです。
---
## プレイヤーの位置を更新する実装例
ゲーム内で実際に使う形にすると、次のようになります。
```cpp
#include
class Player
{
private:
DirectX::XMFLOAT3 position_;
DirectX::XMFLOAT3 velocity_;
public:
Player()
: position_(0.0f, 0.0f, 0.0f),
velocity_(3.0f, 0.0f, 0.0f)
{
}
void Update(float deltaTime)
{
using namespace DirectX;
XMVECTOR position = XMLoadFloat3(&position_);
XMVECTOR velocity = XMLoadFloat3(&velocity_);
// position = velocity * deltaTime + position
position = XMVectorMultiplyAdd(
velocity,
XMVectorReplicate(deltaTime),
position
);
XMStoreFloat3(&position_, position);
}
const DirectX::XMFLOAT3& GetPosition() const
{
return position_;
}
};
```
このクラスでは、位置と速度を`XMFLOAT3`で保持しています。
```cpp
DirectX::XMFLOAT3 position_;
DirectX::XMFLOAT3 velocity_;
```
`Update()`内では、計算が必要な間だけ`XMVECTOR`へロードしています。
```cpp
XMVECTOR position = XMLoadFloat3(&position_);
XMVECTOR velocity = XMLoadFloat3(&velocity_);
```
計算が終わったら、位置だけをメンバ変数へ戻します。
```cpp
XMStoreFloat3(&position_, position);
```
このように、**長期間保持するデータと、一時的な計算データを分ける**のが基本です。
---
## ロードとストアは計算の前後にまとめる
次のコードは動作しますが、ロードとストアを何度も繰り返しています。
```cpp
XMVECTOR position = XMLoadFloat3(&position_);
position = XMVectorAdd(position, XMLoadFloat3(&velocity_));
XMStoreFloat3(&position_, position);
position = XMLoadFloat3(&position_);
position = XMVectorAdd(position, XMLoadFloat3(&acceleration_));
XMStoreFloat3(&position_, position);
```
できるだけ、計算の最初に必要な値をロードし、計算が完了してからまとめてストアします。
```cpp
XMVECTOR position = XMLoadFloat3(&position_);
XMVECTOR velocity = XMLoadFloat3(&velocity_);
XMVECTOR acceleration = XMLoadFloat3(&acceleration_);
position = XMVectorAdd(position, velocity);
position = XMVectorAdd(position, acceleration);
XMStoreFloat3(&position_, position);
```
`XMVECTOR`は、レジスタ上で連続した計算を行いやすいように設計されています。途中で何度もメモリへ戻すより、必要な計算をまとめてから結果を保存する方が、コードの意図も明確になります。
ただし、ロードとストアを1回でも行ったら遅い、という意味ではありません。最適化では、実際の処理時間をReleaseビルドで計測することが重要です。
---
## XMVECTORのw成分は何に使うのか
`XMVECTOR`は、3次元ベクトルを扱う場合でも`x`、`y`、`z`、`w`の4成分を持ちます。
```cpp
XMVECTOR value = XMVectorSet(x, y, z, w);
```
一般的な同次座標では、位置と方向を次のように表します。
| 用途 | x | y | z | w |
| ------- | -- | -- | -- | - |
| 位置 | px | py | pz | 1 |
| 方向 | dx | dy | dz | 0 |
| 色 | r | g | b | a |
| クォータニオン | x | y | z | w |
ただし、DirectXMathの関数によっては、入力された`w`をそのまま使わず、関数側で位置または方向として扱います。
### 位置を変換するXMVector3TransformCoord
```cpp
XMVECTOR worldPosition =
XMVector3TransformCoord(localPosition, worldMatrix);
```
`XMVector3TransformCoord()`は入力の`w`成分を無視し、`w = 1.0f`として変換します。そのため、行列の平行移動成分の影響を受けます。
返されるベクトルは、結果が`w = 1.0f`になるように射影除算されます。
### 方向や法線を変換するXMVector3TransformNormal
```cpp
XMVECTOR worldDirection =
XMVector3TransformNormal(localDirection, worldMatrix);
```
`XMVector3TransformNormal()`は、方向ベクトルや法線ベクトルを変換するときに使います。平行移動成分は計算に含まれません。
したがって、用途によって使い分けます。
```text
頂点の位置 → XMVector3TransformCoord
移動方向 → XMVector3TransformNormal
法線ベクトル → XMVector3TransformNormal
```
なお、非一様スケールを含む行列で法線を正しく変換する場合は、ワールド行列そのものではなく、逆転置行列を使用する必要があります。
---
## Transformクラスではどう設計するか
ゲームエンジンの`Transform`クラスでは、位置・回転・スケールを長期間保持します。
そのため、メンバ変数には`XMFLOAT3`を使用する設計が扱いやすいでしょう。
```cpp
#pragma once
#include
class Transform
{
private:
DirectX::XMFLOAT3 position_;
DirectX::XMFLOAT3 rotation_;
DirectX::XMFLOAT3 scale_;
public:
Transform()
: position_(0.0f, 0.0f, 0.0f),
rotation_(0.0f, 0.0f, 0.0f),
scale_(1.0f, 1.0f, 1.0f)
{
}
const DirectX::XMFLOAT3& GetPosition() const
{
return position_;
}
DirectX::XMVECTOR GetPositionVector() const
{
return DirectX::XMLoadFloat3(&position_);
}
void SetPosition(float x, float y, float z)
{
position_ = DirectX::XMFLOAT3(x, y, z);
}
DirectX::XMMATRIX GetWorldMatrix() const
{
using namespace DirectX;
const XMMATRIX scale = XMMatrixScalingFromVector(
XMLoadFloat3(&scale_)
);
const XMMATRIX rotation = XMMatrixRotationRollPitchYawFromVector(
XMLoadFloat3(&rotation_)
);
const XMMATRIX translation = XMMatrixTranslationFromVector(
XMLoadFloat3(&position_)
);
return scale * rotation * translation;
}
};
```
この設計では、用途に応じて2種類の取得方法を用意しています。
```cpp
// 保存データとして参照したい
const XMFLOAT3& GetPosition() const;
// DirectXMathで計算したい
XMVECTOR GetPositionVector() const;
```
この形なら、ゲームロジック側では保存用の`XMFLOAT3`として位置を確認でき、数学処理側では`GetPositionVector()`から計算用の`XMVECTOR`を取得できます。
`XMVECTOR`を直接受け取る自作関数の書き方は、記事末尾の付録で説明します。
---
## 頂点バッファではXMFLOATを使う
頂点データは、連続したメモリ上に大量に並べてGPUへ送ります。
そのため、通常は`XMVECTOR`ではなく`XMFLOAT`系を使用します。
```cpp
struct Vertex
{
DirectX::XMFLOAT3 position;
DirectX::XMFLOAT3 normal;
DirectX::XMFLOAT2 uv;
};
```
頂点データの位置をCPU側で変換するときは、ロード・計算・ストアを行います。
```cpp
void TransformVertex(
Vertex& vertex,
const DirectX::XMMATRIX& matrix
) noexcept
{
using namespace DirectX;
XMVECTOR position = XMLoadFloat3(&vertex.position);
position = XMVector3TransformCoord(position, matrix);
XMStoreFloat3(&vertex.position, position);
XMVECTOR normal = XMLoadFloat3(&vertex.normal);
normal = XMVector3TransformNormal(normal, matrix);
normal = XMVector3Normalize(normal);
XMStoreFloat3(&vertex.normal, normal);
}
```
実際の描画では、毎フレーム全頂点をCPUで変換するより、頂点シェーダーで変換する設計が一般的です。この例は、`XMFLOAT3`と`XMVECTOR`の役割を示すためのものです。
---
## 定数バッファではC++側とHLSL側の配置を合わせる
定数バッファへ値を送るときも、保存用の構造体には`XMFLOAT4`や`XMFLOAT4X4`を使用できます。
```cpp
struct SceneConstantBuffer
{
DirectX::XMFLOAT4X4 world;
DirectX::XMFLOAT4 color;
DirectX::XMFLOAT3 lightDirection;
float padding;
};
```
行列は`XMMATRIX`で計算し、`XMFLOAT4X4`へ保存します。
```cpp
DirectX::XMMATRIX world = transform.GetWorldMatrix();
SceneConstantBuffer buffer{};
DirectX::XMStoreFloat4x4(
&buffer.world,
DirectX::XMMatrixTranspose(world)
);
```
HLSLの定数バッファでは、変数が16バイト境界をまたがないように配置されます。そのため、C++側の構造体とHLSL側の`cbuffer`で、サイズと並びを対応させる必要があります。
```hlsl
cbuffer SceneConstantBuffer : register(b0)
{
float4x4 world;
float4 color;
float3 lightDirection;
float padding;
};
```
`XMFLOAT3`の直後に`float`を置く形はよく使われますが、常に機械的に`padding`を追加すればよいわけではありません。HLSL側の変数順序とパッキング規則を確認し、C++側と一致させます。
---
## XMFLOAT3Aとは
DirectXMathには、`XMFLOAT3`を16バイト境界へアラインした`XMFLOAT3A`もあります。
```cpp
DirectX::XMFLOAT3A alignedPosition;
```
`XMFLOAT3A`のロードとストアには、対応する関数を使用します。
```cpp
DirectX::XMVECTOR position =
DirectX::XMLoadFloat3A(&alignedPosition);
DirectX::XMStoreFloat3A(
&alignedPosition,
position
);
```
対応関係は次のとおりです。
| 保存型 | ロード | ストア |
| --------- | --------------- | ---------------- |
| XMFLOAT3 | XMLoadFloat3() | XMStoreFloat3() |
| XMFLOAT3A | XMLoadFloat3A() | XMStoreFloat3A() |
| XMFLOAT4 | XMLoadFloat4() | XMStoreFloat4() |
| XMFLOAT4A | XMLoadFloat4A() | XMStoreFloat4A() |
アライン済みの型を使えば常に速くなるとは限りません。データサイズ、配列の配置、キャッシュ効率、コンパイラの最適化なども関係します。
また、アライン済み型をSTLコンテナで使用する場合は、必要なアラインメントが維持されるかを確認する必要があります。
通常のゲームオブジェクトの位置を保持するだけなら、まずは`XMFLOAT3`で十分です。実際にボトルネックが確認できた部分で、アライン済み型やデータ配置を検討する方が安全です。
---
## よくある間違い
### XMVECTORを常にクラスのメンバにする
`XMVECTOR`をメンバ変数にすること自体が禁止されているわけではありません。
ただし、次の用途では`XMFLOAT3`の方が扱いやすいことが多いです。
- ファイルへ保存する
- GUIへ表示する
- 頂点配列へ格納する
- 構造体をコピーする
- 個別成分を編集する
- C++とHLSLのデータ配置を合わせる
特別な理由がなければ、ゲームオブジェクトの状態は`XMFLOAT`系で保持し、計算中だけ`XMVECTOR`を使う形から始めるとよいでしょう。
### XMFLOAT3を成分ごとに計算し続ける
```cpp
position.x += velocity.x * deltaTime;
position.y += velocity.y * deltaTime;
position.z += velocity.z * deltaTime;
```
このコードが間違いというわけではありません。単純な処理なら十分に読みやすく、コンパイラが最適化する可能性もあります。
ただし、正規化、内積、外積、行列変換、クォータニオン回転などを行う場合は、DirectXMathの関数を使用した方が処理を統一できます。
### 位置と法線へ同じ変換関数を使う
位置には`XMVector3TransformCoord()`、方向や法線には`XMVector3TransformNormal()`を使用します。
ただし、法線については非一様スケールを含む場合に逆転置行列が必要です。
---
## 判断に迷ったときの使い分け
### XMFLOAT系を使う場面
- クラスや構造体のメンバとして保存する
- 頂点データへ格納する
- ファイルへ保存する
- エディターで編集する
- C++とHLSLの構造体を対応させる
- ベクトルの成分へ直接アクセスする
### XMVECTORを使う場面
- ベクトルの加算・減算・乗算を行う
- 正規化する
- 内積・外積を求める
- 行列で座標変換する
- クォータニオンで回転する
- 関数内で一時的な計算結果を保持する
## 最終的なデータフロー
DirectXMathを使うときは、次の流れを基本にすると整理しやすくなります。
```text
1. XMFLOAT3で状態を保持する
↓
2. XMLoadFloat3()でXMVECTORへロードする
↓
3. DirectXMathの関数で計算する
↓
4. XMStoreFloat3()でXMFLOAT3へ戻す
```
この「保存 → ロード → 計算 → ストア」が、この記事で最も重要な基本形です。
自作関数で`XMVECTOR`を受け取るときの書き方は、記事末尾の付録で説明します。
---
## まとめ
`XMVECTOR`と`XMFLOAT3`は、どちらか一方だけを選ぶものではありません。
それぞれの役割を分けて、一緒に使用します。
> **保存は`XMFLOAT`、計算は`XMVECTOR`。**
基本となる役割は、次の2つです。
```text
保存用:XMFLOAT2 / XMFLOAT3 / XMFLOAT4
計算用:XMVECTOR
```
- メンバ変数や頂点データでは`XMFLOAT`系を使う
- 計算するときだけ`XMVECTOR`へロードする
- 計算結果は`XMFLOAT`系へストアして保存する
まずは、この流れを理解すればDirectXMathを使い始められます。
公式ドキュメントに出てくる`FXMVECTOR`系は、通常のベクトル計算とは別の「関数の受け渡し方」の話です。必要になった段階で、後半の付録を参照してください。
---
## FAQ
### XMVECTORとXMFLOAT3は、どちらの方が速いですか?
単純に型だけで比較するものではありません。`XMFLOAT3`は保存用、`XMVECTOR`はDirectXMathによる計算用です。計算内容、メモリアクセス、コンパイラ最適化、データ配置によって性能は変わります。
### XMVECTORをクラスのメンバ変数にしてはいけませんか?
禁止ではありません。ただし、保存、ファイル入出力、デバッグ表示、頂点データなどでは`XMFLOAT3`の方が扱いやすいため、一般的な`Transform`では`XMFLOAT3`を保持して計算時にロードする設計がわかりやすいでしょう。
### 公式ドキュメントのFXMVECTORには何を渡せばよいですか?
普通の`XMVECTOR`をそのまま渡します。`FXMVECTOR`型の変数を別に作ったり、変換したりする必要はありません。`FXMVECTOR`系は、主に関数を定義する側で使用する引数用の型エイリアスです。詳しい理由と使い分けは、次の付録で説明します。
### XMLoadFloat3でw成分はどうなりますか?
`XMLoadFloat3()`で読み込んだ`XMVECTOR`の`w`成分は`0.0f`になります。ただし、`XMVector3TransformCoord()`は入力の`w`を無視し、`1.0f`として位置変換を行います。
---
## 付録:FXMVECTOR・GXMVECTOR・HXMVECTOR・CXMVECTORとは
ここからは、DirectXMathの公式ドキュメントやヘッダーファイルを読んだときに登場する、少し高度な引数型について説明します。
通常のベクトル計算だけを行う場合は、ここまでの内容を理解していれば十分です。
### 最初に結論:関数を使う側はXMVECTORを渡せばよい
公式ドキュメントでは、関数の引数が`FXMVECTOR`になっていることがあります。
```cpp
XMVECTOR XM_CALLCONV XMVector3Normalize(
FXMVECTOR V
) noexcept;
```
これを見ると、`FXMVECTOR`型の変数を作らなければならないように見えます。
しかし、関数を呼び出す側が用意するのは、普通の`XMVECTOR`です。
```cpp
using namespace DirectX;
XMVECTOR direction =
XMVectorSet(1.0f, 2.0f, 3.0f, 0.0f);
XMVECTOR normalized =
XMVector3Normalize(direction);
```
変換処理は必要ありません。
```text
関数を呼び出す側:XMVECTORを渡す
関数を定義する側:FXMVECTORなどで受け取る
```
`FXMVECTOR`、`GXMVECTOR`、`HXMVECTOR`、`CXMVECTOR`は、位置・方向・法線・色などを表す型ではありません。
すべて、関数が`XMVECTOR`を受け取るときに使用する型エイリアスです。
### 普通のC++ではコンパイラに任せるのではないか
ここで、次の疑問が出てきます。
> 普通の構造体を関数へ渡すとき、レジスタを使うかメモリを使うかはコンパイラが決める。XMVECTORだけ、なぜ特別な型を使う必要があるのか。
この疑問はもっともです。
実際に、**どのレジスタを使うか、あるいはメモリを使うかという最終的な判断は、DirectXMathでもコンパイラが行います。**
`FXMVECTOR`は、「この値を必ず特定のレジスタへ入れろ」と命令する型ではありません。
DirectXMathが切り替えたいのは、その一つ前の段階にある、次の違いです。
```cpp
// XMVECTORそのものを値として受け取る
void Function(XMVECTOR value);
```
```cpp
// 元のXMVECTORを参照して受け取る
void Function(const XMVECTOR& value);
```
値渡しと参照渡しは、C++の関数宣言として別物です。
たとえるなら、次の違いです。
```text
値渡し :荷物そのものを渡す
参照渡し:荷物が置かれている場所を渡す
```
コンパイラは、「荷物をどの車に載せるか」に相当するレジスタやメモリの使い方は判断できます。
しかし、プログラマーが「荷物そのものを渡す」と宣言したのに、コンパイラが勝手に「荷物の置き場所だけを渡す」方式へ変更することはできません。呼び出す側と受け取る側が、同じ方法を前提にしていなければならないためです。
つまり、コンパイラが自由に決められるのは、**宣言された値渡し・参照渡しと、その環境の呼び出し規約を守った範囲内**です。
### なぜXMFLOAT4では同じことを意識しないのか
`XMFLOAT4`は、4個の`float`をメモリへ保存するための通常の構造体です。
```cpp
struct XMFLOAT4
{
float x;
float y;
float z;
float w;
};
```
次のような関数を書いた場合、引数を実際にどのレジスタやメモリで渡すかは、通常のC++の呼び出し規約に従ってコンパイラが決めます。
```cpp
void Function(
XMFLOAT4 a,
XMFLOAT4 b,
XMFLOAT4 c
);
```
一方、`XMVECTOR`は単なる保存用構造体ではありません。
x86・x64環境では`__m128`、ARM環境ではNEONのベクトル型などに対応する、SIMD計算用の型です。
```text
XMFLOAT4:メモリへ保存するための普通の構造体
XMVECTOR:SIMD演算で使用するための特殊なベクトル型
```
`XMFLOAT4`を関数へ渡した場合、関数内でSIMD計算をするには、最終的に`XMVECTOR`へロードする必要があります。
```cpp
XMFLOAT4 value;
XMVECTOR vector = XMLoadFloat4(&value);
```
DirectXMathの関数は、最初から`XMVECTOR`を受け取り、そのままSIMD演算へ使用するように作られています。
そのためDirectXMathでは、一般的な構造体よりも、**XMVECTORを関数の境界でどう受け取るか**が性能へ影響しやすくなります。
### DirectXMathが解決したい本当の問題
`XMVECTOR`に適した受け取り方は、すべての環境で同じではありません。
環境によっては、`XMVECTOR`を値として受け取ることで、ベクトルレジスタを使った受け渡しができます。
```cpp
const XMVECTOR value
```
別の環境や引数位置では、参照として受け取った方が、その環境の呼び出し規約に適しています。
```cpp
const XMVECTOR& value
```
この違いには、次のような条件が関係します。
- x86、x64、ARM、ARM64の違い
- 32ビットと64ビットの違い
- 使用するコンパイラ
- `__fastcall`や`__vectorcall`などの呼び出し規約
- その関数が受け取る`XMVECTOR`の数と位置
DirectXMathは、Windowsの複数のCPU環境で同じヘッダーファイルを利用できる、移植可能なSIMDライブラリとして作られています。
もし型エイリアスがなければ、関数定義を環境ごとに書き分ける必要があります。
```cpp
#if VALUE_PASS_IS_BETTER
XMVECTOR Function(const XMVECTOR value);
#else
XMVECTOR Function(const XMVECTOR& value);
#endif
```
これを一つの書き方へまとめるために、DirectXMathは`FXMVECTOR`などの名前を用意しています。
```cpp
XMVECTOR XM_CALLCONV Function(
FXMVECTOR value
) noexcept;
```
`FXMVECTOR`の実体は、環境に応じて概念的に次のどちらかへ切り替わります。
```cpp
typedef const XMVECTOR FXMVECTOR;
```
または、
```cpp
typedef const XMVECTOR& FXMVECTOR;
```
つまり`FXMVECTOR`は、レジスタを直接指定するための型ではありません。
> `XMVECTOR`を値として受け取るか、参照として受け取るかというプラットフォーム差を隠すための型
と考えると理解しやすいでしょう。
その宣言を基に、実際にどのレジスタやメモリを使うかをコンパイラが決定します。
### なぜFX・GX・HX・CXの4種類があるのか
値渡しが適している範囲は、環境や呼び出し規約だけでなく、その関数に何個目の`XMVECTOR`として渡されるかによっても変わります。
その違いを一つの`FXMVECTOR`だけでは表せないため、DirectXMathでは4種類のエイリアスを用意しています。
| XMVECTOR入力引数としての順番 | 使用する型 |
| ------------------ | --------- |
| 1~3番目 | FXMVECTOR |
| 4番目 | GXMVECTOR |
| 5~6番目 | HXMVECTOR |
| 7番目以降 | CXMVECTOR |
覚え方は次のとおりです。
```text
1~3番目 :F
4番目 :G
5~6番目 :H
7番目以降:C
```
これらはベクトルの意味を表しているわけではありません。
```text
FXMVECTOR = 位置用
GXMVECTOR = 方向用
HXMVECTOR = 法線用
CXMVECTOR = 色用
```
という分類ではありません。
呼び出し側が渡す変数は、すべて普通の`XMVECTOR`です。
```cpp
XMVECTOR v1;
XMVECTOR v2;
XMVECTOR v3;
XMVECTOR v4;
XMVECTOR v5;
XMVECTOR v6;
XMVECTOR v7;
XMVECTOR result = Calculate(
v1, v2, v3, v4, v5, v6, v7
);
```
関数を定義する側だけが、次のようにエイリアスを使い分けます。
```cpp
XMVECTOR XM_CALLCONV Calculate(
FXMVECTOR v1,
FXMVECTOR v2,
FXMVECTOR v3,
GXMVECTOR v4,
HXMVECTOR v5,
HXMVECTOR v6,
CXMVECTOR v7
) noexcept;
```
### 数えるのは関数全体の何番目ではない
数えるのは、関数全体の引数番号ではありません。
**入力として受け取る`XMVECTOR`が何個目か**を数えます。
```cpp
XMVECTOR XM_CALLCONV MovePosition(
float deltaTime,
FXMVECTOR position,
float speed,
FXMVECTOR direction
) noexcept;
```
この例では、`position`は関数全体では2番目の引数です。しかし、`XMVECTOR`入力としては1番目なので`FXMVECTOR`です。
`direction`は関数全体では4番目ですが、`XMVECTOR`入力としては2番目なので、同じく`FXMVECTOR`です。
```text
1個目のXMVECTOR入力:position → FXMVECTOR
2個目のXMVECTOR入力:direction → FXMVECTOR
```
`float`、`int`、`bool`などは数えません。
4個目の`XMVECTOR`入力だけが`GXMVECTOR`になります。
```cpp
XMVECTOR XM_CALLCONV SampleFunction(
float time,
FXMVECTOR a,
int mode,
FXMVECTOR b,
FXMVECTOR c,
bool enabled,
GXMVECTOR d
) noexcept;
```
`d`は関数全体では7番目ですが、`XMVECTOR`入力としては4番目なので`GXMVECTOR`です。
### 出力引数は数えない
計算結果を書き込むための`XMVECTOR*`や`XMVECTOR&`は、入力引数の数に含めません。
たとえば、`XMVectorSinCos()`は次のような宣言です。
```cpp
void XM_CALLCONV XMVectorSinCos(
XMVECTOR* pSin,
XMVECTOR* pCos,
FXMVECTOR V
) noexcept;
```
`pSin`と`pCos`は、計算結果を書き込む出力先です。
入力として渡される`XMVECTOR`は`V`だけなので、`V`は1個目として`FXMVECTOR`になります。
```text
XMVECTOR* pSin:出力なので数えない
XMVECTOR* pCos:出力なので数えない
FXMVECTOR V :1個目のXMVECTOR入力
```
### XM\_CALLCONVとは
`FXMVECTOR`系のエイリアスは、値渡しと参照渡しの違いを環境に合わせて切り替えます。
一方、`XM_CALLCONV`は、関数全体の呼び出し規約を環境に合わせて切り替えるマクロです。
```cpp
XMVECTOR XM_CALLCONV MovePosition(
FXMVECTOR position,
FXMVECTOR velocity,
float deltaTime
) noexcept;
```
現在のDirectXMathでは、環境に応じて`__vectorcall`、`__fastcall`、または何も付けない形などへ切り替わります。
```text
FXMVECTOR系:各XMVECTOR引数をどの型で受け取るか
XM_CALLCONV:関数全体をどの呼び出し規約で呼ぶか
```
DirectXMathと同じ形式で自作関数を定義する場合は、基本的にセットで使用します。
#### ヘッダーファイル
```cpp
DirectX::XMVECTOR XM_CALLCONV MovePosition(
DirectX::FXMVECTOR position,
DirectX::FXMVECTOR velocity,
float deltaTime
) noexcept;
```
#### CPPファイル
```cpp
DirectX::XMVECTOR XM_CALLCONV MovePosition(
DirectX::FXMVECTOR position,
DirectX::FXMVECTOR velocity,
float deltaTime
) noexcept
{
return DirectX::XMVectorMultiplyAdd(
velocity,
DirectX::XMVectorReplicate(deltaTime),
position
);
}
```
宣言と定義の両方で、同じ`XM_CALLCONV`を使用します。
なお、既存のDirectXMath関数を呼び出すだけなら、利用者が`XM_CALLCONV`を書く必要はありません。
### コンストラクタだけ規則が異なる
C++のコンストラクタでは、通常の関数と同じ規則をそのまま使いません。
DirectXMathの公式ガイドでは、コンストラクタに`GXMVECTOR`と`HXMVECTOR`を使用しないことが推奨されています。
最初の3個を`FXMVECTOR`、4個目以降を`CXMVECTOR`にします。
```cpp
class VectorCollection
{
public:
VectorCollection(
DirectX::FXMVECTOR v1,
DirectX::FXMVECTOR v2,
DirectX::FXMVECTOR v3,
DirectX::CXMVECTOR v4,
DirectX::CXMVECTOR v5
);
};
```
通常の関数は次の並びです。
```text
F, F, F, G, H, H, C, C, ...
```
コンストラクタでは次の並びになります。
```text
F, F, F, C, C, C, C, ...
```
また、コンストラクタには`XM_CALLCONV`を付けないことが推奨されています。
### 戻り値はXMVECTORでよい
`FXMVECTOR`系は、入力引数を受け取るための型です。
戻り値には通常の`XMVECTOR`を使用します。
```cpp
DirectX::XMVECTOR XM_CALLCONV GetForwardVector(
DirectX::FXMVECTOR rotationQuaternion
) noexcept
{
const DirectX::XMVECTOR baseForward =
DirectX::XMVectorSet(
0.0f,
0.0f,
1.0f,
0.0f
);
return DirectX::XMVector3Rotate(
baseForward,
rotationQuaternion
);
}
```
### 自作関数では必ず使わなければならないのか
既存のDirectXMath関数を呼び出すだけなら、`FXMVECTOR`系を自分で書く場面はありません。
また、自分のアプリケーション内部だけで使う単純な関数なら、通常のC++として次のように書くこともできます。
```cpp
XMVECTOR NormalizeVector(XMVECTOR value);
```
```cpp
XMVECTOR NormalizeVector(const XMVECTOR& value);
```
これらが直ちに間違いになるわけではありません。
ただし、DirectXMathと同じように、複数のWindowsプラットフォームや呼び出し規約へ対応しながら、`XMVECTOR`の受け渡しを最適化した形式にしたい場合は、`FXMVECTOR`系と`XM_CALLCONV`を使用します。
つまり、利用者側では次のように判断できます。
```text
DirectXMath関数を呼ぶだけ
→ 普通のXMVECTORを渡す
簡単な自作関数を作る
→ 通常のC++の引数でも書ける
DirectXMathと同じ移植性・呼び出し規約を採用する
→ FXMVECTOR系 + XM_CALLCONVを使う
```
### XMMATRIXにも同じ考え方がある
行列にも、関数引数用の型エイリアスがあります。
```cpp
FXMMATRIX
CXMMATRIX
```
これらも、行列の意味を表す別の型ではありません。`XMMATRIX`を関数が受け取るときの環境差を隠すための型です。
ただし、`FXMMATRIX`の細かい規則は、周囲にあるベクトル引数や浮動小数点引数の数にも影響されます。
行列の引数規則まで必要になった場合は、公式の関数宣言を参考にするか、別の記事として扱った方が整理しやすいでしょう。
### 付録のまとめ
`FXMVECTOR`系について、利用者側で最初に覚えることは次の3点です。
1. 公式ドキュメントに`FXMVECTOR`と書かれていても、呼び出す側は普通の`XMVECTOR`を渡す
2. `FXMVECTOR`系は、値渡しと参照渡しのプラットフォーム差を隠すための型エイリアスである
3. DirectXMathと同じ形式の自作関数では、`FXMVECTOR`系と`XM_CALLCONV`を組み合わせる
```text
XMVECTOR
実際のベクトルデータ
FXMVECTOR / GXMVECTOR / HXMVECTOR / CXMVECTOR
関数がXMVECTORを受け取るための型エイリアス
XM_CALLCONV
関数全体の呼び出し規約を選ぶマクロ
```
細かい順番は、次のとおりです。
```text
1~3個目のXMVECTOR入力:FXMVECTOR
4個目 :GXMVECTOR
5~6個目 :HXMVECTOR
7個目以降 :CXMVECTOR
```
ただし、コンストラクタでは最初の3個を`FXMVECTOR`、4個目以降を`CXMVECTOR`とし、`XM_CALLCONV`は付けません。
---
## 参考資料
- [Microsoft Learn: Library Internals](https://learn.microsoft.com/en-us/windows/win32/dxmath/pg-xnamath-internals?ref=geekjp.com)
- [Microsoft Learn: XMVector3TransformCoord](https://learn.microsoft.com/en-us/windows/win32/api/directxmath/nf-directxmath-xmvector3transformcoord?ref=geekjp.com)
- [Microsoft Learn: DirectXMath 3D vector transformation functions](https://learn.microsoft.com/en-us/windows/win32/dxmath/ovw-xnamath-reference-functions-vector3-transformation?ref=geekjp.com)
- [Microsoft Learn: XMStoreFloat3](https://learn.microsoft.com/en-us/windows/win32/api/directxmath/nf-directxmath-xmstorefloat3?ref=geekjp.com)
- [Microsoft Learn: XMFLOAT3A](https://learn.microsoft.com/en-us/windows/win32/api/directxmath/ns-directxmath-xmfloat3a?ref=geekjp.com)
- [Microsoft Learn: Packing rules for constant variables](https://learn.microsoft.com/en-us/windows/win32/direct3dhlsl/dx-graphics-hlsl-packing-rules?ref=geekjp.com)
- [Microsoft DirectXMath: DirectXMath.h](https://github.com/microsoft/DirectXMath/blob/main/Inc/DirectXMath.h?ref=geekjp.com)
### ガチ日記 No3
URL: https://www.geekjp.com/2019-12-16-165111/
Last updated: 2019-12-16T07:51:11.000Z
## ほんとの意味での日記 その3
時間がなくて、更新できませんでしたので、実家に帰った時に見えたまたまた神々しい岩手山さまをアップしておきます。
岩手山は夕日に映えますね。
### 【パズル No 13】じじいの謎解き No 13 図が表しているものなーんだ
URL: https://www.geekjp.com/2019-12-11-172133-2/
Last updated: 2019-12-11T08:21:33.000Z
じじいの謎解き No 13です。
問題が、良い感じに韻を踏んでいます♪
最近はお正月の風物詩みたいなもんだけど、今は予約して買ったりするんですね。
今回は、簡単かもなのでぜひ解いてみてください!
コメントや意見などもお待ちしておりますので、よろしくお願いいたします。
### 問題
#### 図が表しているものな~んだ?
答えががわかったら、答え合わせフォームで答え合わせしてみてください!
気に入ってもらえたら、コメントくださいね。
それでは楽しんでいただければ幸いです。
#### 答え合わせフォーム
読み込んでいます…
### 【パズル No 12】じじいの謎解き No 12 暗号パズル
URL: https://www.geekjp.com/2019-12-11-141045-2/
Last updated: 2019-12-11T05:10:45.000Z
じじいの謎解き No 12です。
どうも、全く自己管理ができないじじいです。
よく見たら、No12をTwitterだけにアップしてこちらにあげていなかったようです。
今更ですが、掲載しますのでお願いだから皆さんこぞって解いてください!
コメントや意見などもお待ちしておりますので、よろしくお願いいたします。
### 問題
#### 暗号を解いて現れる食べ物はなーんだ?
答えががわかったら、答え合わせフォームで答え合わせしてみてください!
気に入ってもらえたら、コメントくださいね。
それでは楽しんでいただければ幸いです。
#### 答え合わせフォーム
読み込んでいます…
### 応用情報技術者試験 令和元年秋試験 テクノロジ系をまったり解く 問11~問15
URL: https://www.geekjp.com/2019-12-10-020800/
Last updated: 2026-07-25T17:21:28.000Z
## R01 応用情報技術者試験 秋期試験に挑戦 問11~問15
前回に引き続き、プログラム作りたい欲が高いけど。
解いていきます。今回は問11~問15です。
> この記事は、令和元年度秋期の応用情報技術者試験を扱った過去問解説です。
> 現在の試験制度とは一部異なりますが、コンピュータサイエンスの基礎知識や過去問学習には引き続き活用できます。
### 令和元年度秋期 応用情報技術者試験 問11~問15 解説
### 問11(テクノロジ系:コンピュータ構成要素:入出力デバイス)
PCとディスプレイの接続に用いられるインターフェースの一つであるDisplayPortの説明として、適切なものはどれか。
| ア | DVIと同じサイズのコネクタで接続する | |
| - | ------------------------ | |
| イ | アナログ映像信号も伝送できる | |
| ウ | 映像と音声をパケット化して、シリアル伝送できる。 | |
| エ | 著作権保護の機能を持たない。 | |
#### 問11 解答
入出力デバイスに関してDisplayPortの知識に関する問題です。
映像の出力デバイスとディスプレイを接続する規格(インターフェース)は、おおきく分けてデジタルのものとアナログのもの2種類に分かれます。
| デジタル入出力 | DVI、HDMI、DisplayPort |
| ------- | -------------------- |
| アナログ入出力 | D-Sub |
**D-sub**
CRTモニタなど、入力がアナログなデバイスがメインだった時代はD-Subという規格が使われていました。
(現在でも結構残ってます。)これらは、アナログの信号で映像を送信する規格でした。
PCのD-sub出力端子
D-subケーブル
そこから、様々な機器の規格やデータ、その伝送法がデジタル化されました。
ディスプレイもいわゆる液晶モニタの台頭により、デジタル化が進み、ゲーム機や家庭用のテレビやオーディオ機器に至るまでデジタル信号を扱うようになりました。
**DVI**
そんなアナログからデジタルの移行期の中で、アナログとデジタル両方の信号をカバーしていた粋な奴がDVIって規格です。
DVIはさらに、以下のように3種類あります
| DVI-I | 23ピンのDVI-Iシングルリンク、と29ピンのDVI-Iデュアルリンクがある |
| ----- | -------------------------------------------------------------------- |
| DVI-A | 17ピンでアナログ信号のみに対応、DVI-Dとの互換性はない |
| DVI-D | 18ピンのDVI-Dシングルリンクと24ピンのDVI-Dデュアルリンクの2種類があり、デジタル信号のみに対応。DVI-Aとの互換性はない |
です。見た目は以下のような形状をしています。(これは今時の人でも見たことある人多いんじゃないかな?)
図 PCのDVI出力(左) DVIケーブル(右)
です。一時期は主流だったのですが、端子自体がでかいこともありちょっと評判は良くなかったです。
また、上で書いたように、何種類かに分かれていて、微妙に穴とピンの配置が違っていました。
図 DVIのピン配置
なんかささんないなって思ったら、右側のピンの形が違っていたりとかよくありました。
それで、HDMIとDisplayPortでやっと完全にデジタルの規格になりました。
**HDMI(High-Definition Multimedia Interface)**
HDMIはデジタル信号を非圧縮で送受信するための規格です。高解像度でオーディオも一本のケーブルで扱えます。
また、著作権保護の機能があるのも今までの規格と違うところです
図 HDMIの規格一覧
**DisplayPort**
DisplayPortは、VESAが策定したデジタル映像・音声インターフェースです。
映像や音声などのデータをパケット化し、シリアル伝送することが大きな特徴です。また、複数のディスプレイを数珠つなぎにするデイジーチェーンにも対応しています。
図 DisplayPortとケーブル形状
ということで選択肢を見ていきます。
| ア | DVIと同じサイズのコネクタで接続する |
| - | ------------------- |
同じサイズではないですね。
| イ | アナログ映像信号も伝送できる |
| - | -------------- |
完全デジタル化された企画ですので違います。
| ウ | 映像と音声をパケット化して、シリアル伝送できる。 |
| - | ------------------------ |
上の説明から、信号をパケット化して伝送するという特徴が説明されていたので、正解は「ウ」です。
| エ | 著作権保護の機能を持たない。 | |
| - | -------------- | |
DisplayPortは、HDCPに対応しています。
### 問12(テクノロジ系:コンピュータ構成要素:メモリ)
SDメモリカードの上位規格の一つであるSDXCの特徴として、適切なものはどれか。
| ア | GPS、カメラ、無線LANアダプタなどの周辺機能をハードウェアとしてカードに搭載している。 |
| - | ---------------------------------------------- |
| イ | SDメモリカードの4分の1以下の小型サイズで、最大32Gバイトの容量を持つ |
| ウ | 著作権保護技術としてAACSを採用し、従来のSDメモリカードよりもセキュリティが強化された。 |
| エ | ファイルシステムにexFATを採用し、最大2Tバイトの容量に対応できる。 |
#### 問12 解答
応用情報技術者試験のシラバスによると、コンピュータ構成要素のメモリに関する知識、
> (1)メモリの種類と特徴
> 半導体の記憶回路,磁気記憶,光記憶を用いたメモリなどの種類があること,半導体メモリ(IC メモリ)の種類,特徴(揮発性,不揮発性,アクセス速度,容量,コスト,物理サイズなど),代表的な用途,システム設計におけるメモリの選択の考え方を理解する。
> **用語例** RAM,ROM,DRAM,SRAM,リフレッシュ,マスク ROM,PROM(Programmable ReadOnly Memory ), EPROM ( Erasable Programmable Read Only Memory ), EEPROM(Electrically Erasable Programmable Read Only Memory),フラッシュメモリ(NAND,NOR),SDRAM,DDR SDRAM,DDR2 SDRAM,DDR3 SDRAM,DDR4 SDRAM
に関する知識を問う問題です。このシラバスに出てくるメモリの種類と特徴ぐらいは覚えていて損はないと思います。
メモリの種類や特徴に関する問題も基本情報、応用情報で結構な頻度で見る問題です。
今回はSDXC規格についてです。
SDXCはSDHCの容量不足を解決するために、登場した規格です。形状などの規格はSDHCと同様で、通常のものとMicroSDXCが存在します。違いは、ファイルシステムにexFatというFat32の拡張規格を使い2Tバイトまでの容量に対応しているところです。
正解はわかってしまいましたが、選択肢を見てみます。
| ア | GPS、カメラ、無線LANアダプタなどの周辺機能をハードウェアとしてカードに搭載している。 |
| - | --------------------------------------------- |
SDIO(Secure Digital Input/Output)という規格の説明です。
[https://www.weblio.jp/content/SDIO](https://www.weblio.jp/content/SDIO?ref=geekjp.com)
| イ | SDメモリカードの4分の1以下の小型サイズで、最大32Gバイトの容量を持つ |
| - | ------------------------------------- |
microSDカードの説明です。
[https://www.weblio.jp/content/MicroSD](https://www.weblio.jp/content/MicroSD?ref=geekjp.com)
| ウ | 著作権保護技術としてAACSを採用し、従来のSDメモリカードよりもセキュリティが強化された。 |
| - | ---------------------------------------------- |
AACSは主にBlu-ray Discなどで使われる著作権保護技術であり、 SDXCの特徴を説明したものではありません。そのため「ウ」は誤りです。
ちなみに、SD規格の親玉SDアソシエーションのWebには全く記述がなくCPRMの記述のみのようですが、ほかのサイトなどで確認すると、CPRMを拡張し(互換性はない)たCPXMという著作権保護の技術を使っているようです。
[デジタルコンテンツ保護のために - SD Association](https://www.sdcard.org/jp/consumers/choices/cprm/index.html?ref=geekjp.com)
| エ | ファイルシステムにexFATを採用し、最大2Tバイトの容量に対応できる。 |
| - | ------------------------------------ |
「エ」が正解です。
現在では、さらに上位のSDUCという規格も登場して、最大容量が128Tバイトまでになっています。
[SD、SDHC、SDXC、SDUCのデータ容量帯について - SD Association](https://www.sdcard.org/jp/consumers/choices/file%5Fsystem/index.html?ref=geekjp.com)
### 問13(テクノロジ系:システム構成要素:システムの評価指標(キャパシティプランニング))
システムの性能を向上させるための方法として、スケールアウトが適しているシステムはどれか。
| ア | 一連の大きな処理を一括して実行しなければならないので、並列処理が困難な処理が中心のシステム |
| - | --------------------------------------------------------------------- |
| イ | 参照系のトランザクションが多いので、複数のサーバーで分散処理を行っているシステム |
| ウ | データを追加するトランザクションが多いので、データの整合性を取るためのオーバヘッドを小さくしなければならないシステム |
| エ | 同一のマスタデータベースがシステム内に複数配置されているので、マスタを更新する際にはデータベース間で整合性を保持しなければならないシステム |
#### 問13 解答
シラバスではシステム構成要素のシステムの評価指標のところで用語が出てきます。
> ② キャパシティプランニング
> キャパシティプランニングの目的,考え方,システムに求められる処理の種類,量,処理時間などを検討し,性能要件からサーバやストレージなどの性能諸元を見積り,システムの性能を継続的に把握,評価するという手順を理解する。
> **用語例** 負荷,サイジング,スケールアウト,スケールアップ,容量・能力管理,システムパラメータ,プロビジョニング
システム性能を上げるための手法として、スケールアップとスケールアウトがあります。
スケールアウトは、サーバーの数を増やすことで性能を上げる方法です。
スケールアップは、サーバーのCPUやメモリーといったハードウエアを高性能なものにして処理性能を上げる方法。
Webサーバーなどは、同じサービスをサーバ台数を増やすことでカバーできるので、スケールアウトが適しています。
また、DBサーバーなどは、分散したサーバーで処理を継続させると処理の同期が複雑な処理になってしまうため、スケールアップが適しているとされます。
が、最近は仮想化によって、その差がなくなっている部分もありますが、Webサーバなどのような独立した同じサービスを分散させサービス数を増やすことで性能を向上できる場合はスケールアウトで、同期処理や整合性が必要なシステムではスケールアップで性能を上げるのが良いようです。
同期処理や整合性の観点に注目して、選択肢を見てみると。
| ア | 一連の大きな処理を一括して実行しなければならないので、並列処理が困難な処理が中心のシステム |
| - | --------------------------------------------- |
アは、一連の処理を分割して並列実行することが困難なシステムです。 サーバー台数を増やしても処理を分散しにくいため、 スケールアウトには適していません。
| イ | 参照系のトランザクションが多いので、複数のサーバーで分散処理を行っているシステム |
| - | ---------------------------------------- |
分散処理が可能なので正解か?
| ウ | データを追加するトランザクションが多いので、データの整合性を取るためのオーバヘッドを小さくしなければならないシステム |
| - | ---------------------------------------------------------- |
整合性を取るために。。。×ですね。
| エ | 同一のマスタデータベースがシステム内に複数配置されているので、マスタを更新する際にはデータベース間で整合性を保持しなければならないシステム |
| - | --------------------------------------------------------------------- |
整合性を保持。。。×ですね。
ということで、正解は「イ」です。
### 問14 (テクノロジ系:システム構成要素:システムの評価指標(キャパシティプランニング))
キャパシティプランニングの目的の一つに関する記述のうち、最も適切なものはどれか。
| ア | 応答時間に最も影響があるボトルネックだけに着目して、適切な変更を行うことによって、そのボトルネックの影響を低減又は排除することである。 |
| - | ------------------------------------------------------------------- |
| イ | システムの現在の応答時間を調査し、長期的に監視することによって、将来を含めて応答時間を維持することである。 |
| ウ | ソフトウェアとハードウェアをチューニングして、現状の処理能力を最大限に引き出して、スループットを向上させることである。 |
| エ | パフォーマンスの問題はリソースの過剰使用によって発生するので、特定のリソースの有効利用を向上させることである。 |
#### 問14 解答
キャパシティプランニングでは、現在の処理量だけでなく、 利用者数やトランザクション量の将来的な増加も予測し、 必要なCPU、メモリ、ストレージ、ネットワークなどを見積もります。 したがって、現在の応答時間を調査・監視し、 将来も必要な性能を維持しようとする「イ」が最も適切です。
キャパシティプランニングの実際の実施手順はいろんなところに書いてありますが、以下のような手順が一般的です。
1. 現行システムの分析、現在の処理能力の把握
2. 将来的な拡大計画、それに伴う、利用者数の増加などを分析
3. 現システム能力の限界時期を予測
4. 新システム構成で実現すべき性能要件から、必要なハードウェア増設を導き検討
これらを総合して考えると、
| イ | システムの現在の応答時間を調査し、長期的に監視することによって、将来を含めて応答時間を維持することである。 |
| - | ----------------------------------------------------- |
が最もふさわしそうなので正解となります。
### 問15 (テクノロジ系:システム構成要素:システムの評価指標(システムの性能特性と評価 ))
1件のデータを処理する際に、読み取りには40ミリ秒、CPU 処理には30ミリ秒、書き込みには50ミリ秒かかるプログラムがある。このプログラムで、n件目の書き込みと並行してn+1件目のCPU処理とn+2件目の読み取りを実行すると、1分当たりの最大データ処理件数は幾つか。ここでOS のオーバーヘッドは考慮しないものとする。
| ア | 500 | イ | 666 |
| - | --- | - | ----- |
| ウ | 750 | エ | 1,200 |
#### 問15 解答
並列処理の処理過程についての問題です。
プログラムの各処理にかかる時間は以下の通りです。
| 読み取り(R) | 40ms |
| ------- | ---- |
| CPU(C) | 30ms |
| 書き込み(W) | 50ms |
これを並列で処理するために、
n件目の書き込み時に、n+1件目のCPU処理、n+2件目の読み取り、を同時に行います。
W(n)、C(n+1)、R(n+2)が同時に行われるということですね。
ここで、この中で一番処理時間が長いのは書き込み処理ですので、結局書き込み処理が1分間で何回行われるか、というだけの問題になってしまします。
一応図で書いてみます。
図 並列処理の進行
図で書くとあからさまですね。 よって、 \\\[ \\frac{60{,}000\\ \\mathrm{ms}} {50\\ \\mathrm{ms/件}} = 1{,}200\\ \\mathrm{件} \\\] で「エ」が正解です。
### 所感
今回の5問も、そこまで難しくない問題でしたが、並列処理などは応用情報技術者でしか出ていないようでした。
今回も、なにか、間違いや突っ込みどころなどありましたら、気軽にコメントください。
### ガチ日記 No2
URL: https://www.geekjp.com/2019-12-09-145738/
Last updated: 2019-12-09T05:57:38.000Z
## ほんとの意味での日記 その2
先週末は、スタッドレスタイヤを取りに実家に帰ってまいりました。
スタッドレスタイヤを取りに行ったのに、道中こんな状態で。。。
履きつぶしのスタッドレス履いてたのですが、案外効いてたので取り換えなくてもいいかな?とも思ったのですが、どう見ても溝ないので止めました。
雪が降る地域はまだいいのですが、岩手の県北は雪ではなく道路が直接凍ります。
なので、いろいろスタッドレスタイヤを試してみてるんですが、冬場に距離を乗る人たちにはブリザック信仰が根強いですし、実際ブリザックの上位のモデルを使ってみると、高性能なのは明らかです。(雪道、凍結路を普通に走るという観点からなら)
ゆっくり、安全に走った上で、効くか効かないかという部分では、海外製のものも性能が上がってきてますし、日本製のものならなおさらです。(日本の冬道に合わせて作ってますもんね)
でも、ブリザックのVRX2っていくらするか知ってます?
東北民大好きのスバル レガシィGTの標準タイヤサイズ215/45R17のサイズで調べると。。。
Amazonで価格を確認(笑)
- タイヤサイズ:215/45R17(215/45-17)
- ブリザック史上最高性能実現のプレミアムテクノロジー。
- さまざまな冬道に効く優れた総合性能。「アクティブ発泡ゴム136」、新「非対称パタン」 でしっかり止まる、曲がる。さらに「静かに」、さらに「長持ち」。さまざまな冬道を快適に!
- ※販売価格はタイヤ1本の価格です。ホイールは装着イメージです。
毎年買うわけではないけれど、冬場に結構移動する人は何年かに一度は買わなきゃないんですよね。
結構しんどい価格だよね。
岩手県民(と東北、北海道+豪雪地帯)には、スタッドレス手当てがあってもいいと思います(笑)
あと、融雪剤まくのはいいけど(ほんとは良くないと思ってる)、車にぶっかけていくのはやめてほしいです。
本当は良くないってのは、解けたものが新しい雪と交じって、チェーン履いたトラックに踏み固められてぼこぼこに固まって、タイヤがはじけてハンドルを取られて危ないし、車のパーツが解けます。
これで車何回修理したか。。。(ディーラーでいうことは、融雪剤とかで結構腐食しますからねぇwです。)
洗車機で下回り洗浄オプション入れて洗ったとこでそんなに落ちないしね。
というわけで、更新さぼりました。すみません。
(笑)
### 応用情報技術者試験 令和元年度秋試験 問題のテクノロジ系をまったり解く 問06~問10
URL: https://www.geekjp.com/2019-12-07-012835/
Last updated: 2026-08-01T17:24:00.000Z
## R01 応用情報技術者試験 秋期試験に挑戦 問6~問10
前回に引き続き、あまり乗り気じゃないけれど(笑)
解いていきます。今回は問06~問10です。
> この記事は、令和元年度秋期の応用情報技術者試験を扱った過去問解説です。
> 現在の試験制度とは一部異なりますが、コンピュータサイエンスの基礎知識や過去問学習には引き続き活用できます。令和元年度秋期 応用情報技術者試験 問06~問10 解説
### 問6(テクノロジ系:アルゴリズムとプログラミング:データ構造)
先頭ポインタと末尾ポインタを持ち、多くのデータがポインタでつながった単方向の線形リストの処理のうち、先頭ポインタ又は各データのポインタをたどる回数が最も多いものはどれか。ここで、単方向のリストは先頭ポインタからつながっているものとし、追加するデータはポインタをたどらなくても参照できるものとする。
| ア | 先頭にデータを追加する処理 | |
| - | ------------- | |
| イ | 先頭のデータを削除する処理 | |
| ウ | 末尾にデータ追加する処理 | |
| エ | 末尾のデータを削除する処理 | |
#### 問6 解答
リスト構造の問題です。
リスト構造は、データ構造の基本的なものの一つです。アルゴリズムとデータ構造を勉強すると必ず出てきます。実装はC言語などのような、アドレスでデータを参照する言語仕様で説明されていることが多いです。今回の問題も、ポインタにアドレスを格納してデータを繋いでいく仕様です。
リスト構造では、データ部とアドレス部(ポインタ)を持つデータ個体を作ります(下図(左))
ここのデータは別々に動的に作るので、その都度空いているところの適当なアドレスを持っています(連続して作ったからといって、配列の様にアドレスが連続しているわけではない)。
なので、配列などの連続したアドレスのデータの様に、次のアドレスを見れば次のデータが入っているわけではありません。
そこで、下図(右)のように、ポインタ(アドレス部)に次につなぎたいデータのアドレスを保存していきます。
図 リスト構造の接続前の個々のデータ(左) データを接続(右)
これを次々行うことで、一連のポインタでつながれた連続したデータ構造ができます。
図 接続されたリスト構造
あとは、先頭のアドレスから順に、次のデータを示すポインタをたどっていけばデータを参照できます。
最後はポインタがどこにもつながっていない(NULL)データを見つけた時です。
ただし、データをたどるためには一番初めのアドレスを保存しておかなければならないので、先頭を保存しておくポインタ(Headポインタ)が必ず必要です。
図 headポインタ
これで、headからすべてのデータをたどることができるようになります。また、今回は次のデータを表すポインタだけ(単方向リスト)でしたが、前のデータを示すポインタを作ることにより、双方向に接続することや、もっと複雑な構造も可能になります。
。。。までが、リスト構造の基本です。
さて、問題に戻ると、「先頭ポインタと末尾ポインタをもち」とあります。先頭ポインタは先ほどのheadポインタのことです。そのほかに末尾ポインタ(最後のデータを指すポインタ)を持っています。
図 末尾ポインタ
この状態に、ア~エの操作を加えることを考えます。
| ア | 先頭にデータを追加する処理 |
| - | ------------- |
①用意した追加データのポインタ(アドレス部)に現在のheadに格納されているアドレスを代入
②headに追加データのアドレスを格納
図 先頭にデータを追加する手順
図 完成したリスト
追加するデータはポインタをたどることなくアクセスできるという条件ですので、ポインタをたどる回数は0回です。
| イ | 先頭のデータを削除する処理 |
| - | ------------- |
図 先頭データを削除
先頭データを削除するには、
①先頭データのポインタに格納されているアドレスを、headに代入
図 headに2番目のデータのアドレスを代入
することで、headから、2つ目のデータにアドレスが接続されます。元の先頭ノードが動的に確保されたものであれば、不要になったノードを適切に解放する必要があります。解放しないまま参照を失うと、メモリリークの原因になります。
ポインタをたどる回数は、先頭データのポインタを取ってこなければならないので、head→先頭データのポインタ、と辿りますので1回です。
図 イの結果
| ウ | 末尾にデータ追加する処理 |
| - | ------------ |
末尾にデータを追加するには、tailポインタがないと大変ですが、今回はtailポインタ=末尾のデータのアドレスがあるのでラクチンです。
図 末尾にデータを追加する操作
①tailポインタの指すデータの「ポインタ部」に追加データのアドレスを代入する(末尾なので、元はNULL)。
②tailポインタに追加データのアドレスを代入
図 末尾にデータを追加
ポインタをたどる回数は、tail→tailの指すデータのアドレス部で1回です。
| エ | 末尾のデータを削除する処理 | |
| - | ------------- | |
図 末尾データの削除
末尾のデータを削除するには、
①末尾の1個手前のデータのアドレス(tailポインタの1個前)を得る
②tailポインタに末尾の1個前のデータのアドレスを代入
図 末尾データの削除操作
図 末尾データの削除結果
ここで、末尾の1個前のデータのアドレスを得るには、ちょっと大変な操作が必要です。
①作業用のポインタ変数を用意(tmpとする)
②headから、以下の条件を満たすまでデータをたどる
条件:現在のデータのアドレス部 == tailのアドレス
③条件を満たさない時は、tmp=現在のデータのアドレス部
条件を満たしたときにtmpに残っているのが、tailの1個前のデータである。
ということで(データ数-1)回のアドレス走査が必要ですので、
エが正解です。
### 問7(テクノロジ系:アルゴリズムとプログラミング:ハッシュアルゴリズム)
自然数をキーとするデータを、ハッシュ表を用いて管理する。キー\\(x\\)のハッシュ関数\\(h(x)\\)を
\\(h(x)=x \\bmod n\\)
とすると、任意のキー\\(a\\)と\\(b\\)が衝突する条件はどれか。ここで\\(n\\)はハッシュ表の大きさであり、\\(x \\bmod n\\)は\\(x\\)を\\(n\\)で割った余りを表す。
| ア | \\(a+b\\)が\\(n\\)の倍数 | イ | \\(a-b\\)が\\(n\\)の倍数 |
| - | -------------------- | - | -------------------- |
| ウ | \\(n\\)が\\(a+b\\)の倍数 | エ | \\(n\\)が\\(a-b\\)の倍数 |
#### 問7 解答
ハッシュ関数が、ハッシュ表上の同じインデックスを返してしまうことを衝突(collision)といいます。
今回はハッシュ関数が、
\\\[
x \\bmod n
\\\]
です。
あるキー値 (a) と (b) があり、このハッシュ値が (x\_{1}) と (x\_{2}) だったとして考えてみます。
この場合、(x\_{1}) と (x\_{2}) はそれぞれ、(n) を (a)、(b) で割った余りですので、以下のように表されます。
\\\[
\\begin{aligned}
x\_{1} &= a \\bmod n \\
x\_{2} &= b \\bmod n
\\end{aligned}
\\\]
ですので、(a)、(b) を (n) で割った商をそれぞれ (m)、(l) とすると、
\\\[
\\begin{aligned}
a &= nm + x\_{1} \\
b &= nl + x\_{2}
\\end{aligned}
\\\]
と表されます。
それぞれの式を (x\_{1})、(x\_{2}) について変形すると、
\\\[
\\begin{aligned}
x\_{1} &= a - nm \\
x\_{2} &= b - nl
\\end{aligned}
\\\]
となります。
ここで、ハッシュ値が同じになるときは、
\\\[
x\_{1} = x\_{2}
\\\]
となるので、
\\\[
a - nm = b - nl
\\\]
\\\[
a - b = nm - nl
\\\]
\\\[
a - b = n(m-l)
\\\]
が導かれます。
(m)、(l) は、(a)、(b) を (n) で割った商で整数です。
よって、
\\\[
m-l
\\\]
も整数となります。
この式は、(x\_{1}=x\_{2}) となるときは、「(a-b) が (n) の倍数であるとき」であることを示しています。
したがって、答えは、「イ」(a-b) が (n) の倍数、が正解となります。
### 問8(テクノロジ系:アルゴリズムとプログラミング:ソーティングアルゴリズム)
分割統治を利用した整列法はどれか。
| ア | 基数ソート | イ | クイックソート |
| - | ----- | - | ------- |
| ウ | 選択ソート | エ | 挿入ソート |
#### 問8 解答
ソーティングのアルゴリズムに関する知識を問う問題です。
**分割統治法**とは、大きな問題を小さな問題に分割して、小さな問題を順次解いていくことで結果的に大きな問題を解く手法です。
分割統治法を使ったよく見る処理として以下のようなものがあります。
- 二分探索法
- ハノイの塔の解法
- クイックソート
- マージソート
この時点で、答えは「イ」のクイックソートです。
が、クイックソート以外のアルゴリズムについては、過去記事で解説があります(動画付きのものもあります)ので、一度ご覧ください。(一番肝心なクイックソートの解説をしていない(笑))
- [ソートの話その1](https://www.geekjp.com/2019-10-09-032551/)
- [ソートの話その2](https://www.geekjp.com/2019-10-10-015348/)
- [ソートの話その3](https://www.geekjp.com/2019-10-13-182338/)
- [ソートの話その4](https://www.geekjp.com/2019-10-24-015714/)
- [ソートの話その5](https://www.geekjp.com/2019-11-10-033214/)
### 問9 (テクノロジ系:コンピュータの構成要素:CPUアーキテクチャ)
CPUのプログラムレジスタ(プログラムカウンタ)の役割はどれか。
| ア | 演算を行うために、メモリから読みだしたデータを保持する。 |
| - | ------------------------------- |
| イ | 条件付き分岐命令を実行するために、演算結果の状態を保持する。 |
| ウ | 命令のでコードを行うために、メモリから読みだした命令を保持する |
| エ | 命令を読みだすために、次の命令が格納されたアドレスを保持する。 |
#### 問9 解答
CPUの基本的な機能に関する問です。一昔前は、午後問題にアセンブラがあったので、プログラムカウンタなどは当然の知識だったのですが、最近は情報系の学校でもアセンブラやCPUアーキテクチャをそこまで詳しくやらなくなってきている気もします。(私の世代は、Z80のアセンブラを書いて、外部機器をいろいろ制御する実験が定番だった気がします)
CPUは基本的に、データの複製、数値演算、論理演算、値の比較程度のことしかできません。逆にこれらの単純なことを高速に行うことで大きな仕事をしています。
その時に、CPUの持つ一番小さく高速な記憶装置として働くのがレジスタです。
レジスタは、その役割によって、
- 専門的な役割が割り当てられている
- 専用レジスタ
- 役割が決まっておらずいろいろ使いまわせる
- 汎用レジスタ
に分類されます。
専用レジスタには、
- データレジスタ
- アドレスレジスタ
- インデックスレジスタ
- ベースレジスタ
- アキュムレータ
- フラグレジスタ
- プログラムレジスタ
など様々なものがあります。
この中でプログラムレジスタは、次に実行されるべき命令のアドレスを保持しているレジスタです。
次の命令のアドレスを逐次保持するので、プログラムカウンタとも呼ばれます。
正解はわかったと思いますが、選択肢を見ていくと、
| ア | 演算を行うために、メモリから読みだしたデータを保持する。 |
| - | ---------------------------- |
様々な演算を行うために、メモリからデータを読みだして演算されるまで保持するのが、汎用レジスタです。
| イ | 条件付き分岐命令を実行するために、演算結果の状態を保持する。 |
| - | ------------------------------ |
条件分岐命令のためのレジスタなので、フラグレジスタの説明です。
| ウ | 命令のデコードを行うために、メモリから読みだした命令を保持する |
| - | ------------------------------- |
プログラムカウンタの値を参照して、メインメモリから命令を読みだして保持します。
保持した命令は、デコーダに渡されて、その内容が解釈されます。
命令レジスタ(Instruction register)の説明です。
| エ | 命令を読みだすために、次の命令が格納されたアドレスを保持する。 |
| - | ------------------------------- |
メインメモリ中の、次に実行される命令の格納されているアドレスを保持しているレジスタです。
これが、プログラムレジスタの役割です。
### 問10(テクノロジ系:コンピュータの構成要素:メモリアクセス)
容量が\\(a\\)Mバイトでアクセス時間が\\(x\\)ナノ秒の命令キャッシュと、容量が\\(b\\)M
バイトでアクセス時間が\\(y\\)ナノ秒の主記憶を持つシステムにおいて、CPUからみた、主記憶と命令キャッシュとを合わせた平均アクセス時間を表す式はどれか。ここで、読み込みたい命令コードがキャッシュに**存在しない確率**を\\(r\\)とし、キャッシュ管理に関するオーバーヘッドは無視できるものとする。
| ア | \\(\\displaystyle \\frac{(1-r)\\cdot a}{a+b}\\cdot x + \\frac{r\\cdot b}{a+b}\\cdot y\\) | イ | \\(\\displaystyle (1-r)\\cdot x + r \\cdot y\\) |
| - | ---------------------------------------------------------------------------------------- | - | ----------------------------------------------- |
| ウ | \\(\\displaystyle \\frac{r\\cdot a}{a+b}\\cdot x + \\frac{(1-r)\\cdot b}{a+b}\\cdot y\\) | エ | \\(\\displaystyle r\\cdot x + (1-r)\\cdot y\\) |
#### 問5 解答
結構よく見る問題ですね。なんか、全く同じ問題が過去に出ていた気もします。
(後で、調べてみます)
キャッシュメモリときたら、以下の2つのキーワードを忘れないでください。
- ヒット率:目的のデータや命令がキャッシュメモリに存在する確率
- NFP(Not Found Probability):キャッシュに目的のデータや命令がない確率(主記憶にはある)
ここで、
**ヒット率+NFP=1**
**平均アクセス時間=ヒット率×キャッシュのアクセス時間+NFP×メインメモリのアクセス時間**
が成り立ちます。
ここで気づいたと思いますが、平均アクセス時間にはメモリの容量は関係しません。
式にメモリサイズが入っている「ア」「ウ」は脱落です。
先ほどの平均アクセス時間の式に、出てきた記号を割り当てていくと、
\\(\\displaystyle ヒット率+NFP=1\\)より
\\(\\displaystyle ヒット率=1-NFP=1-r\\)
キャッシュのアクセス時間:\\(x\\)
主記憶のアクセス時間:\\(y\\)
\\(\\displaystyle \\begin{eqnarray} 平均アクセス時間 &=& ヒット率\\timesキャッシュのアクセス時間+NFP\\timesメインメモリのアクセス時間 \\\\ &=& (1-r)\\cdot x + r\\cdot y \\end{eqnarray}\\)
「イ」が正解ですね。
### 所感
まったり5問解いてみました。
今回の5問は、基本情報と大差ない難易度でした(実際基本情報に同じ問題が出て要るっぽい)。
テクノロジ系はあんまりFE,APの差ってないのかもしれないですね。
なにか、間違いや突っ込みどころなどありましたら、気軽にコメントください。
### 【パズル No 2】じじいの謎解き No 2 単語埋めパズル 解答編
URL: https://www.geekjp.com/2019-12-05-191951/
Last updated: 2019-12-05T10:19:51.000Z
_No content available._
### 応用情報技術者試験 最新問題のテクノロジ系をまったり解く 問01~05【令和元年度秋試験】
URL: https://www.geekjp.com/2019-12-04-022542/
Last updated: 2026-08-01T17:20:25.000Z
## R01 応用情報技術者試験 秋期試験に挑戦
あまり乗り気じゃないけれど、応用情報のテクノロジ系の問題を解いていきます。ほかのサイトより優しく解いていきたいと思います。
良かったら活用してください!
### 令和元年度秋期 応用情報技術者試験 問1~問5 解説

### 問1(テクノロジ系:離散数学:基数)
あるホテルでは客室を,1,000部屋もち、部屋番号は、数字4と9を使用しないで0001か順に数字4桁の番号としている。部屋番号が0330の部屋は、何番目の部屋か。
| ア | 204 | イ | 210 | ウ | 216 | エ | 218 | |
| - | --- | - | --- | - | --- | - | --- | |
#### 問1 解答
離散数学か情報数学?の問題でしょうか?
解く方法は何種類かあると思います。
まずは、力づく!
0\~9までに4と9は2つあります。
40台と90台は10個ずつです。
0~ 9→2
10~19→2
20~29→2
30~39→2
40~49→10
50~59→2
60~59→2
70~79→2
80~89→2
90~99→10
0\~99室までに、2x8+10x2=36個の4と9があります。
100番台、200番台。。。も同様に進んでいきます。
400番台が出てくると大変なのですが、問題の部屋番号は0330です。
4と9のつく部屋数は
0~ 99まで36
100~199まで36
200~299まで36
300~330まで6
となり、全330室から36x3+6=114を引いて
330-114=216番目
なので、「ウ」が正解です。
**別解**
解き方としては、こちらのほうがスマートなのかもしれません。、
以前のネタで基数の話をしました。
[基数のはなし](https://www.geekjp.com/2019-10-28-135618-2/)
一般的に、n進数は0~(n-1)のn種類の数字で表される。
というのを書きました。
この部屋番号の割り当て方は、
0,1,2,3,5,6,7,8の8種類の数字を使って、数を表しています。
この記数法で表された、数字は一般的な8進数に変換することができます。
例えば、
567は通常の8進数では456になります。
数字と数字なのでわかりづらいですが、後は、変換した数を10進数に直すだけの作業になります。
なので0330は
変換表
| 0 | 1 | 2 | 3 | 5 | 6 | 7 | 8 |
| - | - | - | - | - | - | - | - |
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 |
で数値を通常の8進数に変換できます。
なので、0330はそのまま330になります。
\\(0\\times8^{3}+3\\times8^{2}+8\\times8^{1}+0\\times8^{0}=216\\)
で、「ウ」が導かれます。
### 問2(テクノロジ系:離散数学:集合、ベン図)
全体集合S内に異なる部分集合AとBがあるとき,\\(\\overlineA\\cap\\overlineB\\)に等しいものはどれか。ここで,\\(A\\cupB\\)はAとBの和集合,\\(A\\capB\\)はAとBの積集合,\\(\\overlineA\\)はSにおけるAの補集合,\\(A-B\\)はAからBを除いた差集合を表す。
| ア | \\(\\overlineA-B\\) | イ | \\((\\overlineA\\cup\\overlineB)-(A\\capB)\\) |
| - | --------------------- | - | --------------------------------------------- |
| ウ | \\((S-A)\\cup(S-B)\\) | エ | \\(S-(A\\capB)\\) |
#### 問2 解答
ベン図を書いていくとわかります。
まず
\\(\\overlineA\\cap\\overlineB\\)
を、ベン図で表してみます。
|  | \\(\\cap\\) |  | → |  |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
こうなります。
あとは選択肢を1個ずつ見ていきます。
| ア | \\(\\overlineA-B\\) |
| - | ------------------- |
|  | \\(-\\) |  | → |  |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| \\(\\overlineA\\) | \\(-\\) | \\(B\\) | → | \\(\\overlineA-B\\) |
答えが出てしまいましたが、次も見てみます。
| イ | \\((\\overlineA\\cup\\overlineB)-(A\\capB)\\) |
| - | --------------------------------------------- |
|  | \\(\\cup\\) |  | → |  |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ----------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| \\(\\overlineA\\) | | \\(\\overlineB\\) | | \\((\\overlineA\\cup\\overlineB)\\) |
んで、
|  | \\(-\\) |  | → |  |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| \\((\\overlineA\\cup\\overlineB)\\) | \\(-\\) | \\((A\\capB)\\) | → | \\((\\overlineA\\cup\\overlineB)-(A\\capB)\\) |
次、
| ウ | \\((S-A)\\cup(S-B)\\) |
| - | --------------------- |
これは
\\((S-A)=\\overlineA, (S-B)=\\overlineB\\)なので、\\(\\overlineA\\cup\\overlineB\\)になります。
|  |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| \\(\\overlineA\\cup\\overlineB\\) |
最後ですが、
| エ | \\(S-(A\\capB)\\) |
| - | ----------------- |
これも変形します。
| \\(S-(A\\capB)=\\overline{A\\capB}=\\overlineA\\cup\\overlineB\\) |
| ----------------------------------------------------------------- |
途中、ド・モルガンしてます。
ベン図は、良いですよね(笑)
### 問3(テクノロジ系:応用数学:待ち行列)
通信回線を使用したデータ伝送システムにM/M/1の待ち行列モデルを適用すると、平均回線待ち時間、平均伝送時間、回線利用率の関係は、次の式で表すことができる。
\\(\\displaystyle{平均回線待ち時間}={平均伝送時間}\\times\\frac{回線利用率}{1-回線利用率}\\)
回線利用率が0から徐々に増加していく場合、平均回線待ち時間が平均伝送時間よりも最初に長くなるのは、回線利用率が幾つを超えたときか。
| ア | 0.4 | イ | 0.5 | ウ | 0.6 | エ | 0.7 |
| - | --- | - | --- | - | --- | - | --- |
#### 問3 解答
待ち行列のモデルがどうのとありますが、日本語の問題です。
モデルで表される、平均回線待ち時間と平均伝送時間の関係は式で示されています。
そのうえで、
\\(平均回線待ち時間\\geq平均伝送時間\\)になる回線利用率を求めるという問題になります。
すなわち、\\(\\displaystyle \\frac{平均回線待ち時間}{平均伝送時間}\\geq{1}\\)
元の式を変形して、
\\(\\displaystyle \\frac{平均回線待ち時間}{平均伝送時間}=\\frac{回線利用率}{1-回線利用率}\\geq{1}\\)
図 回線利用率をxとしたときのグラフ
あとは代入してみればいいのですが、グラフを書いてみると0.5の時に1を超えるようです。
答えは「イ」です。
### 問4 (テクノロジ系:情報に関する理論:AI(人工知能)
AIの機械学習における教師なし学習で用いられる手法として、最も適切なものはどれか。
| ア | いくつかのグループに分かれている既存データ間に分離境界を定め、新たなデータがどのグループに属するかはその分類境界によって判別するパターン認識手法 |
| - | ------------------------------------------------------------------------ |
| イ | 数式で解を求めることが難しい場合に、乱数を使って疑似データを作り、数値計算することで解を推定するモンテカルロ法 |
| ウ | データ同士の類似度を定義し、その定義した類似度に従って似た者同士は同じグループに入るようにデータをグループ化するクラスタリング |
| エ | プロットされた時系列データに対して、曲線のあてはめを行い、得られた近似曲線によってデータの補完や未来予測を行う回帰分析 |
#### 問4 解答
機械学習における、教師あり学習と、教師なし学習の違いを理解しているかという問題です。
| 学習手法 | 入力データ | 分野 |
| ------ | ------------ | ------ |
| 教師あり学習 | 問題データと、正解データ | 識別、回帰 |
| 教師なし学習 | 問題データ | クラスタ分析 |
大雑把にはこのように分類されます。
| ア | いくつかのグループに分かれている既存データ間に分離境界を定め、新たなデータがどのグループに属するかはその分類境界によって判別するパターン認識手法 |
| - | ------------------------------------------------------------------------ |
「ア」は既存データがすでに分類されており(正解データ)、未知のデータに対しその分類のどこに当てはまるかを求めていますので、教師ありに分類されます。
| イ | 数式で解を求めることが難しい場合に、乱数を使って疑似データを作り、数値計算することで解を推定するモンテカルロ法 |
| - | ------------------------------------------------------- |
「イ」のモンテカルロシミュレーションは、教師ありにも、教師なしにも分類されない手法です。
Q学習と呼ばれる手法に分類され、強化学習の手法に含まれます。
| ウ | データ同士の類似度を定義し、その定義した類似度に従って似た者同士は同じグループに入るようにデータをグループ化するクラスタリング |
| - | --------------------------------------------------------------- |
「ウ」では、キーワードとしてクラスタリングという単語が出てきており、文章からも正解データが入力されていないのがわかります。これが正答です。
| エ | プロットされた時系列データに対して、曲線のあてはめを行い、得られた近似曲線によってデータの補完や未来予測を行う回帰分析 |
| - | ----------------------------------------------------------- |
「エ」は曲線あてはめ、回帰というキーワードが出てきていますので、教師ありに分類される手法です。
### 問5(テクノロジ系:計測・制御に関する理論:リアルタイムシステム)
組込みシステムにおけるリアルタイムシステムにおいて、システムへの入力に対する応答のうち、最も適切なものはどれか。
| ア | OSを使用しないで応答する。 |
| - | ---------------- |
| イ | 定められた制限時間内に応答する。 |
| ウ | 入力された順番を守って応答する。 |
| エ | 入力時刻を記録して応答する。 |
#### 問5 解答
リアルタイムシステムに関する知識を問う問題です。
いまいちIPAのシラバスのどこに属するのかわかりませんでした。
なんとなく順番で出てきてるかなというので、計測・制御に関する理論、に分類しました。
リアルタイムシステムとは、ミリ秒やマイクロ秒オーダでの厳密な時間管理が要求されるシステムのことです。
また、リアルタイムシステムは、要求ジョブを決められた時間内(デッドライン)で終われなかったときの影響によって3つに分類されます。
- ハードリアルタイムシステム
- デッドラインを守れないとシステムに致命的なダメージがあるとき
- ファームリアルタイムシステム
- システムのサービスが低下だけで、致命的な影響まではない
- ソフトリアルタイムシステム
- デッドラインを守れなかったときに、致命的な影響はないが、デッドラインを守れなかったジョブの処理価値は0となる。
こちらの分類もたまに問題としてお目にかかるので要チェックかと思います。
ということで、正解は
| イ | 定められた制限時間内に応答する。 |
| - | ---------------- |
です。
### 所感
ついに、応用情報に手を出してしまいました。自分でも未知の領域なところもあるので、一緒に勉強していきましょう!
なにか、間違いや突っ込みどころなどありましたら、気軽にコメントください。
### 【日記】今日の珈琲 チャフのスマトラマンデリン スマトラ式を調べてレア感に浸る【コーヒー部】
URL: https://www.geekjp.com/2019-12-03-125353/
Last updated: 2019-12-03T03:53:53.000Z
## 今日の珈琲 今日の珈琲 チャフのスマトラマンデリン飲んでみる
こんにちは!
今日は、一関市のチャフのコロンビアを、いつも通りカリタの手回しミルで細~中挽きにして、ハリオのV60でドリップしました。
### お豆
一関にあるチャフのスマトラマンデリンです。
200gで1000円です。
パッケージはこんな感じ
図 チャフのスマトラマンデリン
マンデリンは、インドネシアのスマトラ島で生産されている高級銘柄です。
ロブスタ種がポピュラーなこの国のコーヒー生産の中、スマトラ島のマンデリンはアラビカ種となります。
レア感がある珈琲豆ですね。
図 チャフのスマトラマンデリン
- 焙煎の基本8段階
1. ライトロースト(Light roast)
2. シナモンロースト(Cinnamon roast)
3. ミディアムロースト(Medium roast)
4. ハイロースト(High roast)
5. **シティロースト(City roast)**
6. **フルシティロースト(Fullcity roast)**
7. フレンチロースト(French roast)
8. イタリアンロースト(Italian roast)
焙煎は前のキリマンジャロと同様5~6ぐらいでしょうか。
### スマトラ式精製法
珈琲の精製過程は様々あるのは過去記事で書きましたが、中でも珍しいスマトラ式というのがあります。
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/05/180029](https://www.geekjp.com/2019-11-05-180029/)
詳しくは[こちら](https://www.nanbanya.co.jp/staffblog/archives/tsuruma/indonesia%5Freport/note1.html?ref=geekjp.com)の南蛮屋さんのページが詳しいです。
生豆のまま乾燥させるので、乾燥期間を短縮することができるそうです。またそれによって、独特の苦みとコクが生まれる。。。らしい。
### グラインディング
カリタの手回しミルで細~中挽きにしました。
カリタの手回しミルについては、以下の通りです。
過去記事からの引用です。
[【日記】今日の珈琲 一関チャフのキリマンジャロを入れたら部屋がいい香り過ぎた - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-20-125719/)
>
>
> カリタの手挽きミルかわいいですよね。
> 挽き具合の調整がねじ式なので一回ちょっとした分解をしなければならないのですが、かわいさでカバーしてます。
>
> 欠点があるとすれば、一回に挽ける量(引き出しに入る量)とドームに収まる豆の量がマッチしてない(引き出しを収めた状態で中であふれていることがある)のかな、というのと、これはちょっと辛いのですが、冬場になると静電気で引き出しを開けた瞬間粉がふわーっと飛び散ってしまいます。
>
> 対策としては、ちょっと待ってから開ける加湿器を使うアルミテープを貼る静電気除去ブラシで掃除する
>
> などがありますが、効果はどうでしょうね?(笑)
ちなみに、ニトリのミル
[ニトリのコーヒーミル買ってみた - 工学じじいの縁側日記](https://www.geekjp.com/2019-10-30-025737/)
は、カリタのドーム型のものと違い豆を収める部分に蓋(屋根?)がないので、引いてる最中に薄部分に挟まった豆がお外に飛び散りまくります。(ので、いったん箱でお休みしてもらっています)
### ドリッピング
図 ドリッピング
以前も紹介したハリオのV60でハンドドリップしました。
ドリップカップはもちろん、お気に入りのニトリのやつ!
じわーっと膨らんだ時にすでに、コクのある香りがします。
良く膨らみます。30秒蒸らしたのですが、その間に中から、ボコっボコってガスが噴き出してきます。(そのたびに何とも言えないアロマが(^^♪)
ちなみにハリオのV60も前回の記事から引用しておきます。
安価で、おいしいコーヒーが淹れられ良アイテムだと思います。
>
>
> ハリオ(HARIO)のV60は陶器製のものに比べて軽くて安くて扱いやすいです。伝統的な、陶器製のものと比べると、円錐型形状が円錐形をしており、お湯がコーヒー豆を通過する時間を長くできる複雑なリブ近年の加工技術でリブ(空気やお湯の通り道の溝)が複雑で効果的丸穴底に大きな丸穴一つだけなので、お湯の流れを妨げないハンドドリップ時のお湯の量のコントロールが容易
>
> という特徴があります。リブの効果などについてはいろいろ議論はありますが、円錐型と丸穴の効果は高いように思えます。(某社の一つ穴で目詰まりを起こしてクッソえぐいコーヒーになったりするようなことはないです(笑))
### 出来上がり
図 スマトラマンデリン出来上がり
挽き具合はちょうどよかった気がします。もう少し粗くてもよかったかもしれません。
- 香り
- 挽いたときはそれほど感じませんでしたが、ドリップの蒸らし中のコクの深い香りは素晴らしかったです。
- 酸味
- 酸味は極めて弱く、どちらかというとコクと苦み側に味が向いています。
- スマトラマンデリンは、浅煎りで味わうともう少しスパイシーなクセと、フルーティな後味になるらしいですが、チャフの焙煎はそれほど癖がなく飲みやすいです。
- コク
- 後味は、深く少し甘みの残る感じです。
- バランス
- 苦みと、コクが強く、酸味はほとんど感じられませんでした。少し冷めても味があまり変化せずおいしく頂けました。
また、苦みとコクの強さから、ミルクやカフェオレとして飲んでもおいしいと思います。(マキネッタで入れるのも試してみたい)
最近チャフのコーヒー豆は、一関市内のスーパーなどでも購入できますので、もし立ち寄ることがあれば買ってみてください。
(値段設定は謎です)
チャフの場所はここです
ブログ村のボタン良かったら押してほしいです。
よろしくお願いいたします。
### 【python】pythonでゲームを作るって有りなのか真面目に考えた結果の選択肢
URL: https://www.geekjp.com/2019-12-03-004429-2/
Last updated: 2019-12-02T15:44:29.000Z
### pythonで使えるゲームライブラリ
最近のゲーム界隈のプログラミングの流行として、ゲームエンジンてのがあります。有名なものだと、Unityとか、UnrealEngineとかですね。こいつらは、ライブラリというよりは、ゲーム向けの統合開発環境のようなイメージですね。昔は、フレームワークって言ったりもしたけど、とりあえずゲームフレームワーク、ゲームエンジンってそんな明確な分類はしていないようです。
それに対して、ゲームに必要な画像の読み込みや表示、制御などのAPIを提供するのみのものを、ゲームライブラリと呼んでるっぽいですね。
python界隈ではゲームを作ろうとすると、フレームワークというよりはライブラリと呼ばれる分類のものを利用することになりそうです。
#### pythonで使えるゲームライブラリ
あちこちのページに書いてはありますがpythonで使えるゲームライブラリは主に以下のものがあります。
- pygame
- google先生:約 2,350,000 件
- PySDL2
- google先生:約 15,200 件
- PyOpenGL
- google先生:約 398,000 件
- pyglet
- google先生:約 182,000 件
- panda3D
- google先生:約 671,000 件
- kivy
- google先生:約 1,830,000 件
- Pyxel
- google先生:約 154,000 件
### pygame
ちょっと有名なゲームライブラリにSDLってやつがありまして、そいつをpythonでラッピングしたのがpygameってことになります。
XNAとか、enchant.jsとかよりは、優しくないですが、SDL自体はとてもメジャーなライブラリということになりますので、pythonでゲーム作ろうと思ったら、とりあえず一番手に上がってくるのではないでしょうか?
現在絶賛とん挫中のうちのテトリス作ってみた企画もpygameです。
[初心者がpythonとpygameでテトリス風ゲームを作ってみた #03](https://youtube.com/watch?v=dqRSc4-8HRk&ref=geekjp.com)
youtubeを見るとサンプルが何個かあります。
[Helicopter shoot em' up game made with Python and PyGame](https://youtube.com/watch?v=UxcCoDlnqr4&ref=geekjp.com)
ただ、なんだかんだ「ちゃんと」ゲームの形に仕上げて、1個のまとまったゲームとして使えそうだな?と納得するサンプルには出会えないなという印象です。
また、ほかの言語界隈では、SDL2が現在の主流のため、SDLベースのpygameはソフトウェアレンダリングだし、なんか処理が遅いなぁって感じのようです。
もう少しで、SDL2に対応した新バージョンが出るようです。
期待して待ちましょう。
公式サイト:
[https://www.pygame.org/](https://www.pygame.org/?ref=geekjp.com)
日本語ドキュメント:
[http://westplain.sakuraweb.com/translate/pygame/](http://westplain.sakuraweb.com/translate/pygame/?ref=geekjp.com)
インストール:
```bash
pip install pygame
```
### PySDL2
一時期pygameのテンションが下がりまくって、SDL2対応も見送りされて、これからはpySDL2がpygameの後継になるでしょって言われていたライブラリです。
python用に作られたゲームライブラリというよりは、pythonによるAPIラッパーという感じなので、必要なものは自分で作る意気込みが必要そうです。
これでちゃんとゲーム作ったよっていう記事がそんなにみあたりません。。。これぐらいですかね?
[https://lukems.github.io/py-sdl2/tutorial/rl.html](https://lukems.github.io/py-sdl2/tutorial/rl.html?ref=geekjp.com)
公式サイト:
[https://pysdl2.readthedocs.io/en/rel\_0\_9\_6/](https://pysdl2.readthedocs.io/en/rel%5F0%5F9%5F6/?ref=geekjp.com)
インストール:
```bash
pip install pysdl2
```
### pyglet
ディ〇ニーのピンクの豚さんではないです。
マルチプラットフォームのウィンドウイング、マルチメディアライブラリです。ゲームにとどまらず、リッチなUIのアプリケーションの開発もターゲットにしており、フルスクリーンのアプリ製作も可能です。
ウィンドウ制御、イベントハンドリング、OpenGLグラフィックス、画像と動画の読み込み、サウンドと音楽の再生をサポートしています。画像や、音楽のサポート形式も豊富で、様々な形式のものを読み込むことができます。
また、依存ライブラリがなく単独で動作するという特徴があります。
pygletで作ったminecraftクローンです。
公式ページ:
[https://pyglet.readthedocs.io/en/stable/](https://pyglet.readthedocs.io/en/stable/?ref=geekjp.com)
インストール
```bash
pip install pyglet
```
### panda3D
[](https://camo.githubusercontent.com/db79e6ff5d67eb944e41a5629f9cd9c43cc701c7/687474703a2f2f692e696d6775722e636f6d2f664438385a4d552e706e67?ref=geekjp.com)
3Dでゲームを作るなら、これが本命でしょうか?
ゲームライブラリというよりは、冒頭に話したゲームフレームワークに属するようです。というのも、
「THE OPEN SOURCE FRAMEWORK FOR 3D RENDERING AND GAMES」
と、公式でうたってますもんね。そして、ゲームのみならず3DCGレンダリングフレームワークとしても機能するので、3DCGシーンの構築などにも役に立ちそうです。UnityやUE4にならぶとまでは言わないまでも、python環境でのフレームワークといえばpanda3Dになるのではないでしょうか?
Panda3Dサンプル:
公式ページ:
[https://www.panda3d.org/](https://www.panda3d.org/?ref=geekjp.com)
インストール
```bash
pip install Panda3D
```
### kivy
pythonでゲーム作れないかな?ということで検索すると必ず出てくるのがkivyです。
kivy自体はゲームライブラリではありません。
NUI(Natural User Interface)構築のためのUIライブラリという位置づけで開発されています。マルチタッチイベントに対応しており、マウス、キーボード、TUIO、OS固有の広範な入力をサポートしています。OpenGL ES 2のVertext Buffer Objectとshadersを使用したグラフィックライブラリ、マルチタッチ対応のさまざまなウィジェット
、カスタムウィジェットを容易にデザインするための中間言語Kvを持つ、などの特徴があります。
pythonでアプリにGUIを導入しようと思うとコレって感じですかね?
そういう感じなので、日本語の資料も多く公式のドキュメントもほとんど日本語化されています。
[https://pyky.github.io/kivy-doc-ja/](https://pyky.github.io/kivy-doc-ja/?ref=geekjp.com)
ユーザーによる解説ページも非常に豊富ですので使いやすいかと思います。
描画や画像読み込みなどの機能も豊富で、それらkivyの持つ様々な機能を使ってゲームを作ることも可能です。
kivyゲームサンプル:
公式ページ:
[https://kivy.org/#home](https://kivy.org/?ref=geekjp.com#home)
インストール:
- 最新のpipとwheelを持っていることを確認します:
```bash
python -m pip install --upgrade pip wheel setuptools
```
- 依存関係をインストールします(gstreamer(120MB)が必要ない場合はスキップできます、 Kivy’s dependencies(Kivyの依存関係) を参照してください)
```bash
python -m pip install docutils pygments pypiwin32 kivy.deps.sdl2 kivy.deps.glew
python -m pip install kivy.deps.gstreamer
```
- Python 3.5の場合には、glewの代わりに使用できるangleを追加でインストールできます:
```bash
python -m pip install kivy.deps.angle
```
- Kivyをインストールします:
```bash
python -m pip install kivy
```
### Pyxel
何気に、今回一押しのライブラリです。
> Pyxel (ピクセル) はPython向けのレトロゲームエンジンです。
>
> 使える色は16色のみ、同時に再生できる音は4音までなど、レトロゲーム機を意識したシンプルな仕様で、Pythonでドット絵スタイルのゲームづくりが気軽に楽しめます。
ファミコン世代にはたまらんこだわりを感じるゲームライブラリです。
[ファンタジーコンソール](http://webio.kohgakusha.co.jp/archives/19437?ref=geekjp.com)を参考に作られており、昔の8ビット機のようなゲームの製作をターゲットにしています。
[X(旧Twitter)の投稿を見る](https://twitter.com/kitao/status/1023372078236479488?ref%5Fsrc=twsrc%5Etfw&ref=geekjp.com)
製作者が日本人なことと、じわじわ人気が出てきているので資料も増え続けています。
そして、ゲーム制作時に無駄に高機能なものを突き付けられ途方に暮れることもないです。まずは、このライブラリでじっくり本来の「ゲーム」ってなんだ?というところを学んでみるのに最適ではないでしょうか?
公式ページ:
[pyxel/README.ja.md at master · kitao/pyxel · GitHub](https://github.com/kitao/pyxel/blob/master/README.ja.md?ref=geekjp.com)
インストール:
```bash
pip install -U pyxel
```
### 所感
足りないものは、何でも作ればいいじゃん、って人はSDL系のものを使うのもいいですが、やっぱり、初心者だし簡単にちょっと〇〇してみたいなぁみたいなときに使えるライブラリがなくて困ってましたが、これからはちょっと規定できるのかなって思います。
やたら、pygameおすすめされてますが、そのページをよく見てみてください。ゲーム作ってないんで(笑)
~してみた、で終わってるページ多くないですか?
### 【パズル No 1】じじいの謎解き No 1 単語埋めパズル 解答編
URL: https://www.geekjp.com/2019-12-02-014339/
Last updated: 2019-12-01T16:43:39.000Z
_No content available._
### ガチ日記
URL: https://www.geekjp.com/2019-11-30-004948/
Last updated: 2019-11-29T15:49:48.000Z
## ほんとの意味での日記
今日は忙しくて、ブログも謎解きも更新する暇がありませんでした。
明日も忙しいけど、何とか頑張りますので、引き続きよろしくお願いいたします。
### 【パズル No 11】じじいの謎解き No 11 謎計算パズル
URL: https://www.geekjp.com/2019-11-28-233200/
Last updated: 2019-11-28T14:32:00.000Z
じじいの謎解き No 11です。
### 問題
#### 図をヒントに?に入る言葉を考えてください。
答えががわかったら、答え合わせフォームで答え合わせしてみてください!
気に入ってもらえたら、コメントくださいね。
それでは楽しんでいただければ幸いです。
#### 答え合わせフォーム
読み込んでいます…
### 【日記】岩手公園に30年ぶりに行ってみたら懐かしくて泣いた
URL: https://www.geekjp.com/2019-11-28-144836-2/
Last updated: 2019-11-28T05:48:36.000Z
### 岩手公園
盛岡にある岩手公園は、1871年まであった盛岡城(別名:不来方城)の城跡にある公園です。
後で触れますが、岩手公園という呼び方には、ちょっとしたいわくが有って、本来正式名称は「盛岡城跡公園」です。
ここでは、あえて岩手公園ですすめます。
図 岩手公園全体図
石川啄木が、学校の窓から抜け出して、さぼって哲学書を読んだりしていたという記録が残っています。
```text
不来方(こずかた)のお城のあとの草に寝て空に吸はれし十五の心
```
この歌、一般には「不来方のお城の草に寝ころびて、空に吸われし十五の心」として有名です。
2種類あるのはどうしてかってのは、以下のリンクに考察があります。
[https://www.library.pref.iwate.jp/aboutus/kanpo/kanpo177/177\_07-08.pdf](https://www.library.pref.iwate.jp/aboutus/kanpo/kanpo177/177%5F07-08.pdf?ref=geekjp.com)
話がそれてしまいましたが、子供時代盛岡に住んでいた人にとっては、大体思い出がある公園になっていると思います。
また、石垣ライトアップ、さくらまつり、石垣ミュージックフェスティバルなど催し物も多く開催される公園です。
### 岩手公園近代史
Wikipediaから、岩手公園の年表を引用します。
> 1871年(明治4年) - 廃藩置県により廃城。
> 1874年(明治7年) - 廃城令では当初存城とされたが、老朽化が著しく一般に払い下げとなり、ほとんどの建物が解体移築された。その後、陸軍用地となった土地の建物を除いて旧藩主南部家に払い下げとなる。
> 1906年(明治39年) - 岩手県に貸与され、長岡安平の設計により「岩手公園」として開園した。
> 1934年(昭和9年) - 盛岡市が旧城地を南部家より買収する\[4\]。
> 1937年(昭和12年) - 城跡が「濠湟石壁土壘尚ヨク存シ舊規模ノ見ルベキモノアリ」\[5\]として国の史跡に指定された。
> 1956年(昭和31年) - 岩手公園として都市計画決定。一般公園として開設。
> 1980年(昭和55年) - 総合公園として開設。
> 1989年(平成元年) - 日本の都市公園100選に選定。
> 2006年(平成18年) - 日本100名城(6番)、日本の歴史公園100選に選定。愛称を『盛岡城跡公園』に決定。
2006年には、日本の都市公園100選に選ばれていますね。
公園としてのクオリティは結構高いということだと思います。
[https://youtu.be/83V7H5xYwGM](https://youtu.be/83V7H5xYwGM?ref=geekjp.com)
紹介動画がありました。
#### 岩手公園の名称問題
その2006年に事が起こります。2006年は1906年に「岩手公園」が開園してから記念すべき100周年の年でした。
この年に盛岡市が、突然「岩手公園の名称変更案」を発表します。しかも、「盛岡城跡公園」と「盛岡お城跡公園」の2択で。。。
しかも、いつの間にか名称変更から、愛称募集にシフトチェンジしていました。
そして、シラーっと「盛岡城跡公園」が愛称に決定し、公園としての正式名称は「岩手公園」だが、愛称は「盛岡城跡公園」になりました。つまり、
- 岩手公園(盛岡城跡公園)
ただし、盛岡市としては案内板や、道路標識などは「盛岡城跡公園」で統一する(事実上の名称変更)だそうです。
というのを踏まえて、先ほどの案内図をもう一度見てみましょう。

図 岩手公園全体図
岩手公園のほうがかっこ書きになってる(笑)
しかもPark-PFI(芝生広場への商業施設展開)の問題なんかもあって、盛岡市迷走中ですね。
[https://www.kahoku.co.jp/tohokunews/201907/20190710\_31004.html](https://www.kahoku.co.jp/tohokunews/201907/20190710%5F31004.html?ref=geekjp.com)
名称変更のときもそうだったけど、どうなんでしょうね?
まず、住民がいて盛岡があって、そこに来る人がいるってことだと思うんだけど、外から観光客が来ても、シャッター街が並んでいたり、地元のお店が少なかったりしたら、次はもう来ないですよね。
やっぱ外から人を呼ぶのは、地元の地元ならではの、地元の人のお店だと思うんだけど。
映画館通りの失敗を繰り返さないでほしいものですね。
### 落ち葉の公園
この日は天気は良かったのですが、紅葉もすっかり落ち着き、すでに雪も何度か降っているので、葉っぱはもう大体落ちてしまって、冬の始まりを感じさせるような乾いた景色が広がっていました。
図 岩手公園入口
入口は何カ所かありますが、岩手公園下側から登ります。
図 公園から市内を一望
この日は平日の午後だったのですが、外国人のグループがお散歩をしていました。欧米の方、アジア系の方色々いましたね。
(欧米の人たちが、ハトの物まねをしながらハトに絡んでいてちょっと面白かったです)
公園内部は、工事をしている部分もあり全部は回れませんでしたが、落ち葉と枯れ枝が秋の終わりと冬の始まりを告げているようでちょっとノスタルジックな気持ちになってしまいました。
今まで全然思い出しもしなかったような、高校生の時、ここ歩いたなぁ。。。なんて30年前の思い出がよみがえりました(笑)
#### 啄木歌碑へ
そのまま、御廊下橋を渡り、啄木の歌碑の方へ
すぐ横に桜山神社とその、シンボル烏帽子岩(兜岩)があります。
猫に夢中で、写真撮り忘れました。。。
[X(旧Twitter)の投稿を見る](https://twitter.com/CarinaYoshigo/status/755205598325596160?ref%5Fsrc=twsrc%5Etfw&ref=geekjp.com)
図 御廊下橋を渡り啄木歌碑へ
途中、猫が餌付けされていて、そのおこぼれをハトが狙っていました(笑)
図 公園猫
### 所感
盛岡はやっぱりいいですね。
でも、大通りや菜園を歩いている人の平均年齢がとても高く(自分も含めて)ナウでヤングな街ではなくなったんだなぁと痛感させられました。
大通り周辺は、飲み屋街みたいになってしまっていて、夜になると案外若者が騒いでいますね。
昔はもっと大通りも、肴町も人であふれていた気がするのですが、今はイオン周辺にしか人がいないんじゃないかな。。。
もっと、盛岡市には昔ながらの建物や、名物店を残していく努力をしてほしいです。
### 【パズル No 10】じじいの謎解き No 10 画像連想クイズ
URL: https://www.geekjp.com/2019-11-28-015927/
Last updated: 2019-11-27T16:59:27.000Z
じじいの謎解き No 10です。
記念すべき10個目ですが、No 9はなんとなく[Twitter](https://twitter.com/crazyoldgeezers?ref=geekjp.com)だけにアップしてました。
ヒントが欲しい人は[DM](https://twitter.com/crazyoldgeezers?ref=geekjp.com)で!
分かっても答えは言わないでね(笑)
### 問題
#### 図をヒントに?に入る言葉を考えてください。
答えががわかったら、答え合わせフォームに入力してみてください。
#### 答え合わせフォーム
読み込んでいます…
### 【パズル No 3】じじいの謎解き No 3 画像連想クイズ
URL: https://www.geekjp.com/2019-11-27-183727/
Last updated: 2019-11-27T09:37:27.000Z
じじいのパズル No3です。
分かっても答えは言わないでね(笑)
### 問題
#### 図が何を表しているか考えてください。
ヒント:
A~Hを見てもわらかない時は
下の1~4の分類をよく見ると気づくかも。
解答は、A~Hが表しているものの正式な名称を漢字で答えてください。(漢字4文字、または、漢字5文字)
読み込んでいます…
### 【パズル No 1】解答フォーム設置 正解発表はもう少し後
URL: https://www.geekjp.com/2019-11-27-170601/
Last updated: 2026-08-01T16:30:17.000Z
## パズルの時間 No 1の解答フォーム
### 解答フォーム設置
DM以外で答え合わせ出来るようにフォームを作りました。
以下からどうぞ!
[答え合わせフォームの記事へ](https://www.geekjp.com/2019-12-02-014339/)
正解のX(旧Twitter)での拡散などはご遠慮願います。
よろしくお願いします。
### 【パズル No 8】じじいの謎解き No 8 連想パズル 何を表してるでしょうか?
URL: https://www.geekjp.com/2019-11-25-234408/
Last updated: 2019-11-25T14:44:08.000Z
調子に乗って問題作りまくってますので、コメントやTwitterのフォローお願いします。
オリジナル問題ですので、ググっても答えはないです(笑)
ヒントはTwitterのDMでお願いします。
### 問題
#### ヒントを元に何を表しているか考えろ!
右と、真ん中の表すものを考えて、右の図が何を表しているか考えてください。
分かっても答えは言わないでね(笑)
ヒントが欲しい人はtwitterまで!
### 答えがわかった人
読み込んでいます…
### 【pythonでゲーム】ヒット&ブローゲーム作る まとめ【簡単】
URL: https://www.geekjp.com/2019-11-25-012926/
Last updated: 2019-11-24T16:29:26.000Z
【pythonでゲーム】ヒット&ブローゲーム作る まとめ【簡単】
- [pythonとpygameでヒット&ブローゲームを作ろう](#pythonとpygameでヒットブローゲームを作ろう)
- [ゲーム作ってみよう](#ゲーム作ってみよう)
- [pygameに関して触れている書籍](#pygameに関して触れている書籍)
### pythonとpygameでヒット&ブローゲームを作ろう
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-015433/)
[【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-170123/)
[【python】ヒット&ブローゲーム作る #05 正誤判定、ログの表示【プログラミング】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-22-052748/)
[【pygame】pythonでヒット&ブローゲーム作る #06 ログの表示をかっこよく【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-24-023919/)
[【pygame】pythonでヒット&ブローゲーム作る #07 最終調整【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-25-011415/)
#### ゲーム作ってみよう
pythonってゲーム作れるの?という安易な考えのもとに初めて見たシリーズですが、何とか完成させられました。
ソースはすべてgithubにありますので、ご自由にどうぞ。
[GitHub - gomta777/hitandblow: hit and blow game](https://github.com/gomta777/hitandblow?ref=geekjp.com)
#### pygameに関して触れている書籍
pygameとpythonでのゲーム制作に関して触れている数少ない書籍です。
参考になると思いますので、ぜひ読んでみてください。
| |
| --------------------- |
| Pythonでつくる ゲーム開発 入門講座 |
ブックマーク、コメント、読者登録、よろしくお願いいたします。
twitter始めました!フォローもお願いします。
[X(旧Twitter)の投稿を見る](https://twitter.com/crazyoldgeezers/status/1198320438591381504?ref%5Fsrc=twsrc%5Etfw&ref=geekjp.com)
よかったら、ブログ村↓のクリックお願いします。
### 【pygame】pythonでヒット&ブローゲーム作る #07 最終調整【簡単】
URL: https://www.geekjp.com/2019-11-25-011415/
Last updated: 2019-11-24T16:14:15.000Z
【pygame】pythonでヒット&ブローゲーム作る #07 最終調整【簡単】
- [前回までのまとめ](#前回までのまとめ)
- [最終調整](#最終調整)
- [手数オーバーによるゲームオーバーの実装](#手数オーバーによるゲームオーバーの実装)
- [正解時の手数の表示](#正解時の手数の表示)
- [初期化の見直し](#初期化の見直し)
- [今回のまとめ](#今回のまとめ)
### 前回までのまとめ
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-015433/)
[【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-170123/)
[【python】ヒット&ブローゲーム作る #05 正誤判定、ログの表示【プログラミング】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-22-052748/)
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/24/023919](https://www.geekjp.com/2019-11-24-023919/)
前回までで、タイトル画面、ゲーム画面の状態遷移、
図 状態遷移
問題の出題と、解答の入力とチェック
図 解答の入力とチェック
タブによる、解答ログのページ切り替え表示。
解答ログを15x4ページに表示する機能を実装しました。
実行結果:
図 タブの切り替え
### 最終調整
最後に、ほとんどそんなことはないと思いますが、ログの4ページ目、つまり15x4=60回解答をミスった時にゲームオーバーになる処理と、60回以内に回答を成功させると、「Congratulations」のメッセージと何手で解答できたかを表示します。
#### 手数オーバーによるゲームオーバーの実装
ゲームオーバーのシーンに移動したときの処理を、2種類に分けます。
- ゲームオーバー
1. 60手以内に解答成功
- 「〇手で解答しました」のメッセージを表示
2. 60手を超えてしまった
- 「手数オーバー」のメッセージを表示
です。
具体的には、input\_statusの状態を1つ増やして、それに合わせてメッセージgamemessageを追加します。
```python
input_status = 0 # 1 入力エラー 2 重複エラー 3 正解 4 手数オーバー
(省略)
gamemessage = []
mes_font = pygame.font.SysFont("yumincho", 40)
gamemessage.append(mes_font.render("エラー:数字が正しくない", True, (255, 0, 0)))
gamemessage.append(mes_font.render("エラー:数字が重複", True, (255, 0, 0)))
gamemessage.append(mes_font.render("CONGRATULATIONS", True, (255, 0, 0)))
gamemessage.append(mes_font.render("残念!手数オーバーです", True, (255, 0, 0)))
```
これで、手数オーバーの表示は完成です。
実行例:
図 手数オーバー
#### 正解時の手数の表示
60回以内に正解できた時は、おめでとうメッセージと共に何手で正解したか表示します。
ゲームオーバー(正解時)の表示処理を以下のように変更します。
```python
elif gamescene == 2:
screen.blit(gamemessage[input_status - 1], (100, 100))
screen.blit(gamebutton[2], gamebuttonrect)
if turn <= 60:
turnmss = mes_font.render(str(turn)+"回で正解しました!", True, (255, 255, 255))
screen.blit(turnmss, (120, 350))
```
60手以内に正解出来たら、手数を表示そのままの処理ですね。
実行してみます。
図 手数の表示
### 初期化の見直し
最後の最後に、各種変数の初期化の処理を見直します。
タイトル画面 →(初期化)→ ゲーム画面 → ゲームオーバー → タイトル画面 →(初期化)→ ゲーム画面・・・
このように、ゲームが始まる前にゲームの状態を初期化します。
初期化しなければならないものとして、手数、ターン数、表示位置・・・など様々なものがあります。
タイトル画面で、スタートボタンを押したときに初期化します。
```python
if gamebuttonrect.collidepoint(event.pos):
if gamescene == 0: # タイトル画面でスタートボタンが押された
question = make_question() # 問題を作成
# print(question) # デバッグ用に正解をコンソールに表示
players_input = [-1, -1, -1, -1] # プレイヤーの解答の初期値
gamescene = 1 # ゲームシーンをゲーム画面に遷移
input_status = 0 # 入力状態を初期化
turn = 0 # ターン数を0に初期化
input_pos = 0 # 入力位置(入力桁)の初期化
current_tab = 0 # 解答ログのページを初期値に
anslog.clear() # 解答ログを初期化
elif gamescene == 1:
if -1 in players_input: # ゲーム画面で「judgement」が押された
(省略)
```
これで繰り返し何回でもゲームができます(笑)
### 今回のまとめ
最後に、ゲームとしてのまとめをやってみました。
これまで、pygameを使って、ヒットアンドブローゲームを作るというお題で7回にわたってやってきました。
なんとなく、ゲームっぽいものができたのではないかなと思います。
難しい処理は特に行っていないので、いろいろ改造してみたり楽しんでみてください。
(ただ、ちょっとenchant.jsとか、XNAとかいじってきた私にとっては、pygameは使いづらいなぁって思いました。)
今回のソースコード一式はgithubにもあります。
[GitHub - gomta777/hitandblow: hit and blow game](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
の[finaledition](https://github.com/gomta777/hitandblow/tree/master/finaledition?ref=geekjp.com)が今回のものです。
ということで、一応今回で完成ということにしたいと思います。
よかったら、ブログ村↓のクリックお願いします。
### 【パズル No 7】じじいの謎解き No7 英単語穴埋めパズル 僕の名は?
URL: https://www.geekjp.com/2019-11-24-152302/
Last updated: 2019-11-24T06:23:02.000Z
英単語を、並べて、正解の単語を導きしてください。
答え合わせは以下のフォームからどうぞ。
分かっても答えは言わないでね(笑)
ヒントは[Twitter](https://twitter.com/crazyoldgeezers?ref=geekjp.com)のDMで
### 問題
#### ヒントを元に隠された4文字を導け! 僕の名は?
ヒントを元に(ほぼ答えですが)隠された4マスに入るアルファベットとを導き出して、その4文字で表されるものを答えてください。
### 答え合わせ
読み込んでいます…
### 【パズル No 6】じじいの謎解き No 6 情報系パズル? シフト謎解き
URL: https://www.geekjp.com/2019-11-24-041636/
Last updated: 2019-11-23T19:16:36.000Z
シフトして、シフトして謎を解け。
オリジナルなんで、どこにも答えはありません。
分かっても答えは言わないでね(笑)
解答は下の解答フォームから!
ヒントはTwitterのDMで
### 問題
#### 法則に従って答えを求めてください。
情報系の知識がある人は簡単に。。。解けないと思う。
悩んでもらえると、きっと解けたときめっちゃすっきりしますよ(笑)
### ヒントが欲しい人
[Twitter](https://twitter.com/crazyoldgeezers/status/1198320438591381504?s=20&ref=geekjp.com)のDMまで連絡ください!
### 正解がわかった人
読み込んでいます…
### 【pygame】pythonでヒット&ブローゲーム作る #06 ログの表示をかっこよく【簡単】
URL: https://www.geekjp.com/2019-11-24-023919/
Last updated: 2019-11-23T17:39:19.000Z
【pygame】pythonでヒット&ブローゲーム作る #06 ログの表示をかっこよく【簡単】

- [前回までのまとめ](#前回までのまとめ)
- [ログの表示枠](#ログの表示枠)
- [グリッド表示関数を作成](#グリッド表示関数を作成)
- [ページに合わせたデータ形式](#ページに合わせたデータ形式)
- [ページを表すリストを生成](#ページを表すリストを生成)
- [指定されたページを描画](#指定されたページを描画)
- [ページ数を表すタブを表示](#ページ数を表すタブを表示)
- [タブ表示関数の作成](#タブ表示関数の作成)
- [ページ切り替えの実装](#ページ切り替えの実装)
- [今回のまとめ](#今回のまとめ)
- [次回](#次回)
### 前回までのまとめ
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-015433/)
[【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-170123/)
[【python】ヒット&ブローゲーム作る #05 正誤判定、ログの表示【プログラミング】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-22-052748/)
前回までで、タイトル画面、ゲーム画面の状態遷移、

図 状態遷移
問題の出題と、解答の入力とチェック

図 解答の入力とチェック
最後に、ログの表示を(割と適当に)やりました。
図 解答ログの表示
これで一通りのゲームにはなるのですが、ログが15、6回で画面買いに流れてしまって見えなくなってしまいます。
今回はこれを解決するべく、**ログの表示をかっこ良いタブを使ったページ切り替えにしてみます!**
それでは、作っていくー(笑)
### ログの表示枠
まず初めに、ログの表示に枠を付けて、「それっぽく」してみます。
図 オブジェクトの配置
#### グリッド表示関数を作成
この配置を元に、関数を作っていきます。
解説と異なるフォントを使った人は、少し枠の大きさの調整が必要です。
文字を描画するのに必要な領域のサイズは、
Font.size 命令で取得できます。(今回は高さに30必要だったので、30がたくさん出てきてます)
```python
def draw_judgment_grid(surface):
bias = 90
pygame.draw.rect(surface, (255, 255, 255), (555, bias, 335, 30 * 15), 2)
for i in range(14):
pygame.draw.line(surface, (255, 255, 255), (555, bias + 30 * (i + 1)), (555 + 335, bias + 30 * (i + 1)), 2)
pygame.draw.line(surface, (255, 255, 255), (630, bias), (630, 30 * 18), 2)
pygame.draw.line(surface, (255, 255, 255), (728, bias), (728, 30 * 18), 2)
pygame.draw.line(surface, (255, 255, 255), (800, bias), (800, 30 * 18), 2)def draw_judgment_grid(surface):
bias = 90
pagesize = 15
baserect = Rect(555, 90, 335, 30)
pygame.draw.rect(surface, (255, 255, 255), \
(baserect.left, baserect.top, baserect.width, baserect.height * pagesize), 2)
for i in range(pagesize):
pygame.draw.line(surface, (255, 255, 255), \
(baserect.left, baserect.top + baserect.height * (i + 1)), \
(555 + 335, bias + 30 * (i + 1)), 2)
pygame.draw.line(surface, (255, 255, 255),\
(baserect.left + 75, baserect.top), (baserect.left + 75, baserect.top + baserect.height * pagesize), 2)
pygame.draw.line(surface, (255, 255, 255), \
(baserect.left + 173, baserect.top), (baserect.left + 173, baserect.top + baserect.height * pagesize), 2)
pygame.draw.line(surface, (255, 255, 255), \
(baserect.left + 245, baserect.top), (baserect.left + 245, baserect.top +baserect.height * pagesize), 2)
(省略)
if gamescene == 0:
screen.blit(title, titlepos)
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
draw_judgment_grid(screen)
(省略)
```
実行するとこんな感じになります。
図 ロググリッドの表示
### ページに合わせたデータ形式
これまでは、以下の様に「judgement」ボタンを押したときにリストanslogに、判断結果を順次追加していました。
```python
judge = judgement(players_input, question)
anslog.append("%02d 回目 " % turn + str(players_input) + \
" " + str(judge[0]) + " HIT " + str(judge[1]) + " BLOW")
turn += 1
```
これを、タブボタンによるページ切り替えで表示します。
今回考えてるページは、
- 1ページ15回分の記録
- 4ページ
- 上部のタブボタンでページ切り替え可能
図 タブとページのイメージ
#### ページを表すリストを生成
15(行)x4(ページ)を表すリストを生成します。
```python
baserect = Rect(555, 90, 335, 30) # ログの表示領域の一段分
pagesize = 15 # ページ当たりのログ数
pages = 4 #最大ページ数
judgement_pages = [["" for i in range(pagesize)] for j in range(pages)]
# 15x5ページ分のリストを用意します judgement_pages[ログ][ページ]
pygame.draw.rect(surface, (0,0,0), \
(baserect.left, baserect.top, baserect.width, baserect.height * pagesize))
# ログ表示領域の背景を黒で初期化
```
最後の行は、表示領域を見やすいように黒で初期化しているだけです。
次に、1次元的に、順次保存されているログを保存しているリスト(anslog)をページ分けしてあげます。
15個以上あった時は、次のページに保存してあげればいいですね。
if i\*pagesize+j < len(logmsg):
judgement\_pages\[i\]\[j\] = logmsg\[i\*pagesize+j\]
の部分で、ページに割り振りされています。
```python
# pages = 4
# pagesize = 15
# logmsgはanslogが実引数で渡されてくるはず
for i in range(pages):
for j in range(pagesize):
if i*pagesize+j < len(logmsg):
judgement_pages[i][j] = logmsg[i*pagesize+j]
# ログを、ページに書き写す 1次元配列→2次元配列化
```
#### 指定されたページを描画
データは準備できたので、指定されたページを描画します。
ここが、この処理の肝になる部分ですね。
```python
for i in range(pagesize):
if len(logmsg) != 0 and i == (len(logmsg) - 1) % pagesize:
# ログが空じゃなくて、iが指定ページの表示できる範囲内なら描画
pygame.draw.rect(surface, (100, 0, 0), \
(baserect.left, baserect.top + baserect.height * i, baserect.width, baserect.height))
# 一番新しいログは目立つように色を変える
text1 = fnt.render(judgement_pages[pagenum][i], True, (255, 255, 255))
surface.blit(text1, (baserect.left+5, baserect.height * i + baserect.top+10 - 3))
# 描画テキストを生成し描画
# 4ページあるうちの指定されたページのログを描画する
```
前ページの中から指定されたページの15個のログを表示しているだけです。ちょっと面倒ですが、よく読むとそんなに複雑ではないことがわかると思います。
これで、指定されたページのログが表示できます。
#### ページ数を表すタブを表示
タブを表示します。
ここにきてまた新しい画像を読み込まなければならないですが、説明は最小限にします。
図 タブ画像
ファイル名は、オレンジの方がtab1\~tab4.png、みどりのほうがtab1a\~tab4a.pngにしていますので、for文でループを作って読み込みやすくなっています。
処理に関しては、すでに説明済みのものばかりです。(数字ボタンの読み込みと表示の時と同じです)
```python
tabimagelist = []
tabimagename = []
for i in range(4):
tabimagename.append("tab"+str(i+1) + ".png")
for i in range(4):
tabimagelist.append(pygame.image.load("./images/" + tabimagename[i]))
atabimagelist = []
atabimagename = []
for i in range(4):
atabimagename.append("tab" + str(i + 1) + "a.png")
for i in range(4):
atabimagelist.append(pygame.image.load("./images/" + atabimagename[i]))
tabimagerect = []
for i in range(4):
tabimagerect.append(Rect(555 + i * 83, 90 - 39, 85, 40))
# baserect = Rect(555, 90, 335, 30) 描画領域から、タブの位置を逆算してます
# tab画像の大きさは 83x39で計算 描画は85x40で描画しています。
```
#### タブ表示関数の作成
次に、タブを描画する関数draw\_tabsを作ります。
```python
def draw_tabs(surface, tabnumber, tabimage, atabimage, tabrect):
baserect = Rect(555, 90, 335, 30) # ログの表示領域の一段分
tabsize = [83, 39]
for i in range(4):
if i == tabnumber: # 指定されたタブならば、赤いタブ画像
# surface.blit(tabimage[i], (baserect.left + i * tabsize[0], baserect.top - tabsize[1]))
surface.blit(tabimage[i], tabrect[i])
else: #それ以外は緑のタブ画像で表示
# surface.blit(atabimage[i], (baserect.left+i*tabsize[0], baserect.top - tabsize[1]))
surface.blit(atabimage[i], tabrect[i])
```
この辺は何度も出てきている描画処理の組み合わせなので、そんなには悩むところはないと思います。
読み込んだタブ画像を、実際に表示します。
現在表示しているタブは、オレンジで、その他のタブは緑で表示します。
結果の表示のあたりにこっそり入れてやります。
現在のタブは、まだ処理をしていないので、とりあえず変数current\_tab(現在のページを表す)
を作っておいて0(1ページ目)を指定しておきます。
```python
current_tab = 0
(省略)
draw_judgement_state(screen, log_font, anslog, current_tab)
draw_tabs(screen, current_tab, tabimagelist, atabimagelist)
draw_judgment_grid(screen)
```
実行結果:
図 タブの表示
#### ページ切り替えの実装
ページ切り替えの実装は、タブの表示領域を苦リクしたときに、押した画像の領域によってcurrent\_tabの番号を0\~3に切り替えて、ログ表示関数であるdraw\_judgement\_stateに私直す事で実現します。
```python
for i in range(len(tabimagerect)):
if gamescene == 1:
if tabimagerect[i].collidepoint(event.pos):
current_tab = i
```
また、「judgement」ボタンが正しく押されて、anslogが増えていくと自動的にcurrent\_tabを切り替えます。
現在のページ数は、ログの数を15で割った整数となります。
```python
current_tab = (len(anslog) - 1) // 15
```
これでページの切り替えができます。
実行結果:

図 タブの切り替え
1ページ目が埋まり、2ページ目にログが表示され、3,4ページ目はまだ空なのがわかります。
### 今回のまとめ
今回はログの表示をかっこよく、タブとページで実装してみました。
プログラム的にはちょっと面白いところだったのではないかなと思います。
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
のtabpaesが今回のものです。
次回は、最終回です。
ゲームとしてはほとんど完成したと思いますので、最後の細かいところを修正して完成としたいと思います!
よかったら、ブログ村↓のクリックお願いします。
### 【パズル No 5】じじいの謎解き No 5 法則を見抜け!
URL: https://www.geekjp.com/2019-11-23-194028/
Last updated: 2019-11-23T10:40:28.000Z
じじいのパズル No 5
法則を見抜いて答えを求めよ!
数学得意な人とか工学系の人はすぐわかるよね。
分かっても答えは言わないでね(笑)
ヒントはTwitterのDMで
答えがわかったら下の解答フォームで答え合わせできます。
### 問題
#### 法則を見抜いて答えを求めてください。
数学で習った人と習ってない人がいる法則かな?
私は習っていない世代です(笑)
### 答えがわかった人
以下の解答フォームに回答してください。
読み込んでいます…
### ヒントが欲しい人
[Twitter](https://twitter.com/crazyoldgeezers/status/1198188355617341440?s=20&ref=geekjp.com)のDMまで連絡ください!
正解したら、特に何も出ませんが、褒めます(笑)
### 【パズル No 4】じじいの謎解き No 4 連想パズル
URL: https://www.geekjp.com/2019-11-23-161026/
Last updated: 2019-11-23T07:10:26.000Z
絶対誰でも身に覚えがあると思います。
分かっても答えは言わないでね(笑)
答え合わせは下の解答フォームで!
### 問題
#### 何を表しているでしょうか?
数字を数えてみるとわかるかもね!
### ヒントが欲しい人
TwitterのDMまで連絡ください!
### 答えがわかった人
以下の解答フォームから答えてください。
解答チェックができます。
読み込んでいます…
[X(旧Twitter)の投稿を見る](https://twitter.com/crazyoldgeezers/status/1198173760924160001?ref%5Fsrc=twsrc%5Etfw&ref=geekjp.com)
### 【パズル No 2】じじいの謎解き No 2 穴埋めパズル
URL: https://www.geekjp.com/2019-11-23-002014/
Last updated: 2019-11-22T15:20:14.000Z
調子に乗ってもう1問パズルを考えてみたので解いてみてください。
分かっても答えは言わないでね(笑)
### 問題
#### ?に入る漢字を考えてください。
田舎者には馴染みのないやつです。。。
### 解答はこちらから
読み込んでいます…
### 【パズル No 1】じじいの謎解き No 1 単語埋めパズル
URL: https://www.geekjp.com/2019-11-22-160719/
Last updated: 2019-11-22T07:07:19.000Z
## パズルの時間 No 1
#### じじいの謎解き No 1 単語埋めパズル
突然ですがパズルを考えてみたので解いてみてください。
答えは言わないでね(笑)
### 問題
#### 4つの空欄を埋めて4つの単語を完成させてくださいx2
同じジャンルの単語が並んでいます。
片方解ければ片方は簡単です。
図 言葉のパズル
読み込んでいます…
### 【pygame】pythonでヒット&ブローゲーム作る #05 正誤判定、ログの表示【簡単】
URL: https://www.geekjp.com/2019-11-22-052748/
Last updated: 2019-11-21T20:27:48.000Z
- [【pygame】pythonでヒット&ブローゲーム作る #05 正誤判定、ログの表示【簡単】](#pygamepythonでヒットブローゲーム作る05正誤判定ログの表示簡単)
- [前回までのまとめ](#前回までのまとめ)
- [出題と正誤判定](#出題と正誤判定)
- [正誤判定](#正誤判定)
- [ログの表示](#ログの表示)
- [今回のまとめ](#今回のまとめ)
- [次回](#次回)
### 前回までのまとめ
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-015433/)
[【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-170123/)
前回は、数字の入力までを行えるようになりました。
今回は、出題の処理と、正誤判定、ログの判定をやっていきたいと思います。
出題と正誤判定は、テキストバージョンの関数をそのまま使います。
それでは、作っていくー(笑)
### 出題と正誤判定
初めにも書きましたが、出題と正誤判定はテキスト版のゲームで使用したものをそのまま使います。(使えます)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
```python
def has_not_duplicates(seq):
return len(seq) == len(set(seq))
def judgement(yin, ans):
h=0
b=0
for i in range(len(yin)):
if yin[i] == ans[i]:
h += 1
else:
if yin[i] in ans:
b += 1
return([h, b])
def make_question():
nums = list(range(10))
return(random.sample(nums, 4))
```
これらの関数を適切なタイミングで呼び出していきます。
まず出題ですが、ゲームスタートボタンを押したときに、問題が初期化されれば都合がよさそうです。また、このときに、プレイヤーの入力した数字が初期化されると、これまた都合がいいです。
すなわち、
```python
players_input = [] # プレイヤーの入力した数字
question = [] # 出題された数字
(省略)
if gamebuttonrect.collidepoint(event.pos):
if gamescene == 0: #gamesceneが0の時(タイトル画面の時)
question = make_question() # 問題を作成
players_input = [-1, -1, -1, -1] # プレイヤーの入力を初期化
gamescene = 1 # 状態を「ゲーム中」へ変更
```
これで、スタートボタンを押したときに、出題(question)とプレイヤーの入力(players\_input)が初期化されます。
この辺は画面に現れないので、各自print文でquestionとplayers\_inputを表示してみるなど試してみてください。
#### 正誤判定
スタートボタンが押され、状態が「ゲーム中」になると(gamescnene==1)、プレイヤーは、4桁の数字を入力して、ヒット数、ブロー数をかくにんして、それをヒントに正解になるまで繰り返し数字を入力します。
入力は、前回作成した通り、4桁の数字をを数字ボタンでを順にクリックすることで入力できます。
プレイヤーは、4桁の数字の入力が終わったら「Judgement」ボタンを押すことで、ヒット数、ブロー数の判定ができます
このとき、4ヒットが獲得できれば、クリアです。
これらの機能を実装していきます。
4桁の数字が入力されて「judgement」ボタンが押されたときの動作を考えてみます。
「judgement」ボタンが押されたときの状態は以下の3つが考えられます。
- 「judgement」ボタンが押されたときの状態
1. 数字が4桁入力されていない(エラー)
2. 数字に重複がある(エラー)
3. 数字が正しく入力されていて、正解である
4. 数字が正しく入力されているが、正解はしていない
これらの時の表示メッセージを切り替えてみます。
「数字が正しく入力されているが、正解はしていない」ときは、ヒット数、ブロー数のログを画面右のスペースに表示します。
まずは、エラーと正解のメッセージの処理を実装していきます。
タイトルの表示の時と同じように、メッセージ用のフォントを用意します。お好みでいいですが、このフォントで、入力数字が正しくないときのエラーと、数字が重複しているエラー、クリアおめでとう(Congratulations)の3種類のメッセージを表示します。
別に3つとも別のフォントで表示できますが、その時はその都度別フォントを読み込んでください。
また、エラー状態とクリア状態を表す状態変数 input\_statusを準備しておきます。
```python
input_status = 0 # 1 入力エラー 2 重複エラー 3 正解
gamemessage = []
mes_font = pygame.font.SysFont("yumincho", 40)
gamemessage.append(mes_font.render("エラー:数字が正しくない", True, (255, 0, 0)))
gamemessage.append(mes_font.render("エラー:数字が重複", True, (255, 0, 0)))
gamemessage.append(mes_font.render("CONGRATULATIONS", True, (255, 0, 0)))
```
これでエラー表示の準備ができました。
次に、実際にエラーの検知と正解の判定をしていきます。
不正入力エラーと数字の重複エラーの検知、正誤判定のタイミングはすべて「judgement」ボタンを押したときです。
それぞれの条件は、
- 不正入力エラー
- players\_inputのどこかの桁に初期値-1が残っている
- 数字重複エラー
- players\_inputの数字に重複がある
- 関数has\_duplicates(players\_input)で判定
- 正解か不正解か
- 関数judgement(players\_input, question)で判定
- 戻り値が\[4, 0\]の時が正解
正誤判定、重複判定は、テキストバージョンのものがそのまま使えます。
```python
if gamebuttonrect.collidepoint(event.pos):
# judgementボタンが押されたときに
if gamescene == 0:
question = make_question() # 問題の作成
# print(question) # デバッグ用に答えを表示
players_input = [-1, -1, -1, -1]
gamescene = 1 # ゲーム状態の初期化
input_status = 0 # エラー状態もリセットする
elif gamescene == 1:
if -1 in players_input: # 入力に初期値が残っている
input_status = 1 # 不正入力エラー
elif has_duplicates(players_input): # Trueの時は数字が重複
input_status = 2 # 数字重複エラー
else: # エラー以外の時は正誤判定をする
judge = judgement(players_input, question)
# judgeに判定結果が返される[Hit数, Blow数]
if judge[0] == 4: # ヒット数が4なら正解
input_status = 3 # Congratularions状態に遷移
gamescene = 2 # ゲームオーバー状態へ遷移
```
これで、エラー判定、正誤判定ができます。
まとめると
| gamescene | input\_status | 状態 |
| --------- | ------------- | ---------- |
| 0 | \- | タイトル画面 |
| 1 | 0 | 通常の入力状態 |
| 1 | 1 | 不正入力エラー |
| 1 | 2 | 数字重複エラー |
| 2 | 3 | 正解でゲームオーバー |
この条件で適切なメッセージを表示します。
```python
while running:
screen.fill((100, 100, 100)) # 背景色で塗る
if gamescene == 0:
screen.blit(title, titlepos)
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
if players_input[i] == -1:
screen.blit(qimagelist[10], qbuttonrect[i])
else:
screen.blit(qimagelist[players_input[i]], qbuttonrect[i])
for i in range(5): # 入力のためのボタンとなる画像0~4
screen.blit(imagelist[i], buttonrect[i])
for i in range(5, 10): # 入力のためのボタンとなる画像5~9
screen.blit(imagelist[i], buttonrect[i])
screen.blit(gamebutton[1], gamebuttonrect)
pygame.draw.rect(screen, (255, 0, 0), qbuttonrect[input_pos], 3)
if input_status > 0:
screen.blit(gamemessage[input_status-1], (80, 30))
#エラーメッセージを表示
elif gamescene == 2:
screen.blit(gamemessage[input_status - 1], (100, 100))
# 「Congratulations」表示
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
```
実行してみます。
図 エラーと正解メッセージの表示
「judgement」ボタンを押したときの反応を貼っておきます。
#### ログの表示
次に、正解を導くために肝心なヒット数、ブロー数のログを表示していきます。これがないと、正解を予測できませんね(笑)
ログ表示用のフォント(20pt)と現在まで答えた手数を表す変数turnを用意します。
```python
anslog = []
log_font = pygame.font.SysFont("yumincho", 20)
turn = 1 # 現在まで答えた手数(judgementボタンの押下数)
```
これを使って、judgementボタンを押すたびにログメッセージをanslogに追加してゆき、turnを+1します。
```python
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
if gamebuttonrect.collidepoint(event.pos):
if gamescene == 0:
question = make_question()
print(question)
players_input = [-1, -1, -1, -1]
gamescene = 1
input_status = 0
elif gamescene == 1:
if -1 in players_input:
input_status = 1
elif has_duplicates(players_input):
input_status = 2
else:
judge = judgement(players_input, question)
# ここから追加部分
anslog.append("%02d 回目 " % turn + str(players_input) + \
" " + str(judge[0]) + " HIT " + str(judge[1]) + " BLOW")
turn += 1
# ここまで追加部分
if judge[0] == 4:
input_status = 3
gamescene = 2
elif gamescene == 2:
gamescene = 0
else:
gamescene = -1
```
あとは適切なタイミングでログメッセージを表示してあげればよいです。
```python
#(省略)
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
if players_input[i] == -1:
screen.blit(qimagelist[10], qbuttonrect[i])
else:
screen.blit(qimagelist[players_input[i]], qbuttonrect[i])
for i in range(5): # 入力のためのボタンとなる画像0~4
screen.blit(imagelist[i], buttonrect[i])
for i in range(5, 10): # 入力のためのボタンとなる画像5~9
screen.blit(imagelist[i], buttonrect[i])
screen.blit(gamebutton[1], gamebuttonrect)
pygame.draw.rect(screen, (255, 0, 0), qbuttonrect[input_pos], 3)
if input_status > 0:
screen.blit(gamemessage[input_status-1], (80, 30))
# ここから追加部分
for i in range(len(anslog)):
text = log_font.render(anslog[i], True, (255, 255, 255))
screen.blit(text, (560, 30 * i + 100 - 3))
# ここまで追加部分
elif gamescene == 2:
#(省略)
```

図 ログの表示
### 今回のまとめ
今回は、「judgement」ボタンを押したときの反応を中心に進めてきました。「judgement」ボタンを押したときのエラー表示、正解の表示、入力ログの表示を実装しました。
実は、今回の実装にはちょっとした問題があります。
図 表示のバグ
ログの表示を、ただ座標をずらして繰り返しで表示しているので、画面の外にどんどんはみ出ていってしまいます。また、16回ぐらいまでは表示できますが、わりと15,6回で正解するのは、難しいかもしれません。何か工夫が必要ですよね。
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
のjudgementが今回のものです。
次回は、ログの表示を工夫してみます。
よかったら、ブログ村↓のクリックお願いします。
### 【日記】今日の珈琲 一関チャフのキリマンジャロを入れたら部屋がいい香り過ぎた【コーヒー部】
URL: https://www.geekjp.com/2019-11-20-000000/
Last updated: 2019-11-19T15:00:00.000Z
今日は、一関市のチャフのキリマンジャロを、カリタの手回しミルで細~中挽きにして、ハリオのV60でドリップしました。
### お豆
一関にあるチャフのキリマンジャロです。
焙煎は5~6ぐらいでしょうか。
- 焙煎の基本8段階
1. ライトロースト(Light roast)
2. シナモンロースト(Cinnamon roast)
3. ミディアムロースト(Medium roast)
4. ハイロースト(High roast)
5. **シティロースト(City roast)**
6. **フルシティロースト(Fullcity roast)**
7. フレンチロースト(French roast)
8. イタリアンロースト(Italian roast)
### グラインディング
カリタの手回しミルで細~中挽きにしました。
画像とるの忘れた(笑)
| |
| ---------------------------------- |
| カリタ Kalita コーヒーミル 手挽き ドームミル #42033 |
カリタの手挽きミルかわいいですよね。
挽き具合の調整がねじ式なので一回ちょっとした分解をしなければならないのですが、かわいさでカバーしてます。
欠点があるとすれば、一回に挽ける量(引き出しに入る量)とドームに収まる豆の量がマッチしてない(引き出しを収めた状態で中であふれていることがある)のかな、というのと、これはちょっと辛いのですが、冬場になると静電気で引き出しを開けた瞬間粉がふわーっと飛び散ってしまいます。
対策としては、
- ちょっと待ってから開ける
- 加湿器を使う
- アルミテープを貼る
- 静電気除去ブラシで掃除する
などがありますが、効果はどうでしょうね?(笑)
### ドリッピング
以前も紹介したハリオのV60でハンドドリップしました。
| |
| ---------------------------------------------------------- |
| HARIO (ハリオ) V60 透過 コーヒードリッパー 02 クリア コーヒードリップ 1\~4杯用 VD-02T |
ハリオ(HARIO)のV60は陶器製のものに比べて軽くて安くて扱いやすいです。伝統的な、陶器製のものと比べると、
- 円錐型
- 形状が円錐形をしており、お湯がコーヒー豆を通過する時間を長くできる
- 複雑なリブ
- 近年の加工技術でリブ(空気やお湯の通り道の溝)が複雑で効果的
- 丸穴
- 底に大きな丸穴一つだけなので、お湯の流れを妨げない
- ハンドドリップ時のお湯の量のコントロールが容易
という特徴があります。リブの効果などについてはいろいろ議論はありますが、円錐型と丸穴の効果は高いように思えます。(某社の一つ穴で目詰まりを起こしてクッソえぐいコーヒーになったりするようなことはないです(笑))
### 出来上がり
図 今日の珈琲
ちょっとグラインディングが細かすぎた気もしますが、飲んだ感じではちょうどよい感じでした。
- 香り
- 挽いたとき 、蒸らし中、ドリップ中ともキリマンジャロ豆特有の脳汁あふれる甘さのある香りが広がります
- 酸味
- よくキリマンジャロは酸っぱいとかいう人いますが、酸味を含んだコーヒーが抽出されるのはあっていると思いますが、酸っぱいという表現は違う気がします。
- 実際、チャフのキリマンジャロも少し深い焙煎度合いなのもあるのかもしれませんが、酸っぱみというよりは優雅な口当たりの酸味が感じられます
- コク
- 後味は、どちらかというとすっきりした感じです
- 飲んでいるときの、優雅な感じとは裏腹に、そんなに尾を引くしつこさはないです
- バランス
- 香りがよく、甘く、すっきりしたコーヒーでした。深めの焙煎ですが、苦みはあまり強くないです。
キリマンジャロ酸っぱいよ。とか言ってる人に飲ませたい珈琲ですね。
私は、酸味の少ない、苦みだけの珈琲はどうも苦手です。
チャフコーヒーはここにあります。マスターは結構面白い人なので、行ってみてはどうでしょうか?
### 【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】
URL: https://www.geekjp.com/2019-11-19-170123/
Last updated: 2019-11-19T08:01:23.000Z

- [【pygame】pythonでヒット&ブローゲーム作る #04 数字の入力【簡単】](#pygamepythonでヒットブローゲーム作る04数字の入力簡単)
- [前回までのまとめ](#前回までのまとめ)
- [タイトル画面の追加](#タイトル画面の追加)
- [数字の入力](#数字の入力)
- [入力位置の提示1 赤枠の表示](#入力位置の提示1赤枠の表示)
- [入力位置の提示2 赤枠の移動](#入力位置の提示2赤枠の移動)
- [数字の入力処理](#数字の入力処理)
- [入力された数字を画面に反映](#入力された数字を画面に反映)
- [次回](#次回)
### 前回までのまとめ
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-19-015433/)
前回は、画面構成を整えてみました。
今回は、プレイヤーの数字の入力を実装していきます。
もっと良い画面構成や、入力法もあるかと思いますが、初心者の考えたもんですので、大目に見てください。
### タイトル画面の追加
現在、ゲーム開始前の画面はこんな感じです。
図 ゲーム開始待ち
It's so dull...
画面が殺風景ですね。
数字の入力を追加する前に、なんか物足りないので簡易的なタイトル画面を追加してみます。
まずフォントを準備します。現在自分のシステムで使えるフォントの一覧を表示してみます。
```python
# フォントの用意
print(pygame.font.get_fonts()) # 使えるフォントの一覧を表示する
```
これを実行すると、コンソールに現在インストールされていてpygameから読み込み可能なフォントの一覧が表示されます。
```python
['arial', 'arialblack', 'bahnschrift', 'calibri', 'cambriacambriamath', 'cambria', 'candara', 'comicsansms', 'consolas', 'constantia',
(省略)
ゴシックcodejpmitalic源ノ角ゴシックcodejpr', 'bizudgothicbizudpgothictruetype', 'bizudgothicbizudpgothicboldtruetype', 'bizudminchomediumbizudpminchomediumtruetype', 'meiryomeiryomeiryouimeiryouiitalic', 'meiryomeiryoboldmeiryouiboldmeiryouibolditalic', 'msminchomspmincho', 'uddigikyokashonbuddigikyokashonpbuddigikyokashonkb', 'uddigikyokashonruddigikyokashonpruddigikyokashonkr', 'yumincho']
```
。。。いっぱい出ちゃった。
この中から使いたいフォント名をピックアップします。フォントの形状がわからない場合は、ワープロソフトやノートパッドなどで確認してみるといいです。
今回は、英文字のフォントでなるべくタイトルっぽくて太いものを使いたいので、'arialblack'を指定します。
pygameでフォントを使って文字を描画しいときには、以下のようにします。
```python
title_font = pygame.font.SysFont("arialblack", 50) # フォントの読み込みと作成
title = title_font.render("Hit & Blow !", True, (255, 0, 0)) # 描画するテキストの作成
titlepos = [150, 100] # 表示位置
screen.blit(title, *titlepos) # 作成したテキストの描画
```
実行してみます。

図 タイトル画面
何もないよりはましになったかも!
### 数字の入力
現在は*が表示されている入力欄に実際に数字を入力していきます。
現在の入力桁を表す枠を表示して、その枠のある桁に数字を入力していきます。
実は、ボタンの表示用にすでに枠になる矩形は作ってあります。**これを再利用します。**
#### 入力位置の提示1 赤枠の表示
```python
margin = [100, 100] # *を表示する位置までのマージン(前回設定済み)
imagesize = [100,100] # 画像1個当たりの大きさ(前回設定済み)
for i in range(4): #marginの位置から4つ横に画像を並べるためのもの
qbuttonrect.append(Rect(margin[0] + i * imagesize[1], margin[1], *imagesize))
for i in range(4):
pygame.draw.rect(screen, (255,0,0), qbuttonrect[i], 3)
```
- pygame.draw.rect(Surface, Color, Rect, Width)
- Surface
- 描画するサーフェス
- Color
- 描画色をRGBで指定
- Rect
- 描画する矩形領域Rect(左上x、左上y、幅、高さ)
- Width
- 線の太さ、デフォルトは0
これを実行すると、4桁すべてが赤枠で囲まれます。
図 赤枠の描画
#### 入力位置の提示2 赤枠の移動
数字が入力するたびに入力位置を、ずらしていきます。
画像で見るとこんな感じ
今入力しようとしている桁を表す**変数 input\_pos** を作ります。
input\_posの値は、一番左の桁の時0で一番右の桁の時3になり、その次また0に戻ってループするようにします。
つまり、ボタンが押されるたびに+1されて、3の時は0に戻る。
これを、0~9の画像がクリックされるたびに行います。
イベント処理の部分に以下を追加します
```python
input_pos = 0 # これは前の方で宣言しておく
# 現在の入力位置 左0123右 0,1,2,3の後は0に戻りループ
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
for i in range(len(buttonrect)): # すべての入力用数字画像でイベントをキャッチする
if buttonrect[i].collidepoint(event.pos):
if input_pos == 3:
input_pos = 0
else:
input_pos += 1
```
あとは、描画の部分でinput\_posの値に従って赤枠を描画します。
先ほどの赤枠の表示部分を以下の様に修正します。
ちなみ、pythonらしく、以下のように書いてもよかったんですが、
```python
for btn in buttonrect: # すべての入力用数字画像でイベントをキャッチする
if btn.collidepoint(event.pos):
if input_pos == 3:
input_pos = 0
else:
input_pos += 1
```
これでもいいんですが、後で繰り返しに使っているインデックスのiを使いたくなってしまったので、古き良きループにしました。
```python
margin = [100, 100] # *を表示する位置までのマージン(前回設定済み)
imagesize = [100,100] # 画像1個当たりの大きさ(前回設定済み)
for i in range(4): #marginの位置から4つ横に画像を並べるためのもの
qbuttonrect.append(Rect(margin[0] + i * imagesize[1], margin[1], *imagesize))
pygame.draw.rect(screen, (255,0,0), qbuttonrect[input_pos], 3)
```
これで赤枠が移動して、現在度の桁を入力しようとしているのかプレーヤーに伝えることができます。
#### 数字の入力処理
次はついに入力された数字を表示していきます。
また、同時にプレイヤーが答えた4桁の数字を表す変数を更新していきます。
まず、プレイヤーの入力した4桁の数字を表す変数を用意します。
テキストバージョンの時は毎回からのリストに4桁の数字を入力していましたが、今回は4つの要素を持つリストを作っておきます。
```python
players_input = [-1,-1,-1,-1]
```
この辺数に、input\_posを使って、押された数字を入力していきます。
数字ボタンを押したときのイベント処理を以下の様に書き換えます。
```python
for i in range(len(buttonrect)):
if buttonrect[i].collidepoint(event.pos):
players_input[input_pos] = i # ここでプレイヤーの入力を更新する
input_pos += 1
if input_pos == 4:
input_pos = 0
print(players_input)
```
実行結果:
```python
[1, -1, -1, -1]
[1, 2, -1, -1]
[1, 2, 6, -1]
[1, 2, 6, 7]
```
players\_inputが更新されているのがわかります。
#### 入力された数字を画面に反映
あとは実は簡単に、プレイヤーが入力した数字を画面に反映させることができます。
```python
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
screen.blit(qimagelist[10], qbuttonrect[i])
```
ここを書き換えていきます。
players\_input\[0\]\~players\_input\[3\]に、プレイヤーの入力した数字が保存されています。
初期状態では
\[-1, -1, -1, -1\]
です。数字が入力されると、その数字がそのまま整数で保存されています。
そこで、値が-1の場合は*の画像を、それ以外は数字の画像を表示するようにします。
qimagelist\[0\]\~\[9\]に0~9の画像、qimagelist\[10\]に*の画像が収まっています。
初期状態以外の時は、
qimagelist\[players\_input\[0\]\]で、最左桁の画像
qimagelist\[players\_input\[3\]\]で、最右桁の画像を設定します。
```python
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
if players_input[i] == -1: # 初期状態なら*の画像を表示
screen.blit(qimagelist[10], qbuttonrect[i])
else: # 数字が入力されていたら数字の画像を表示
screen.blit(qimagelist[players_input[i]], qbuttonrect[i])
```
実行してみます。
図 入力の様子1
図 入力の様子2
players\_inputに値が入力されると同時に、画面の入力された数字が更新されていくのがわかります。
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
のinputnumberが今回のものです。
次回は、履歴の表示と、正誤判定を仕上げていきたいと思います。
よかったら、ブログ村↓のクリックお願いします。
### 【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ【習作?】
URL: https://www.geekjp.com/2019-11-19-015433/
Last updated: 2019-11-18T16:54:33.000Z

- [初心者がpython3とpygameでヒット&ブローゲーム作ってみる #03 画面作るよ](#初心者がpython3とpygameでヒットブローゲーム作ってみる-03画面作るよ)
- [前回から](#前回から)
- [画面構成](#画面構成)
- [画面の作成 その1 入力欄](#画面の作成その1入力欄)
- [入力欄 描画処理を書く](#入力欄描画処理を書く)
- [入力用ボタンとなる数字画像の表示](#入力用ボタンとなる数字画像の表示)
- [入力用数字の画像を描画するコードの追加](#入力用数字の画像を描画するコードの追加)
- [次回](#次回)
### 前回から
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-16-184245/)
[【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-17-133208/)
前回は、テキストベースで作ったヒット&ブローゲームにpygameのガワをかぶせるべく、簡易的な状態遷移の処理を書いてみました。
今回は、画面の構成を作っていきます。
### 画面構成
完成イメージは、こんな感じです。

図 完成イメージ
左側上部に、答えの入力欄が数字4桁で、画面左側下部に0~9の数字が並んでいて、押した順に上部の入力欄に入力されます。
左側には、現在までの、解答の履歴と、その時のヒット数、ブロー数が一覧で並んでいます。
15回×4ページ分の履歴を保存できるようにします。それで答えられなかったらゲームオーバーです。
まず、入力欄から作っていきます。
#### 画面の作成 その1 入力欄
今回使う画像の一覧(次に使うのも入ってます。。。)は、以下のようになっています。
Webのフリー素材でもいいですし、適当にofficeの作図機能で作ってもいいと思います。
githubにもあるので、僕の作ったので良ければどうぞ。
図 画像一覧
初めに読み込む画像は、数字とアスタリスクの画像 \[00.png, 11.png, 22,png ~ 99.png, kome.png\] です。
読み込みやすいように、連番のファイル名にしておいたので、このファイル名が並んだリストを作ります。
画像は、プロジェクトフォルダ配下の「images」フォルダに全て納めてあります。
```python
qfilestr = [] # 画像ファイル名を生成するためのリスト
for i in range(10): # 問題の方の画像ファイルは 00.png~99.pngの名前になっている。
qfilestr.append(str(i)+str(i) + ".png") # 画像ファイル名を生成
```
次に、画面上での、解答欄の貼り付け位置を表す矩形(pygame.Rect型)を用意します。
数字1個当たりの画像の大きさは(幅、高さ)=(100,100)です。これを、図のように並べていきます。
```python
margin = [100, 100] # *を表示する位置までのマージン
imagesize = [100,100] # 画像1個当たりの大きさ
qbuttonrect = [] # *を表示するための矩形を作成 *のサイズは(100,100)
for i in range(4): #marginの位置から4つ横に画像を並べるためのもの
qbuttonrect.append(Rect(margin[0] + i * imagesize[1], margin[1], *imagesize))
```
これらを使って、いつものpygame.image.loadで読み込んでいきます。
ここまでの部分をまとめると以下のようになります。
```python
margin = [100, 100] # *を表示する位置までのマージン
imagesize = [100,100] # 画像1個当たりの大きさ
qfilestr = [] # 画像ファイル名を生成するためのリスト
qimagelist = [] # 出題用の画像を保存しておくリスト0~9+*の画像が収まっている。
for i in range(10): # 問題の方の画像ファイルは 00.png~99.pngの名前になっている。
qfilestr.append(str(i)+str(i) + ".png") # 画像ファイル名を生成
for i in range(10): # 画像の読み込み
qimagelist.append(pygame.image.load("./images/" + qfilestr[i]))
#[00.png, 11.png, 22.png … 99.png, kome.png]
qimagelist.append(pygame.image.load("./images/kome.png")) # *の画像の読み込み
qbuttonrect = [] # *を表示するための矩形を作成 *のサイズは(100,100)
for i in range(4): #marginの位置から4つ横に画像を並べるためのもの
qbuttonrect.append(Rect(margin[0] + i * imagesize[1], margin[1], *imagesize))
```
最後、連番の名前ではない、アスタリスクの画像(kome.png)を別口でロードしてリストに追加しているところに注意してください。
リストの中身は、\[00.png, 11.png, 22.png … 99.png, kome.png\] の順に並んでいます。(qimagelist\[10\] がkome.pngです)
#### 入力欄 描画処理を書く
先ほどの読み込んだ画像のリスト(qimagelist)と、それを貼り付けるための位置を表す矩形(qbuttonrect)をつかって、ゲーム画面に画像を貼り付けます。
処理自体は、qimagelist\[10\]のアスタリスク画像を、qbuttonrect\[0\]~qbuttonrect\[3\]の位置に貼り付けるだけですので簡単です。
```python
for i in range(4):
screen.blit(qimagelist[10], qbuttonrect[i])
```
問題はこれを**どこのタイミングで描画するか**、です。
前回やったシーン切り替えのことを考えると、スタートボタンが押されたら、ゲームが始まったほうがそれっぽいですよね。
ということで、
gamescene==1のとき、すなわちゲーム中の時に入力欄を表示するのが自然な気がします。
すなわち、前回のボタンを表示した部分で、以下の様に描画処理を書きます。
```python
if gamescene == 0:
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
for i in range(4):
screen.blit(qimagelist[10], qbuttonrect[i])
screen.blit(gamebutton[1], gamebuttonrect)
elif gamescene ==2:
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
```
これで、ゲームスタートを押すと****と、アスタリスクが4つ表示されるはずです。
図 入力欄の表示
### 入力用ボタンとなる数字画像の表示
入力用のボタンとなる数字画像(画面左側下部)を読み込んで表示します。
処理の内容は先ほどと変わらないので、コードのみ掲載しておきます。
```python
nmargin = [50, 350] # 入力ボタンのためのマージン
filestr = [] # 画像ファイル名を収めるリスト
for i in range(10): # 読み込む画像ファイル名のリストを作る
filestr.append(str(i) + ".png")
imagelist = [] # 読み込んだ画像のリスト
for i in range(10):
imagelist.append(pygame.image.load("./images/" + filestr[i])) #ファイルの読み込み
buttonrect = [] # 画像ファイルの貼り付け位置が収められたリスト(Rect型)
for i in range(5): # 0~4の画像の位置
buttonrect.append(Rect(nmargin[0] + i * imagesize[0], nmargin[1], *imagesize))
for i in range(5, 10): # 5~9の画像の位置
buttonrect.append(Rect(nmargin[0] + (i - 5) * imagesize[0], nmargin[1]+imagesize[1], *imagesize))
```
#### 入力用数字の画像を描画するコードの追加
これも同様に
gamescene==1の時に、描画されるように、追加します。
```python
if gamescene == 0:
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
screen.blit(qimagelist[10], qbuttonrect[i])
for i in range(5): # 入力のためのボタンとなる画像0~4
screen.blit(imagelist[i], buttonrect[i])
for i in range(5, 10): # 入力のためのボタンとなる画像5~9
screen.blit(imagelist[i], buttonrect[i])
screen.blit(gamebutton[1], gamebuttonrect)
elif gamescene ==2:
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
```
実行してみます。
game start ボタンを押すと、以下の画面が出れば成功です。
図 入力欄と入力ボタンの描画
なんとなく、どんな感じのゲームになるか見えてきましたね。
ここまでのソースコード一覧です。
```python
from pygame.locals import *
import pygame
import sys
import random
def main():
gamescene = 0 # 0 タイトル、1 ゲーム中、2 ゲームオーバー、-1 エラー
pygame.init() # Pygameを初期化
screen = pygame.display.set_mode((900, 600)) # 画面を作成
pygame.display.set_caption("Hit & Blow game")
gamebutton = []
gamebuttonrect = Rect(200, 250, 200, 50) # 画像の表示位置を表す矩形
gamebutton.append(pygame.image.load("./images/pushstart.png"))
gamebutton.append(pygame.image.load("./images/judge.png"))
gamebutton.append(pygame.image.load("./images/gameover.png"))
margin = [100, 100] # *を表示する位置までのマージン
imagesize = [100,100] # 画像1個当たりの大きさ
qfilestr = [] # 画像ファイル名を生成するためのリスト
qimagelist = [] # 出題用の画像を保存しておくリスト0~9+*の画像が収まっている。
for i in range(10): # 問題の方の画像ファイルは 00.png~99.pngの名前になっている。
qfilestr.append(str(i)+str(i) + ".png") # 画像ファイル名を生成
for i in range(10): # 画像の読み込み
qimagelist.append(pygame.image.load("./images/" + qfilestr[i]))
qimagelist.append(pygame.image.load("./images/kome.png")) # *の画像の読み込み
#[00.png, 11.png, 22.png … 99.png, kome.png]
qbuttonrect = [] # *を表示するための矩形を作成 *のサイズは(100,100)
for i in range(4): #marginの位置から4つ横に画像を並べるためのもの
qbuttonrect.append(Rect(margin[0] + i * imagesize[1], margin[1], *imagesize))
nmargin = [50, 350] # 入力ボタンのためのマージン
filestr = [] # 画像ファイル名を収めるリスト
for i in range(10): # 読み込む画像ファイル名のリストを作る
filestr.append(str(i) + ".png")
imagelist = [] # 読み込んだ画像のリスト
for i in range(10):
imagelist.append(pygame.image.load("./images/" + filestr[i])) #ファイルの読み込み
buttonrect = [] # 画像ファイルの貼り付け位置が収められたリスト(Rect型)
for i in range(5): # 0~4の画像の位置
buttonrect.append(Rect(nmargin[0] + i * imagesize[0], nmargin[1], *imagesize))
for i in range(5, 10): # 5~9の画像の位置
buttonrect.append(Rect(nmargin[0] + (i - 5) * imagesize[0], nmargin[1]+imagesize[1], *imagesize))
running = True
# メインループ
while running:
screen.fill((100, 100, 100)) # 背景色で塗る
# この時点では、 screen.blit(gamebutton[gamescene], gamebuttonrect) で済むけど、
# とりあえずは、if文でわけておく
if gamescene == 0:
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
for i in range(4): # 入力された数字を表示する領域
screen.blit(qimagelist[10], qbuttonrect[i])
for i in range(5): # 入力のためのボタンとなる画像0~4
screen.blit(imagelist[i], buttonrect[i])
for i in range(5, 10): # 入力のためのボタンとなる画像5~9
screen.blit(imagelist[i], buttonrect[i])
screen.blit(gamebutton[1], gamebuttonrect)
elif gamescene ==2:
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
for event in pygame.event.get():
if event.type == QUIT: # 終了イベント
running = False
pygame.quit() # pygameのウィンドウを閉じる
sys.exit() # システム終了
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
if gamebuttonrect.collidepoint(event.pos):
if gamescene == 0:
gamescene = 1
elif gamescene == 1:
gamescene = 2
elif gamescene == 2:
gamescene = 0
else:
gamescene = -1
pygame.display.update() # 描画処理を実行
if __name__ == "__main__":
main()
```
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
のcreategamescreenが今回のものです。
次回は、入力の処理を仕上げていきたいと思います。
よかったら、ブログ村↓のクリックお願いします。
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く まとめ 【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-18-144908/
Last updated: 2019-11-18T05:49:08.000Z
## R01基本情報技術者試験 秋期試験に挑戦
テクノロジ系の問題を解説し終わったので、まとめておきたいと思います。
良かったら活用してください!
### 令和元年度秋期 基本情報技術者試験 問1~問50解説
[基本情報といてみるよ - 工学じじいの縁側日記](https://www.geekjp.com/2019-10-30-113249/)
[R01基本情報技術者試験 秋期試験に挑戦 問3\~問6 - 工学じじいの縁側日記](https://www.geekjp.com/2019-10-30-042832/)
[R01基本情報技術者試験 秋期試験に挑戦 問7\~問10 - 工学じじいの縁側日記](https://www.geekjp.com/2019-10-31-014254/)
[R01基本情報技術者試験 秋期試験に挑戦 問11\~問15 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-01-005609/)
[R01基本情報技術者試験 秋期試験に挑戦 問16\~問20 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-01-203250/)
[R01基本情報技術者試験 秋期試験に挑戦 問21~問25 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-03-013915/)
[R01基本情報技術者試験 秋期試験に挑戦 問26~問31 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-05-022118/)
[R01基本情報技術者試験 秋期試験に挑戦 問32~問35 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-06-230843/)
[R01基本情報技術者試験 秋期試験に挑戦 問36~問40 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-08-191030/)
[R01基本情報技術者試験 秋期試験に挑戦 問41~問45 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-13-145512/)
[R01基本情報技術者試験 秋期試験に挑戦 問46~問50 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-18-142904/)
各記事で、問1~問50までの問題を解説しています。
なるべく丁寧かつ、必要な知識とその周辺知識を埋めるように解説していこうと思っています。
図表などは、すべて自分で作っていますので、転載などはご遠慮願います。
(したからって別に訴えたりしないですが、へたくそな図画で回るのが恥ずかしい。。。)
もし、何かで使いたいときはコメントででもご一報願います。
また、誤字脱字、説明の誤りなどありましたら是非ご指摘ください。
良かったら、押してください!↓↓↓
にほんブログ村
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問46~問50 【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-18-142904/
Last updated: 2019-11-18T05:29:04.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、今回も問題解いていきまーす。
### 令和元年度 基本情報技術者試験 午前問題 問46~問50
#### 令和元年度 基本情報技術者試験 午前問題 問46
モジュール結合度が最も弱くなるものはどれか。
| ア | 一つモジュールで、できるだけ多くの機能を実現する |
| - | -------------------------------------------- |
| イ | 二つのモジュール間で必要なデータ項目だけを引数として渡す |
| ウ | ほかのモジュールとデータ項目を共有するためにグローバルな領域を使用する。 |
| エ | ほかのモジュールを呼び出すときに、呼び出したモジュールの論理を制御するための引数を渡す。 |
#### 解説
ソフトウェアを設計するときのモジュール分割の問題です。
学生の時、ソフトウェア設計演習の先生に、C言語でモジュールを作るとか言われて、このおっさん何言ってんだ?って思ってましたが、このような設計の概念はオブジェクト指向言語が普及して結構理解しやすくなったのではないかなと思います。C言語では、厳密には違うのかもしれないですがモジュール=関数と思ってもまぁまぁ間違いではないと思います。
まず用語についてまとめてみたいと思います。
モジュールと似たような意味で使われる言葉に以下のようなものがあります。
| モジュール | コンポーネント |
| ----- | ------- |
| ライブラリ | パッケージ |
| プラグイン | セグメント |
なんとなくぼんやり、文脈に従って使っていましたが、まじめに意味を調べてまとめてみます。
| モジュール | 1つの機能単位で分割されたプログラムを指す。入出力のインターフェースが規格化されていて、同規格において容易に追加や削除、交換ができる。C言語でいえば単独でコンパイルできる単位になる。 |
| ------- | ------------------------------------------------------------------------------------------- |
| コンポーネント | 何らかの機能を持ったプログラムの部品。単独では意味をなさず、ほかのプログラムと組み合わせて使う。 |
| ライブラリ | 様々なモジュールを集めて一つにまとめたもの。 |
| パッケージ | 様々なライブラリを集めて一つにまとめたもの。 |
| プラグイン | ある機能への拡張機能を提供するためのプログラムやモジュール |
まとめてもいまいちわからないw
とりあえずモジュールは、一つの機能をもって分割されたプログラムの部品=C言語では入出力を規定された関数と思っておけばいいかなと思いました。
次に、モジュール結合度ですが、モジュール分割を行う際に設計したモジュール同士の関係性の評価として以下のようなことが言われています。
| | 良い設計例 | 悪い設計例 |
| --------- | ---------------------------------------------------- | -------------------------------- |
| モジュール分割 | モジュール分割技法を使って、適切にモジュールを分割する。・STS分割・トランザクション分割・共通機能分割 | モジュール分割を行わない。または、個人的なモジュール分割を行う。 |
| モジュールの凝集度 | 高い(機能的凝集/情報的凝集) | 低い(論理的凝集) |
| モジュール結合度 | 弱い(データ結合/スタンプ結合) | 強い(共通結合/外部結合/制御結合) |
問題となっているモジュール結合度は、モジュール間の関連性の強さを示す尺度です。モジュール結合度が弱いほど、モジュールの独立性は高くなります。
| 内容結合 | 外部宣言していないデータを他のモジュールが直接に参照・更新 |
| ------ | --------------------------------------- |
| 共通結合 | 複数のモジュールが共通領域のデータ構造を共有して参照・更新 |
| 外部結合 | 外部宣言されたデータを複数のモジュールで共有。必要なデータのみを外部宣言する。 |
| 制御結合 | 機能コードを受け渡し、呼ばれたモジュールの実行を制御する。 |
| スタンプ結合 | データの構造体を受け渡す。呼ばれたモジュールは構造体の一部を使用する。 |
| データ結合 | 処理に必要なデータのみを受け渡す。モジュール間での機能的な関係はない。 |
これを知らなくても、内容から考えてモジュール同士の独立性が高くなりそうなのを選べばいいんですけど、全部見ていきます。
| ア | 一つモジュールで、できるだけ多くの機能を実現する |
| - | ------------------------ |
上で出てきた、モジュールの凝集度の話でモジュール間の結合性の話ではないので×
| イ | 二つのモジュール間で必要なデータ項目だけを引数として渡す |
| - | ---------------------------- |
データ結合の説明に合致します。一番結合度の低い設計です。
| ウ | ほかのモジュールとデータ項目を共有するためにグローバルな領域を使用する。 |
| - | ------------------------------------ |
外部結合や共通結合の説明です。外部にデータ構造を持っているときが共通結合、単一データの時が外部結合になります。
| エ | ほかのモジュールを呼び出すときに、呼び出したモジュールの論理を制御するための引数を渡す。 |
| - | -------------------------------------------- |
制御結合の例ですね。
正解は「イ」
ちなみに、かなりいろいろなところで間違えていますが、モジュールの凝集度の説明で**暗号的凝集**と書いているところがかなり多いですが、英語の**Coincidental cohesion**を訳したもので、「暗合的」または、「偶発的」が正しいです。
凝集度の話は、また今度!
#### 令和元年度 基本情報技術者試験 午前問題 問47
エラー埋め込み法において、埋め込まれたエラー数を S、埋め込まれたエラーのうち発見されたエラー数を m、埋め込まれたエラーを含まないテスト開始前の潜在エラー数を T、 発見されたエラー数をnとしたとき、S, T, m, n の関係を表す式はどれか。
| ア | \\(\\frac{m}{S} = \\frac{n -m}{T}\\) |
| - | ------------------------------------ |
| イ | \\(\\frac{m}{S} = \\frac{T}{n -m}\\) |
| ウ | \\(\\frac{m}{S} = \\frac{n}{T}\\) |
| エ | \\(\\frac{m}{S} = \\frac{T}{n}\\) |
#### 解説
ソフトウェアに潜在するエラー数を推定する方法である、エラー埋め込み法の問題です。プログラムに意図的にエラーを埋め込んだ状態でテストを行い、テストで発見された埋め込みエラー数からまだ発見されていない潜在エラー(真のエラー)数を推測する手法です。
S = 埋め込まれたエラー数
m = 埋め込まれたエラーのうち発見されたエラー数
T = 埋め込まれたエラーを含まないテスト開始前の潜在エラー数
n = 発見されたエラー数
埋め込まれたエラーの発見率と、潜在的に存在するエラーの発見率は同じになるはずです。
潜在的に存在するエラーのうちテストで発見された数は、全発見エラー数ー埋め込みエラー数のうち発見されたエラー数
=n-m
埋め込まれたエラーの発見率は、\\(\\frac{m}{S}\\)
潜在エラーの発見率は、\\(\\frac{n-m}{T}\\)
したがって、以下が成り立ちます。
\\(\\frac{m}{S} = \\frac{n-m}{T}\\)
#### 令和元年度 基本情報技術者試験 午前問題 問48
テストで使用するスタブまたはドライバの説明のうち、適切なものはどれか。
| ア | スタブは、テスト対象モジュールからの戻り値の表示・印刷を行う。 |
| - | --------------------------------- |
| イ | スタブは、テスト対象モジュールを呼び出すモジュールである。 |
| ウ | ドライバは、テスト対象モジュールから呼び出されるモジュールである。 |
| エ | ドライバ、引数を渡してテスト対象モジュールを呼び出す。 |
#### 解説
テスト環境におけるダミーの利用に関する問題です。
複数人での開発現場では、前問のようにモジュール分けをしてモジュールごとの開発を行っていきますが、テスト段階ですべてのモジュールが完成していないと、完全なテストは行えません。そこで、開発済みのモジュール以外は、テスト用の入出力だけを実装したダミーモジュールを使って、開発されたモジュールをテストしていきます。このように、上位と下位のモジュールをつなぎ合わせて繰り返し試験する手法を「結合テスト」と呼びます。
結合テストは大きく分けて2種類あり、
1. テスト対象のモジュールを呼び出すダミーモジュールを作成し、問題がなければ本物の呼び出しモジュールと置き換えて、最上位の呼び出しモジュールまでをテストするボトムアップテスト
2. テスト対象のモジュールに呼び出されるダミーモジュールを作成し、問題がなければ本物の呼び出されるモジュールと置き換えて、最下位の呼び出されるモジュールまでをテストするトップダウンテスト
図 結合テスト
これらを踏まえて選択肢を見ていきます。
| ア | スタブは、テスト対象モジュールからの戻り値の表示・印刷を行う。 |
| - | ------------------------------- |
スタブはテスト対象から呼び出されるダミーモジュールですので、これはなんか違います。
| イ | スタブは、テスト対象モジュールを呼び出すモジュールである。 |
| - | ----------------------------- |
スタブはテスト対象から呼び出されるダミーモジュールです。ドライバなら正解ですね。
| ウ | ドライバは、テスト対象モジュールから呼び出されるモジュールである。 |
| - | --------------------------------- |
逆にドライバはテストモジュールを呼び出すためのダミーモジュールです。スタブなら正解ですね。
| エ | ドライバ、引数を渡してテスト対象モジュールを呼び出す。 |
| - | --------------------------- |
ドライバは、テストモジュールを呼び出して結合テストを行いますので、これが正解です。
以上から、正解は「エ」です。
#### 令和元年度 基本情報技術者試験 午前問題 問49
単一の入り口を持ち、入力項目を用いた複数の判断を含むプログラムのテストケースを設計する。命令網羅と条件判定網羅の関係のうち、適切なものはどれか。
| ア | 判定条件網羅を満足しても、命令網羅を満足しない場合がある。 |
| - | ------------------------------ |
| イ | 判定条件網羅を満足するならば、命令網羅も満足する。 |
| ウ | 命令網羅を満足しなくても、判定条件網羅を満足する場合がある。 |
| エ | 命令網羅を満足するならば、判定条件網羅も満足する。 |
#### 解説
前問に続き、単体(ユニット)テスト関連の出題です。
単体テストは、モジュールの仕様のどの部分に注目してテストするかによって以下の2つに分類されます。
| ホワイトボックステスト | プログラムの内部構造に注目し、論理を実現するために使われている命令や、分岐が正しく動作するか、といった部分についてチェックをする。 |
| ----------- | ---------------------------------------------------------------------- |
| ブラックボックステスト | モジュールの外から見た機能(入出力)に着目し、入力データと出力データの結果だけに着眼し、それが仕様書どおりに正しく処理されているかを調べる。 |
問題文を読むと、内部の処理構造に注目しているのでホワイトボックステストについての出題であることがわかります。
- 関数・メソッド中のすべての命令を実行する命令網羅(ステートメントカバレッジ)
- 分岐条件の全てで真/偽の両方の分岐を通るようにする判定条件網羅(デシジョンカバレッジ、または分岐網羅、ブランチカバレッジ)
などを行うので、条件や、命令を網羅するための値の抽出が必要で、抽出した条件から、どの程度の条件を満たしたかという網羅率(カバレッジ)の解析を行ったりします。
プログラムの中で、処理の通り道が切り替わるのは条件分岐の処理のみです。
したがって、テストの時にすべてのパターンを網羅しない可能性があるのは、分岐の全パターンを網羅していない時です。
逆に言うと、すべての処理パターンを網羅していても、すべての分岐パターンは網羅できません。
言葉で書くと、ちょっとわかりづらいですね(笑)
図で見てみます、色のついた矩形が「処理」を表しています。
図 処理の分岐
条件網羅でのテストを考えてみます。
存在するすべての条件分岐に対して、Yes、No全てを通るようにテストするので、以下のようになります。
図 条件網羅
次に、命令網羅でのテストを考えてみます。
図 命令網羅
命令網羅では、命令がすべて実行されるようにテストを行いますが、分岐に関しては、命令が実行されるほうのみテストされますので、左図のように条件をすべてテストするわけではないのがわかります。
これを踏まえて、選択肢を見ていきます。
| ア | 判定条件網羅を満足しても、命令網羅を満足しない場合がある。 |
| - | ----------------------------- |
条件判定網羅をしているとすべての分岐を通るようにテストしますので、命令網羅は必ず満たされます。ので×です。
| イ | 判定条件網羅を満足するならば、命令網羅も満足する。 |
| - | ------------------------- |
これは、合ってそうですね。
| ウ | 命令網羅を満足しなくても、判定条件網羅を満足する場合がある。 |
| - | ------------------------------ |
命令を網羅を満足していなくても、判定条件網羅を満足する場合は、ないですよね。判定条件網羅ではすべての分岐を通っていますので、命令はすべて網羅されます。が、逆はないですよね。
| エ | 命令網羅を満足するならば、判定条件網羅も満足する。 |
| - | ------------------------- |
これも、ウと同じ理由で×ですね。
答えは「イ」です。なんかほとんど国語の問題。。。
#### 令和元年度 基本情報技術者試験 午前問題 問50(テクノロジ系最終問題)
XP(eXtreme Programming)において、プラクティスとして提唱されているものはどれか。
| ア | インスペクション | イ | 構造化設計 |
| - | --------- | - | --------- |
| ウ | ペアプログラミング | エ | ユースケースの活用 |
#### 解説
XP(eXtreme Programming)は、アジャイル開発手法の代表格です。
従来行われてきたウォーターフォール型などの、要件定義から段階的に上流工程から下流工程へ進む手法では、前の工程への変更や修正に対して融通が利かないという弱点がありました。
これらを、開発工程を小さな部分に分け、小さな開発サイクルを繰り返して開発を進めるという手法です。
その中で、4つの価値、14の原則、19のプラクティス
4(5)つの価値
- コミュニケーション
- 単純さ
- フィードバック
- 勇気
- (リスペクト)
14の原則
| 人間性 | 経済性 | 相互利益 | 自己相似性 | 改善 |
| --- | ----- | -------- | ------- | --- |
| 多様性 | ふりかえり | 流れ | 機会 | 冗長性 |
| 失敗 | 品質 | ベイビーステップ | 責任の引き受け | |
19のプラクティス
- 共同のプラクティス
1. イテレーション
2. 共通の用語
3. オープンなワークスペース
4. ふりかえり
- 開発のプラクティス
1. テスト駆動開発
2. ペアプログラミング
3. リファクタリング
4. ソースコードの共同利用
5. 継続的インテグレーション
6. YAGNI(You ain't gonna need it)
- 管理者のプラクティス
1. 責任の受け入れ
2. 援護
3. 四半期ごとの見直し
4. ミラー
5. 最適なペース
- 顧客のプラクティス
1. ストーリー
2. リリース計画
3. 受入テスト
4. 短期リリース
これを、如実に実行できる現場は少ないと思いますが、アジャイル開発では著名な開発手法です。
答えは「ウ」ペアプログラミングです。
ペアプログラミングでは、支援者と作業差に分かれて1台の端末を共有しながら開発を進めます。
ペアは、或る程度の時間で入れ替えや交代を行うのが良いとされています。
### 次回予告
今回で、テクノロジ系の問題全問解説しました。
次は、どこに向かおうか迷っています(笑)
良かったら、押してください!↓↓↓
にほんブログ村
### 【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02【習作?】
URL: https://www.geekjp.com/2019-11-17-133208/
Last updated: 2019-11-17T04:32:08.000Z

- [初心者がpython3とpygameでヒット&ブローゲーム作ってみる #02](#初心者がpython3とpygameでヒットブローゲーム作ってみる-02)
- [前回から](#前回から)
- [画面遷移](#画面遷移)
- [シーン遷移(もどき)](#シーン遷移もどき)
- [実装(設計)](#実装設計)
- [超簡単にシーン切り替えの実装](#超簡単にシーン切り替えの実装)
- [実装](#実装)
- [状態遷移の処理](#状態遷移の処理)
- [動作確認](#動作確認)
- [完成したソースコード一覧](#完成したソースコード一覧)
- [次回](#次回)
### 前回から
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/16/184245](https://www.geekjp.com/2019-11-16-184245/)
前回は、テキストベースでコンソール画面(コマンドプロンプト)で動作するヒット&ブローゲームを作ってみました。
折角pygameがあるので、ガワを作っていきます。
解説では、画像の貼り付けの基本やpygameの初期化などは省略しています。
その辺は、過去記事で確認してください。
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/10/06/143046](https://www.geekjp.com/2019-10-06-143046/)
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/10/07/195352](https://www.geekjp.com/2019-10-07-195352/)
### 画面遷移
普段ゲームをしていると、あまり気にしませんが、一般的にゲームはいくつかのシーンからできています。
昔ながらのビデオゲームは大体
1. タイトル画面
2. ゲーム画面
3. ハイスコア・ゲームオーバー画面
をぐるぐる繰り返して、ゲームとして動作します。
それぞれ、タイトル画面からは、ゲーム画面にのみ、ゲーム画面からは、ハイスコア・ゲームオーバー画面にのみ、ハイスコア・ゲームオーバー画面からはタイトル画面へのみ、画面が移動します。
タイトル→ゲーム画面→ゲームオーバー画面→タイトル→・・・
それぞれを、ゲームの状態とすると、3つの状態が考えられるということになります。
| 状態番号 | 状態 |
| ---- | ------- |
| 0 | タイトル |
| 1 | ゲーム中 |
| 2 | ゲームオーバー |
ゲームライブラリの中では、シーン遷移を標準で持っているものも結構あります。
何個かのシーンを定義しておいて、シーンをスワップしたり、ポップ、プッシュしたりいろいろ制御できたりします。
pygameではそのような機構は備えられていないので、自前で何とかします。
#### シーン遷移(もどき)
pygameでシーン遷移もどきを実装する方法を考えます。
pygameの主な処理は、簡単には
- データの初期設定
- ループ
- データの更新処理
- イベント処理
- 描画処理
という流れになるかと思います。
疑似的にシーン遷移を表すために、以下の様に処理をします。
シーン0、シーン1、シーン2があったとして
- データの初期設定
- ループ
- データの更新処理
- 現在のシーンの遷移処理
- イベント処理
- 描画処理
- if scene == 0 then シーン0の描画
- elif scene == 1 then シーン1の描画
- ellif scene == 2 then シーン2の描画
途中で、条件を満たしたら現在のシーン(カレントシーン)が次のシーンへと遷移する、状態遷移の処理を行います。
そして、描画処理で現在のシーンに従った画面を描画する。
という流れで処理をすると、状態遷移の処理と、描画処理が完全に切り分
けて行えます。
つまり、データ更新の部分では、状態遷移や、各種データを更新するだけ。
描画部分では、シーンと各種データに従って描画処理のみを行う。てな風に、完全に仕事を分けて処理を行います。
### 実装(設計)
シーン遷移の処理を実装していきます。
シーンを表すものとして、
gamescene という変数を準備します。
そして、数値(状態番号)でシーンを表します。
| 状態番号 | 状態 |
| ---- | ------- |
| 0 | タイトル |
| 1 | ゲーム中 |
| 2 | ゲームオーバー |
if タイトル画面中にスタートボタンが押された:
gamescene = 1
elif ゲーム画面中にゲームオーバーになった:
gamescene = 2
elif ゲームオーバー中にリトライボタンを押した:
gamescene = 0
としておき、
描画部分では、
if gamescene == 0:
タイトル画面描画
elif gamescene == 1:
ゲーム中画面描画
elif gamescne == 2:
ゲームオーバー画面表示
と、表示のみにとどめてデータの更新はしないものとします。
さっき書いた、処理の切り分けですね。
### 超簡単にシーン切り替えの実装
簡単にシーン遷移もどきを作ってみます。
画像を表示して、画像をクリックするたびに状態が
タイトル画面(Push Start) → ゲーム画面(Judgement) → ゲームオーバー画面(game over) → タイトル画面。。。
と、状態が切り替わります。
画像は適当にフリー素材などを使います。
(私は、power pointの作図で作りました。ほしい方は、githubからどうぞ、
[https://github.com/gomta777/hitandblow/tree/master/gamescnene/](https://github.com/gomta777/hitandblow/tree/master/gamescnene/?ref=geekjp.com))
#### 実装
シーンを表す変数を用意します。初期状態は0(タイトル画面)としておきます。
```python
gamescene = 0 # 0 タイトル、1 ゲーム中、2 ゲームオーバー、-1 エラー
```
画像を3枚(push start, judgement, game overのもの)を読み込みます。
./images/ の部分は自分のフォルダ構成に合わせて変更してください。
```python
gamebutton = []
gamebuttonrect = Rect(200, 250, 200, 50) # 画像の表示位置を表す矩形
gamebutton.append(pygame.image.load("./images/pushstart.png"))
gamebutton.append(pygame.image.load("./images/judge.png"))
gamebutton.append(pygame.image.load("./images/gameover.png"))
```
gamebuttonrectは、表示領域を表す矩形で、後でクリック判定にも使います。pygameには画像自体にイベントを発生させる機能がないため、矩形を設定しておいて、クリック検出します。
描画処理を書きます。
```python
running = True # メインループ
while running:
screen.fill((100, 100, 100)) # 背景色で塗る
# この時点では、 screen.blit(gamebutton[gamescene], gamebuttonrect) で済むけど、
# とりあえずは、if文でわけておく
if gamescene == 0:
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
screen.blit(gamebutton[1], gamebuttonrect)
elif gamescene ==2:
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
for event in pygame.event.get():
if event.type == QUIT: # 終了イベント
running = False
pygame.quit() # pygameのウィンドウを閉じる
sys.exit() # システム終了
pygame.display.update() # 描画処理を実行
```
これで、とりあえず、gamesceneに従って別のものを表示する処理ができます。
gamesceneの初期値が0の時は、push startの画像が表示されますが、初期氏を変更すると別の画像が表示されることを確認しましょう。
#### 状態遷移の処理
状態遷移といっても、今回はgamesceneの値を、あるトリガー(画像領域のクリック)に従って変更するだけです。
pygameでは、左クリックの検出は以下のように書けます。
```python
for event in pygame.event.get():
if event.type == QUIT: # 終了イベント
running = False
pygame.quit() # pygameのウィンドウを閉じる
sys.exit() # システム終了
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
# ここに、クリックされたときの処理を書く
```
画像を、ゲーム内のオブジェクトとして読み込めて、それにイベントリスナーを…みたいな処理ができれば楽なんですけどね(笑)
そのようなことはできませんので、ゲーム画面内の領域を指定してその領域内がクリックされたかどうかで判断します。
前提その1:左クリックが検出されると(検出したevent.typ がpygame.MOUSEBUTTONUPの時)、event.posには、自動的にクリックした画面内の座標が収まっています。
前提その2:Rect型には、いくつかの当たり判定のためのメソッド(関数)が用意されていて、Rectとposの判定は、Rect.collidepointメソッドで取得できる。
```python
Rect.collidepoint
点座標がRectオブジェクトの描写範囲内にあるか調べます。
Rect.collidepoint(x, y): return bool
Rect.collidepoint((x,y)): return bool
引数として設定した座標がRectオブジェクトの描写範囲内にある場合はtrueが戻り値として返されます。
指定した座標がRectオブジェクトの右辺上や下辺上にある場合、その座標はRectオブジェクト内部にあるとは見なされません。
```
pygameドキュメントより引用
あらかじめ、画像を表示する領域として
```python
gamebuttonrect = Rect(200, 250, 200, 50) # 画像の表示位置を表す矩形
```
を用意しておいたので、この矩形の中にクリックした点(event.pos)があった時に、状態を変更する処理を書きます。
```python
for event in pygame.event.get():
# 終了処理の部分は省略
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
if gamebuttonrect.collidepoint(event.pos):
# 画像領域がクリックされたとき
if gamescene == 0: # ゲーム画面へ
gamescene = 1
elif gamescene == 1: # ゲームオーバー画面へ
gamescene = 2
elif gamescene == 2: # タイトル画面へ戻る
gamescene = 0
else:
gamescene = -1 # エラー
```
何のことはない、if文を使って、ボタンが押されるたびに次の状態に変更しているだけですね。
#### 動作確認
動画にしようと思いましたが、そこまでするまでもないかなという結論に至りました(笑)
ボタンを押すたびに、画像が切り替わるのが確認できると思います。

図 画像の変化
### 完成したソースコード一覧
今回書いたもののまとめです。
初めにも書きましたが、解説では画像の貼り付けの基本やpygameの初期化などは省略しています。その辺は過去記事を参照してみてください。
```python
from pygame.locals import *
import pygame
import sys
import random
def main():
gamescene = 0 # 0 タイトル、1 ゲーム中、2 ゲームオーバー、-1 エラー
pygame.init() # Pygameを初期化
screen = pygame.display.set_mode((900, 600)) # 画面を作成
pygame.display.set_caption("Hit & Blow game")
gamebutton = []
gamebuttonrect = Rect(200, 250, 200, 50) # 画像の表示位置を表す矩形
gamebutton.append(pygame.image.load("./images/pushstart.png"))
gamebutton.append(pygame.image.load("./images/judge.png"))
gamebutton.append(pygame.image.load("./images/gameover.png"))
running = True
# メインループ
while running:
screen.fill((100, 100, 100)) # 背景色で塗る
# この時点では、 screen.blit(gamebutton[gamescene], gamebuttonrect) で済むけど、
# とりあえずは、if文でわけておく
if gamescene == 0:
screen.blit(gamebutton[0], gamebuttonrect)
elif gamescene == 1:
screen.blit(gamebutton[1], gamebuttonrect)
elif gamescene ==2:
screen.blit(gamebutton[2], gamebuttonrect)
else:
print("error")
for event in pygame.event.get():
if event.type == QUIT: # 終了イベント
running = False
pygame.quit() # pygameのウィンドウを閉じる
sys.exit() # システム終了
if (event.type == pygame.MOUSEBUTTONUP) and (event.button == 1):
if gamebuttonrect.collidepoint(event.pos):
if gamescene == 0:
gamescene = 1
elif gamescene == 1:
gamescene = 2
elif gamescene == 2:
gamescene = 0
else:
gamescene = -1
pygame.display.update() # 描画処理を実行
if __name__ == "__main__":
main()
```
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/](https://github.com/gomta777/hitandblow/?ref=geekjp.com)
のgamesceneが今回のものです。
次回以降は、だんだんゲームっぽい雰囲気を出していきたいと思います。
よくあるカジュアルゲームみたいに仕上がるといいですね。
よかったら、ブログ村↓のクリックお願いします。
### 【簡単?】初心者がpython3とpygameでヒット&ブローゲーム作ってみる #01【習作?】
URL: https://www.geekjp.com/2019-11-16-184245-2/
Last updated: 2026-08-04T15:59:53.000Z
- [初心者がpython3とpygameでヒット&ブローゲーム作ってみる #01](#初心者がpython3とpygameでヒットブローゲーム作ってみる-01)
- [前回から](#前回から)
- [ヒット&ブローゲーム](#ヒットブローゲーム)
- [ヒット&ブローの仲間とゲームの実装](#ヒットブローの仲間とゲームの実装)
- [実装(設計)](#実装設計)
- [出題](#出題)
- [判定](#判定)
- [入力](#入力)
- [プレイヤーの入力](#プレイヤーの入力)
- [判定結果の表示](#判定結果の表示)
- [正解まで繰り返す](#正解まで繰り返す)
- [入力制限](#入力制限)
- [入力の重複チェック](#入力の重複チェック)
- [ちょっとしたゲーム要素を追加](#ちょっとしたゲーム要素を追加)
- [完成したソースコード一覧](#完成したソースコード一覧)
- [次回](#次回)
### 前回から
いわゆるヒット&ブローゲームを作ってみます。今回はプロトタイプとして、テキストベースでコンソール画面で実行できるバージョンを作ってみます。
そして次回以降で、グラフィックを追加してゆき、最終的にビデオゲーム風に仕上げます。(テトリス完成させろよ、という突っ込みお待ちしております)
### ヒット&ブローゲーム
ヒット&ブローゲームを御存知でしょうか?
結構有名なので、どこかでは見たことあると思います。
知らない方のためにちょっとだけ説明します。
簡単に言うと、数字当てゲームです。
出題者側から4桁(が多分ノーマルルール)のかぶらない数字が出題されます。
3124、9876、1526など。
解答者側は、この数字を当てます。
解答者の予想した数字の、
位置があっていた場合はHIT(ヒット)
数字のみあっていた場合はBLOW(ブロー)
となります。
例えば、「1526」が出題されたとしましょう。
解答者は、4桁の数字とその並びを予想して答えます。
「1234」と答えた場合
| 出題 | 1526 |
| -- | ---------- |
| 解答 | 1234 |
| 結果 | 1HIT 1BLOW |
次に「1256」と答えた場合
| 出題 | 1526 |
| -- | ---------- |
| 解答 | 1256 |
| 結果 | 2HIT 2BLOW |
これを、なるべく少ない回数で4HIT獲得しよう!というゲームです。
#### ヒット&ブローの仲間とゲームの実装
ヒットアンドブローゲームは、スターマインドという名前でボードゲームとして発売されてヒットしています。
[https://ja.wikipedia.org/wiki/%E3%83%9E%E3%82%B9%E3%82%BF%E3%83%BC%E3%83%9E%E3%82%A4%E3%83%B3%E3%83%89](https://ja.wikipedia.org/wiki/%E3%83%9E%E3%82%B9%E3%82%BF%E3%83%BC%E3%83%9E%E3%82%A4%E3%83%B3%E3%83%89?ref=geekjp.com)
スターマインドでは、数字の並びではなく、ボールの色を当てるゲームです。(子供のころ友達の家で遊んだことがあるのは内緒です)
このウィキペデアの「その他」の項にありますが、
「ルールが簡潔であるため、パソコンの黎明期にBASICで組まれたプログラムが数多く発表された。」
とあります。そのため、あちこちに様々な実装が散見され、工学系の学校の授業などでも、プログラミングの例題として課題で出されたりします。
なので、実装そのものに関しては、特に工夫もいらず、あまり書くこともないかなぁなんて思ったりしています。
(なんか、pythonならでは的なものがあったら書こうかな)
### 実装(設計)
ゲームのメイン部分の設計を考えてみます。
設計といってもやることはいくつかしかなく。
大まかに、
出題、入力、判定、出力
がメインかなと思います。
#### 出題
出題は、C言語などではちょっとした工夫をしないと4桁のかぶらない数の列を作れませんが、python様にかかると2行です。
```python
import random
def make_question():
nums = list(range(10))
return(random.sample(nums, 4))
```
num = list(range(10))
で
\[0, 1, 2, 3, 4, 5, 6, 7, 8, 9\]
のリストができるので、そこから4つの数字をランダムにチョイスします。(なんて命令がpythonにちょろっとあるのが笑えます)
random.sample(list, num)
は、指定されたリスト(list)から、重複なしで(num)個の数字を取り出す命令です。
これだけで、「4桁のランダムな並びの重複しない数字の列」が出来上がります。
#### 判定
次にプレイヤーから4桁の数字の列
yin = \[n1, n2, n3, n4\]
が入力されたときのヒットとブローの判定を考えてみます。
ヒットの判定は、ループでそのまま一致を調べます。
(pythonには、もっといい方法がある気がします)
```python
for i in range( len(yin) ):
if yin[i] == ans[i]:
h += 1 # hがヒットの数
```
次にブローの数を数えます。
あるリストlistにnという要素が含まれるかどうかは、pythonではその中に入っている型とかを考えずに
```python
n in list
```
が**True**か**False**かで判定できます。
したがって、ブローの数は、
**「今判定している数がヒットじゃなかったときに、リストに含まれているかどうか」**
を判定すればよいです。
```python
for i in range( len(yin) ):
if yin[i] == ans[i]:
h += 1 # hがヒットの数
else:
if yin[i] in ans:
b += 1 # bがブローの数
```
これだけでヒットとブローの判定ができます。
これを、関数として書いてみます。
yinがユーザの入力、yin = \[n1, n2, n3, n4\]
ansが出題された数字列、ans= \[a1, a2, a3, a4\]
を表しています。
```python
def judgement(yin, ans):
h=0
b=0
for i in range(len(yin)):
if yin[i] == ans[i]:
h += 1
else:
if yin[i] in ans:
b += 1
return([h, b])
```
### 入力
次に、プレイヤーの入力処理の部分を考えてみます。
入力をベースに考えた処理の流れは、
1. ゲーム開始
2. 出題
3. プレイヤーの解答入力
4. 判定の表示
5. (HIT==4がTrueか?)
- TRUEの場合 おめでとうと表示
- FALSEの場合 3へもどる
となります。
#### プレイヤーの入力
出題される数字列は、
**ans= \[a1, a2, a3, a4\]**
のlistの形で保存されています。
先ほど作った関数、
**def judgement(yin, ans):**
で、ヒットとブローの判定をするには、入力した数字列を
**yin = \[n1, n2, n3, n4\]**
の形で関数に渡さなければなりません。
プレイヤーが入力した4桁の数字は、通常inputで取得すると、4文字の文字列として、保存されてしまいます。これ整数一けたずつの数字にばらして要素数4のリストに変換します。
```python
print("Hit&Blowゲーム!")
print("4桁の重複しない数字を入力してください。")
print("->", end="")
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
print(your_input)
```
実行結果
```python
Hit&Blowゲーム!
4桁の重複しない数字を入力してください。
->1234
[1, 2, 3, 4]
```
簡単にできました。python様々です。
### 判定結果の表示
判定結果を、表示するためにプレイヤーの入力と生成された出題のリストを判定用関数に渡します。
**ans = make\_question()**
出題は、すでに生成され、ansに保存されているとします。
プレイヤーの入力your\_inputとansがあれば、ヒットとブローの判定は、
**hit,blow = judgement(your\_input, ans)**
で、取得できます。ここでもpythonは、値を複数返すのが簡単だったりしてうれしいですね。
ちゃんと動くか確認します。
```python
ans = make_question()
print(ans)
print("Hit&Blowゲーム!")
print("4桁の重複しない数字を入力してください。")
print("->", end="")
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
hit,blow = judgement(your_input, ans)
print("hit = "+str(hit)+", blow = " + str(blow))
```
確認用に、**ans**を生成した直後に、表示しています。
実際に実行してみます
結果:
```python
[7, 3, 5, 4]
Hit&Blowゲーム!
4桁の重複しない数字を入力してください。
->7345
hit = 2, blow = 2
```
#### 正解まで繰り返す
この処理を、ヒットが4になるまで繰り返します。
処理自体は簡単で、先ほどの入力の部分をまるっと、無限ループにして、**hit==4**の判定が**True**になったら、おめでとうメッセージを表示して**break**します。
```python
ans = make_question()
print(ans)
print("Hit&Blowゲーム!")
while True:
print("4桁の重複しない数字を入力してください。")
print("->", end="")
hit = 0
blow = 0
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
hit,blow = judgement(your_input, ans)
print("hit = "+str(hit)+", blow = " + str(blow))
if hit == 4:
print("おめでとう、正解です :" + str(ans))
break
```
実行してみます。
実行結果:
```python
[5, 6, 4, 9]
Hit&Blowゲーム!
4桁の重複しない数字を入力してください。
->4569
hit = 1, blow = 3
4桁の重複しない数字を入力してください。
->5649
hit = 4, blow = 0
おめでとう、正解です :[5, 6, 4, 9]
```
一応これで、ゲームらしい形はできます。
### 入力制限
現在は、プレイヤーの入力に特に制限を設けていないので、出題は重複のない4桁の数字になっていますが、プレイヤーは何でもかんでもこたえられてしまいます。
```python
[0, 5, 8, 3]
Hit&Blowゲーム!
4桁の重複しない数字を入力してください。
->0000
hit = 1, blow = 3
4桁の重複しない数字を入力してください。
->5555
hit = 1, blow = 3
4桁の重複しない数字を入力してください。
->8888
hit = 1, blow = 3
4桁の重複しない数字を入力してください。
->0055
hit = 1, blow = 3
4桁の重複しない数字を入力してください。
->
```
さすがに、入力の制限を付けずにプレイヤーの良心にエラー回避のをゆだねるのは、アルゴリズム的にはだめすぎです(笑)
#### 入力の重複チェック
プレイヤーから入力された数字に、重複があったら再度入力を促すことにします。重複のチェックは、リストの中に同じ数字があるかどうかで判断すればよいです。
python様には、集合(set)というデータ構造があります。集合は、重複のないある要素の集まりを表します。
pythonでは、**list**から**set**の変換が可能です。
つまり、重複の許されている**list**を重複のない**set**に変換できます。
```python
lst = [1, 2, 2, 2, 2, 3, 4,]
setfromlist = set(lst)
print(lst, setfromlist)
```
結果
```python
[1, 2, 2, 2, 2, 3, 4] {1, 2, 3, 4}
```
これを利用して、変換前(リスト)と変換後(集合)の要素数が異なっていれば、重複がある、と判定します。
```python
def has_not_duplicates(seq):
return len(seq) == len(set(seq))
```
関数**def has\_not\_duplicates(seq):**により、入力に重複があるかどうかが**True**、**False**で返ってきます。
プレイヤーの入力に可ぶりがない場合のみ(def has\_duplicates(seq)がTrue)判定の処理をして、それ以外はスルーして入力に戻ればいいです。
```python
while True:
print("4桁の重複しない数字を入力してください。")
print("->", end="")
hit = 0
blow = 0
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
if has_not_duplicates(your_input):
hit, blow = judgement(your_input, ans)
print("hit = "+str(hit)+", blow = " + str(blow))
if hit == 4:
print("おめでとう、正解です :" + str(ans))
break
```
### ちょっとしたゲーム要素を追加
最後に、スコア代わりに何手目で正解したかを表示する機能を追加してみます。
入力ミス(重複エラー)を1ターンと数えるかどうかでちょっと変わってきますが、今回は数えないほうでやってみます。
プレイヤーの手数を表す**変数turn**を追加します。
判定処理の部分で、**hit==4**(正解の時)以外の時には**手数turn**を増やします。
```python
turn = 1
ans = make_question()
print(ans)
print("Hit&Blowゲーム!")
while True:
print("第%02d手目" % turn)
print("4桁の重複しない数字を入力してください。")
print("->", end="")
hit = 0
blow = 0
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
if has_not_duplicates(your_input):
hit, blow = judgement(your_input, ans)
print("hit = "+str(hit)+", blow = " + str(blow))
if hit == 4:
print("おめでとう! %02d手目で正解です :" % turn)
break
else:
turn += 1
```
実行結果:
```python
Hit&Blowゲーム!
第01手目
4桁の重複しない数字を入力してください。
->1234
hit = 0, blow = 1
第02手目
4桁の重複しない数字を入力してください。
->1249
hit = 0, blow = 1
第03手目
4桁の重複しない数字を入力してください。
->9738
hit = 1, blow = 3
第04手目
4桁の重複しない数字を入力してください。
->3978
hit = 4, blow = 0
おめでとう! 04手目で正解です :
```
### 完成したソースコード一覧
今回のプログラムの全体像です。
```python
import sys
import random
def has_not_duplicates(seq):
return len(seq) == len(set(seq))
def judgement(yin, ans):
h=0
b=0
for i in range(len(yin)):
if yin[i] == ans[i]:
h += 1
else:
if yin[i] in ans:
b += 1
return([h, b])
def make_question():
nums = list(range(10))
return(random.sample(nums, 4))
def main():
turn = 1
ans = make_question()
print("Hit&Blowゲーム!")
while True:
print("第%02d手目" % turn)
print("4桁の重複しない数字を入力してください。")
print("->", end="")
hit = 0
blow = 0
tmp = input()
your_input = []
for i in tmp:
your_input.append(int(i))
if has_not_duplicates(your_input):
hit, blow = judgement(your_input, ans)
print("hit = "+str(hit)+", blow = " + str(blow))
if hit == 4:
print("おめでとう! %02d手目で正解です :" % turn)
break
else:
turn += 1
if __name__ == "__main__":
main()
```
### 次回
今回のソースコード一式はgithubにもあります。
[https://github.com/gomta777/hitandblow/tree/master/textversion](https://github.com/gomta777/hitandblow/tree/master/textversion?ref=geekjp.com)
次回以降は、今回作ったヒットアンドブローゲームにpygameでガワをはっていき、ビデオゲーム風に仕上げていきます(笑)
このままでも、面白いですけどね。
よかったら、ブログ村↓のクリックお願いします。
### 【サッカー】ビジャが引退しちゃうじゃないかと悲しみにくれていたら、自分の年齢を痛感した話【じじい】
URL: https://www.geekjp.com/2019-11-13-172711/
Last updated: 2019-11-13T08:27:11.000Z
- [ビジャが引退しちゃうじゃないかと悲しみにくれていたら、自分の年齢を痛感した話](#ビジャが引退しちゃうじゃないかと悲しみにくれていたら自分の年齢を痛感した話)
- [事の発端](#事の発端)
- [WCCFと僕とビジャ](#WCCFと僕とビジャ)
- [男のけじめ](#男のけじめ)
- [所感](#所感)
### 事の発端
とにもかくにも、この動画を見てください。
[ダビドビジャ選手に関する記者会見|Press Conference Regarding David Villa (2019.11.13)](https://youtube.com/watch?v=X5QYeIgjqUo&ref=geekjp.com)
イニエスタ、フェルナンドトーレス、ビジャとスペインから来た大物3人衆の一人です。
みんなスペイン代表歴があり、スペインリーグが一番輝いていた時期に現地で活躍していた選手たちではないでしょうか?
けど。。。トーレスが今年の6月に引退を表明、それに続き今日ビジャも。。。
トーレスは、1984年生まれの35歳、まだやれるだろうよ、と思ったのですが引退。
ビジャは、81年生まれの37歳。。。会見でも言っていたのですがサッカー選手としてのクオリティを保ったまま、この年までやってこれるというのは、自分の力努力や周りの協力、運も含めて様々な要素が重なって屋っと成し遂げられることなのでしょうね。
しかも、世界のトップでずっと活躍するとなると、その体と心の負担は想像しがたいです。
とりあえず、お疲れ様というのと、後の残りの試合僕らの心と記憶に残る活躍を期待します。
### WCCFと僕とビジャ
WCCFというゲームを御存知でしょうか?
現在はバージョンアップして、WCCF FOOTISTAになっています。
ゲーセンの隅にある、サテライト端末にサッカーカードを並べて、ボタンをビシビシたたいているあのゲームです。
なぜか、もともと1990年代前半からスペインリーグとアルゼンチン代表とオランダ代表が大好きだった私は、WCCFでも、それらのチームの所属選手を並べて、自己満チームで楽しんでいました。
選手カードを11枚+控え5枚を並べて試合形式のゲームをして、1ゲーム終わると1枚カードが排出され、排出されたカードは自分のチームに加えることができます。(1ゲーム300円。。。)
ただ、チームや連携のパラメータがあるので初めに登録したカードと新しいカードを交換するとその後のチームの育成に絡んでくるので注意が必要です。
試合は、自分のフィールドに並べたフォーメーションに従って選手がゲーム画面に現れ、連携やスキルのパラメータに従って場面場面でほぼ自動で動きます。
チャンスの時のシュートや、ゴールキーパーを前に出したりはボタンでできます。また、チームに作戦(サイド攻め、中央突破など)の指示を出すことができます。
ゲームに登場する選手は、前の年の活躍でパラメータ化されており、特に活躍度の高かった選手は通称キラカード(レア度の高いカード)として登場します。レアバージョンとノーマルバージョンがあることが多い。
ノーマルの白カードと、レアの黒カード、超レアのキラカードの3段階のレアリティ(+キラに含まれるがMVPという鬼畜レアリティ)があります。
ビジャは、2003~4、2004~5シーズンにレアル・サラゴサでプレイしその頭角を示し、その翌年2005~6シーズンには、強豪のバレンシアFCに移籍します。
当時のバレンシアには、パブロ・アイマール、ミスタ、アングロ兄弟、パトリック・クライフェルト、ビセンテ、バラハ、カルボーニ、アジャラ、ファビオアウレリオ、カニサレスとスターぞろいでした。その中で、
図 05-06 wccf ビジャ
初登場で黒カードです。しかも割と化け物パラメータですね。
(トータルポイントではズラタンと同じです)
ちなみに、初めのころの表記がビージャだったのを知っているとちょっと通です(笑)
そして、06-07シーズンからは安定してキラカードとして登場します。
画像なかったのでリンク先でご確認ください。
[ダビド・ビージャ | WCCF カードデータ詳細](http://www.sodensakae.com/detail.aspx?ver=8&card=WFW5&ref=geekjp.com)
WFWというカテゴリーは、ワールドクラスFWですので、初登場ですでにワールドクラスのFWとして活躍していたということですね。
| 17-18 | ATLE | All Time Legends | |
| ----- | ------- | -------------------------- | |
| 13-14 | SPS-EXT | Spanish Sper Stars | |
| 11-12 | EUS-EXT | Europian Super Stars | |
| 10-11 | EXTRA | Extra Card | |
| 10-11 | WSS2 | World Class Second Striker | |
| 09-10 | SPS5 | Spanish Sper Stars | |
| 08-09 | WFW5 | Wold Class FW | |
17-18シーズンにはついにレジェンドになっていますね。
そんなレジェンドが日本でプレイしていたというだけでも、なんかうれしいですよね。
それで、びっくりしたのは。。。私が持っているカードの一番古いのが(自分でプレイしたもの)が04-05シーズンだったということです。
その当時から、何も変わってないつもりだったんですけど、まさかビジャの引退で考えさせられるとは。。。
### 男のけじめ
嵐のニノが結婚を発表して、そんなことを言っていましたね「男としてのけじめ」、そして、最近、好きだったサッカー選手のほとんどが引退し、昔の様にずっとあほあほとサッカーを見る時間もなく、惰性でずっと過ごしてきたなぁ。って、感傷に浸ってしまいました。
サッカーでも芸能界でもその世界のトップを走ってきた人たちが、何かを成し遂げて、多くの人の記憶に残って、多くの記録を残している間に、自分は何していたんだろうなって、思いました。
### 所感
まぁ、柄にもなく感傷に浸ってしまいましたが、最後はビジャのスーパープレイ集を貼って終わりたいと思います(笑)
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問41~問45 【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-13-145512/
Last updated: 2019-11-13T05:55:12.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、今回も問題解いていきまーす。
### 令和元年度 基本情報技術者試験 午前問題 問41~問45
#### 令和元年度 基本情報技術者試験 午前問題 問41
検索サイトの検索結果の上位に悪意のあるサイトが表示されるように細工する攻撃の名称はどれか。
| ア | DNSキャッシュポイズニング |
| - | -------------- |
| イ | SEOポイズニング |
| ウ | クロスサイトスクリプティング |
| エ | ソーシャルエンジニアリング |
#### 解説
なんか、既視感がありますね。
問35でもDNSキャッシュポイズニングの問題が出ていましたね。DNSキャッシュポイズニングという単語自体は出てきませんでしたが、分かっている人にとってはアレ?って思うような(笑)
問35解説記事:
[R01基本情報技術者試験 秋期試験に挑戦 問32~問35 - 工学じじいの縁側日記](https://www.geekjp.com/2019-11-06-230843/#%E4%BB%A4%E5%92%8C%E5%85%83%E5%B9%B4%E5%BA%A6%E5%9F%BA%E6%9C%AC%E6%83%85%E5%A0%B1%E6%8A%80%E8%A1%93%E8%80%85%E8%A9%A6%E9%A8%93%E5%8D%88%E5%89%8D%E5%95%8F%E9%A1%8C%E5%95%8F%EF%BC%93%EF%BC%95)
とりあえず、解説によると「ア」は違いますね。
| ア | DNSキャッシュポイズニング |
| - | -------------- |
DNSキャッシュを書き換えて不正な接続先へ導く攻撃手法でしたね。
| イ | SEOポイズニング |
| - | --------- |
SEOはSearch Engine Optimization(検索エンジン最適化)の略語で、検索エンジンが検索語に対する検索結果の順位を決める仕組みを解析し、そのWebページを検索結果の上位に表示されるようにする手法です。
その仕組みを使い、攻撃者が不正なWebページを上位に表示させて、閲覧者を不正ページへと導く手法です。
googleで検索した後って、上からポチポチ何個かのページを見てよさそうなページを選んで閲覧するってのが結構ありますよね。
(それで選ばれるページを書きたい。。。(願望))
ちょっと前まで、ページの下部に大量の卑猥なワードや、違法に近いものの単語が、バックグラウンドカラーで見えないように書いてあるページ結構ありましたよね。現在は、あのような手法は効果がないとされていますが、過去にはそのような手法で上位に表示されることがありました。
そのような、実際のページの内容と関係ない単語を含むページを表示させ検索エンジンに「勘違い」させて上位に表示させる手法を**「クローキング」**といいます。
ほかにも、ある不正ページへのリンクを持ったページを大量に作成して、検索結果に反映させる手法などや、検索上位に入るリンクネットワークを業者が売っていたりと、様々な手法がありますが、このような手法は現在は**「検索エンジンスパム」**と呼ばれ、検索エンジンからペナルティの対象とされています。
ということで、正解は「イ」ですね。
| ウ | クロスサイトスクリプティング |
| - | -------------- |
**クロスサイトスクリプティング(XSS)**は、javascriptなどを使える掲示板やブログシステムのような作成者だけではなく閲覧者も動的なコンテンツを作成できるようなサービスの脆弱性を狙った攻撃手法です。
サイト自体を攻撃対象にするのではなく、攻撃者によって埋め込まれた不正なスクリプトを閲覧した閲覧者の情報を別サイトに送信するため、**クロスサイト**という単語が含まれています。
現在では定義が拡張され、サイト横断的ではないスクリプトでもXSSと呼ばれたりします。
大きな特徴としては、HTMLタグやjavascriptが用いられることで、攻撃に利用されたサイト自体も攻撃に気づきにくいこともあり、危険な攻撃手法とされています。
- XSSの主な被害
- セッションハイジャック(cookieの悪用により通信の乗っ取り)
- 偽サイトによるフィッシング
- 偽入力フォームによる不正な情報送信
| エ | ソーシャルエンジニアリング |
| - | ------------- |
のぞき見や、電話での秘密情報の要求など、コンピュータやネット以外の部分で不正な情報入手をする手法。
高度な技術や知識を必要としないので、逆に引っ掛かりやすい面もある。
コンピュータは人が作ったもので、使い方に気を付けなければいけないけれども、人間同士のやり取りはある程度油断できる、という思い込みが招く危険ですね。
#### 令和元年度 基本情報技術者試験 午前問題 問42
1台のファイアウォールによって、外部セグメント、DMZ、内部セグメントの三つのセグメントに分割されたネットワークがあり、このネットワークにおいて、Webサーバと、重要なデータを持つデータベースサーバからなるシステムを使って、利用者向けのWebサービスをインターネットに公開する。インターネットからの不正アクセスから重要なデータを保護するためのサーバの設置方法のうち、最も適切なものはどれか。ここで、Webサーバでは、データベースサーバのフロントエンド処理を行い、ファイアウォールでは、外部セグメントとDMZとの間、及びDMZと内部セグメントとの間の直接の通信は許可しないものとする。
| ア | WebサーバとデータベースサーバをDMZに設置する。 |
| - | ----------------------------------- |
| イ | Webサーバとデータベースサーバを内部セグメントに設置する。 |
| ウ | WebサーバをDMZに、データベースサーバを内部セグメントに設置する。 |
| エ | Webサーバを外部セグメントに、データベースサーバをDMZに設置する。 |
#### 解説
カタカナと略語を混ぜ込んだ国語の問題です。
ファイアウォールは、異なるネットワーク間に置かれるアクセス制御のための機器(ソフトウェア)のことですね。
DMZは、外部ネットワークからのアクセスを許可された、内部ネットワークと外部ネットワークの中間地点。
1台のファイアウォールによって、外部セグメント、DMZ、内部セグメントの三つのセグメントに分割されたネットワークがあり。。。
この時点では、セグメント間の関係はまだわからないですね。
(内部セグメント) (FW) (DMZ) (外部セグメント)
ふむ。
このネットワークにおいて、Webサーバと、重要なデータを持つデータベースサーバからなるシステムを使って、利用者向けのWebサービスをインターネットに公開する。。。
外部にはWebサーバが公開され(外部からのアクセス可能)
重要なデータを持つデータベースサーバがある(重要なことしかわからない)
ふむ。
Webサーバでは、データベースサーバのフロントエンド処理を行い。。。
(Webサーバ)<---(処理)---> (データベースサーバ)
ふむ。
ファイアウォールでは、外部セグメントとDMZとの間、及びDMZと内部セグメントとの間の直接の通信は許可しない。
直接は許可しないってことは、通信禁止ではなくFW経由って事ね。
(外部セグメント)---(FW)---> (DMZ)
(DMZ)---(FW)---> (内部セグメント)
図 ネットワーク構成
きっと基本的なネットワーク構成はこんな感じだと思います。
これのどこにWebサーバとデータベースサーバを設置するかという問題
全部書いてみます(笑)
| ア | WebサーバとデータベースサーバをDMZに設置する。 |
| - | -------------------------- |
図 アの構成
この構成は、WebサーバがDMZとFWによって内部セグメントと切り離されているのはいいですが、外部からアクセス可能なDMZにデータベースサーバ(もっとも守るべきサーバ)があるので、外部からWebサーバを踏み台にデータベースサーバにアクセスできてしまう可能性があります。×ですね。
| イ | Webサーバとデータベースサーバを内部セグメントに設置する。 |
| - | ------------------------------ |
図 イの構成
この構成では、外部からWebサーバにアクセスできないので、Webサーバを公開することができません。×ですね。
| ウ | WebサーバをDMZに、データベースサーバを内部セグメントに設置する。 |
| - | ----------------------------------- |
図 ウの構成
この構成では、DMZにウェブサーバがありますので、外部公開は問題なくできます。また、データベースサーバが内部セグメントにありますが、DMAと内部セグメント間の通信はFWをとおして、ある程度安全に行うことができるため問題が起こりにくいです。
また、外部からデータベースサーバにアクセスしようとしても、FWが防いでくれるのでその点も安全です。
きっと〇。
| エ | Webサーバを外部セグメントに、データベースサーバをDMZに設置する。 |
| - | ----------------------------------- |
図 エの構成
そもそも、外部からアクセス可能なDMZにデータベースサーバを置いています。おそらく×。
正解は「ウ」です。
#### 令和元年度 基本情報技術者試験 午前問題 問43
SIEM(Security Information and Event Management)の機能はどれか。
| ア | 隔離された仮想環境でファイルを実行して、C&Cサーバへの通信などのふるまいを監視する。 |
| - | -------------------------------------------------- |
| イ | 様々な危機から集められたログを総合的に分析し、管理者による分析と対応を支援する。 |
| ウ | ネットワーク上の様々な通信機器を集中的に制御し、ネットワーク構成やセキュリティ設定などを変更する。 |
| エ | パケットのヘッダ情報の検査だけではなく、通信先のアプリケーションプログラムを識別して通信を制御する。 |
#### 解説
SIEM(Security Information and Event Management):しーむ、って読むらしいです。えすあいいーえむじゃないんだ(笑)
意味合いとしては、言葉の通りで、セキュリティの情報とイベントをマネジメントする、って感じです。
環境内の様々な機器やコンピュータの、ログ情報を一元的に管理し、単独のログではわからないような、侵入や、情報漏洩などのセキュリティの状況を割り出す技術です。
人の手では賄いきれない大量のログをシステムに任せて解析するってことですね。
答えは「イ」です。
関連する用語が、わんさかあるので混乱しないようにしてください。
- EDR
- Endpoint Detection and Response
- エンドポイントにおける脅威の動きを包括的に可視化し、ハッキング活動の検知・観察や記録、攻撃遮断などの応急措置となる機能を提供する
- EPP
- Endpoint Protection Platform
- 悪意をもってPCに侵入しようとするマルウェアを水際で検知し、PCを保護することを目的としている。従来のアンチウィルスソフトなどが該当する。
- IPS
- Intrusion Prevention System
- 外部からの不正な侵入を検知し、供えられた防御措置を行うもの
- IDS
- Intrusion Detection System
- 外部からの不正な侵入を検知し、管理者の通報などを行うもの
- WAF
- Web Application Firewall
- ウェブアプリの脆弱性を狙った攻撃を防ぐシステム
- 「クロスサイトスクリプティング」や「SQLインジェクション攻撃」、「強制ブラウジング」などの防御を行う
- サンドボックス
- 不正なソフトウェアの動作を確認するための隔離された箱庭環境
- SDN
- Software Defined Network
- ネットワーク上の様々な通信機器を集中的に制御し、ネットワーク構成やセキュリティ設定などを変更する技術の総称のこと
大混乱(笑)
#### 令和元年度 基本情報技術者試験 午前問題 問44
電子メールをドメインAの送信者がドメインBのあて先に送信するとき、送信者をドメインAのメールサーバで認証するためのものはどれか。
| ア | APOP | イ | POP3S | ウ | S/MIME | エ | SMTP-AUTH | |
| - | ---- | - | ----- | - | ------ | - | --------- | |
#### 解説
| ア | APOP |
| - | ---- |
Authenticated Post Office Protocol
(またはAutomatic Processing Options Protocol)
の略で、平文でユーザー名とパスワードを送信するPOP3を改良したもの
| イ | POP3S |
| - | ----- |
POP3 over SSL/TLSの略、単純にPOPSとも
Post Office Protocol version 3)に、伝送路を暗号化するSSL/TLSを組み合わせたプロトコル
| ウ | S/MIME |
| - | ------ |
Secure / Multipurpose Internet Mail Extensionsの略
電子メールの内容を暗号化したりデジタル署名を付加したりする手法。
| エ | SMTP-AUTH | |
| - | --------- | |
SMTPの拡張仕様の一つで、メールの発送時に、メールサーバが送信依頼をしてきた相手が正規の利用者かどうかを確認する方法を規定したもの。
そもそもユーザー認証の機構がなかったSMTPにユーザー認証機能を拡張したもの。
認証方法は、SASL(Simple Authentication and Security Layer)を採用していて、暗号化有り無しなどでいくつかのモードがある。
答えは「エ」ですね。
#### 令和元年度 基本情報技術者試験 午前問題 問45
図は、構造化分析法で用いられるDFDの例である。図中の”〇”があらわしているものはどれか。
図 DFD
| ア | アクティビティ | イ | データストア |
| - | ------- | - | ------ |
| ウ | データフロー | エ | プロセス |
#### 解説
DFD(Data Flow Diagram)は、システムで扱うデータの流れを明確化するとともに、データ処理を可視化する手法です。
構造化分析(Structured Analysis)は、トム・デマルコによって考案され、1970 年代後半から普及した要求を階層的
に設計していく分析手法です。構造化分析では、データフロー図(DFD)、データディクショナリ、ミニ仕様書の3点セットを用います。
- データフロー図
- システム全体の情報の流れを図で表現
- 個々の情報の処理手順を逐次的なプロセスとして記述
- データディクショナリ
- DFDで記述したデータフローやプロセスに関し
て、より詳細なデータ項目を定義したもの
- デマルコの記法
- ミニ仕様書
- 最下位プロセス1つ1つの逐次的な処理手順
を記述
- フローチャート、疑似言語など
ここで問題になっているDFDでは、以下のような要素が使われます。
- 外部実体
- 外部実体とは、モデル化されるシステムの外部に存在するデータの発生源(source)やデータの出力先(sink)などの要素
- 人間や外部システムを指す場合が多い。
- データストア
- データストアはデータの永続的な保管場所を表す
- ファイルやデータベースなど
- プロセス
- プロセスは実際の処理
- 外部実体、データストアまたは他のプロセスからデータを入力し、外部実体、データストアまたは他のプロセスへデータを出力する
- データフロー
- データフローはデータの流れを矢印で表したもの
□:外部実態
〇:プロセス
〓:データストア
→:データフロー
を表す。ので答えは「エ」です。
### 次回予告
うーん、テクノロジ系が終わってしまう(笑)
次どうしようかまだ悩み中です。
コメントで、どうするのがいいかリクエストいただければ頑張れるかもです!よろしくお願いします。
良かったら、押してください!↓↓↓
にほんブログ村
### 第3回 チキチキ プログラミング初心者のための型に関する考察 ~pythonで基数変換してみるよ~
URL: https://www.geekjp.com/2019-11-12-235837/
Last updated: 2026-08-01T14:35:45.000Z
- 第3回 チキチキ プログラミング初心者のための型に関する考察 ~pythonで基数変換してみるよ~
- はじめに
- よろしい、ならば自作関数だ
- 10進数と2進数を変換する関数を作る
- pythonで表現してみる
- 2,8,16進数のはなし
- 10進数を2,8,16進数に変換する関数
- そして負の数
- (bin)だと2の補数に変換できないよねってこと
- pythonで表現してみる
- 所感
### はじめに
1回目で、型ってなんだ、2回目で整数型の中身と正負の整数のメモリ表現を見てみました。
[第1回 チキチキ プログラミング初心者のための型に関する考察](https://www.geekjp.com/2019-10-28-135618-2/)
[第2回 チキチキ プログラミング初心者のための型に関する考察](https://www.geekjp.com/2019-11-10-182219/)
2回目でも紹介した通り、pythonでは、組み込み関数binを使うことによって、整数を2進数に変換することができます。
また、表示のみだけであればprint関数の書式設定で何とかなります。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/a9cf5f41f16806c69c15b764323f25f2?ref=geekjp.com)
ですが、
```
num = int(input())
print(bin(num))
print(bin(-num))
```
これで、入力を150とすると
```
150
0b10010110
-0b10010110
```
**0b**は2進数表記であることを表します。なので、**150**を表すビット列は**10010110**となります。pythonの型にはCやjavaの型(=メモリサイズ+表現形式の決まり)と違って決まったサイズがありませんので、150をそのまま2進数に変換した10010110が表示されています。
これが例えば、CやJavaのshort型だったとすると
| 型 | メモリサイズ |
| ----- | ------------ |
| short | 16ビット(2byte) |
| int | 32ビット(4byte) |
なので、
150(10進数) => 0000000011010110(2進数)
となります。
(pythonは、これが普通の世代から見るとなんか気持ち悪いw)
そして負の数のビット表現は2の補数を取って、
| 10進数 | 2進数 |
| ----- | ---------------- |
| 150 | 0000000011010110 |
| \-150 | 1111111100101010 |
となるはずですが、まさかの、-0b10010110となります。
### よろしい、ならば自作関数だ
#### 10進数と2進数を変換する関数を作る
引数に10進数と整数n(2<=n<10)を与えると、それをn進数に変換して返す関数
def base\_conv(number, n):
を考えます。
与えられたnumをn進数へ変換するには、前回説明した通り
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/10/28/135618](https://www.geekjp.com/2019-10-28-135618/)
- num>0の間以下を繰り返す。
1. 与えられた整数numをnで割って、商q、余りrを記録
2. num=q
記録したrを逆順に並べるとn進数で表現されたnumとなります。
#### pythonで表現してみる
上の処理をpythonで書きます。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/944180fd85cc65ac5c810340ad8cd449?ref=geekjp.com)
ちゃんと動いてそうですね!
実行結果もあってそうな気がします。
### 2,8,16進数のはなし
コンピュータの世界では、2の乗数と、それに関連して8の倍数を使うことが多いです。
例えば、
8bit = 1byte
1024(=2^10) bit = 1Mbit
0と1の2進数の世界でデータや命令ができているので自然といえば自然なことですね。
また、2進数でデータを表記していると、どんどん長くなってしまいます。
0011101001010110(2進数)
035126(8進数)
3A56(16進数)
2進数だと16bit必要だったものが8進数だと7桁、16進数だと4桁で済んでしまいました。
また、2進数、8進数、16進数は2の乗数が基数となっているため比較的簡単に相互変換可能です。なので、結構多くのプログラミング言語に2進数、8進数、16進数表記が使える機能が備わっています。
ちなみにn進数は0~(nー1)の数字を使って表すというルールがありました。(8進数なら0~7の数字で表される)
16進数を考えてみるとちょっと面白いことになります。
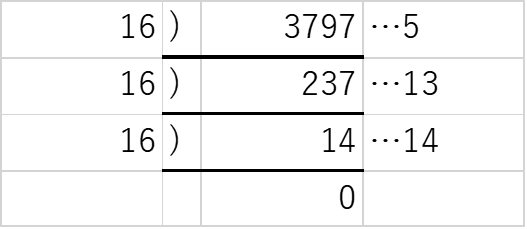
図:16進変換
3797(10進数)を16で割っていって余りを下から並べると、
**14 13 5**
となってしまします。1桁あたりに2つの数字が入ってしまいます。
そりゃそうですよね。16進数なんで0~15の数字を一けたに使うんだもん。でも、このままだと、繋げて書いたときに、14135と区別がつきません。困りました。
っということで、16進数の10~15の数字が出てきてしまったときは、桁で使える数字(0~9)は売り切れてもうないのでアルファベットを使います。
| 10 | A |
| -- | - |
| 11 | B |
| 12 | C |
| 13 | D |
| 14 | E |
| 15 | F |
3797(10進数)=> 14 13 5(16進数)=> **ED5(16進数)**
### 10進数を2,8,16進数に変換する関数
10進数の数字と、基数(2,8,16)を入力すると指定された基数に変換して返す関数を作ります。
2,8,16以外の基数が指定されたときは、Noneを返します。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/fbbea79819417b53248b73f2e50f1119?ref=geekjp.com)
**print(base\_conv(3797, 16))**
を試すと、ちゃんと
**ED5(16)**
が表示されます。
### そして負の数
#### (bin)だと2の補数に変換できないよねってこと
はじめに書いたとおり、組み込み関数bin()で整数をビット列に変換できます。しかしながら、負の数には対応しておらず、2の補数が表示されるわけではありません。これは、pythonが動的に型を扱う言語であることの特徴であって、別に欠点であるわけでも、バグでもありません。
ただし、静的に型を扱う言語は多数あり、型についての知識も大事かなと思います。という理念のもとに、型についてグダグダと語ってきました(笑)
話を戻して、2進数の負の数を2の補数で表示してみたい!という願望をかなえる関数を書いてみます。
型=メモリサイズ+表現方法
でしたね。JavaやC言語では、整数型はメモリサイズによってchar(byte)、short、int、longなどと名前が変わっていきます。
ちょっと中身で比べてみます。
pythonで、
**print(bin(3))**
を実行すると
**0b11**
が表示されます。
しかし、例えばC言語では
char c=3;
とすると中身は
00000011
となります。
short c=3;
だと、
0000000000000011
です。
charは8ビット、shortは16ビットの固定幅でデータが用意されるというわけです。
これを、C言語の場合で負の数(-3)にしてみます。
char c=-3の場合:
00000011 (元の2進数)
11111100 (1の補数(ビット反転))
11111101 (2の補数(1の補数+1)) ← これがー3の8ビット表現
short c=-3野場合:
0000000000000011 (元の2進数)
1111111111111100 (1の補数(ビット反転))
1111111111111101 (2の補数(1の補数+1)) ← これがー3の8ビット表現
となります。pythonの場合は、ビット幅が決まっていないので内部表現はこうなっているとは限らないです。
#### pythonで表現してみる
今度は、この処理を、関数にしてみます。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/df7a4610df701f03939c32685210cd72?ref=geekjp.com)
def plus\_one(binarr):
は、2進数で一番右のビットに1を足した結果を得る関数
def bit\_reverse(binarr):
は、すべてのビットをビット反転する関数です。
結果も、ちゃんと動いているっぽいですね。
### 所感
pythonで基数変換する処理を書いてみました。
たまには、こういうプログラムも楽しいかもしれない(笑)
### 【python】第2回 チキチキ プログラミング初心者のための型に関する考察 ~負の整数~【学習】
URL: https://www.geekjp.com/2019-11-10-182219/
Last updated: 2019-11-10T09:22:19.000Z
- [第2回 チキチキ プログラミング初心者のための型に関する考察 ~負の整数~](#第2回チキチキプログラミング初心者のための型に関する考察負の整数)
- [はじめに](#はじめに)
- [符号付と符号なし整数](#符号付と符号なし整数)
- [符号ありと、符号なしの整数値](#符号ありと符号なしの整数値)
- [3つの負数表現](#3つの負数表現)
- [負の数の表現:符号付絶対値表現](#負の数の表現符号付絶対値表現)
- [負の数の表現:1の補数表現](#負の数の表現1の補数表現)
- [負の数の表現:2の補数表現](#負の数の表現2の補数表現)
- [ちょっと問題解いてみる](#ちょっと問題解いてみる)
- [pythonと整数型のビット列](#pythonと整数型のビット列)
- [所感](#所感)
### はじめに
第1回では、正の整数と2進数の関係、、2進数とビット数の関係、オーバーフローなどについて考えてみました。
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/10/28/135618](https://www.geekjp.com/2019-10-28-135618/)
- 型
- 型とはメモリ内での数値表現のこと
- 大きく分けて、整数、実数、文字型などがある
- 整数型は2進数で表現され、その表現できる範囲はbit数で決まる
- 整数型の型の違いは主に、bit数の違い
- 桁あふれが起こると、あふれた桁は捨てられる
- 型変換
- n進数について
- 10進数とn進数の変換方法
- n進数から10進数に変換する方法
などを、実例を交えて考えてみました。
今回は、整数型の負の数について考えてみたいと思います。
おそらくpythonプログラマにはあまり必要ない知識かと思いますが、その表現法や仕組みは**情報処理技術者試験に頻出**ですので、すこし掘り下げてみましょう!
```python
応用情報技術者平成25年秋期 午前 問3
負の整数を表現する代表的な方法として,次の3種類がある。
a. 1の補数による表現
b. 2の補数による表現
c. 絶対値に符号を付けた表現(左端ビットが0の場合は正,1の場合は負)
4ビットのパターン1101を a~c の方法で表現したものと解釈したとき,
値が小さい順になるように三つの方法を並べたものはどれか。
ア
a, c, b
イ
b, a, c
ウ
b, c, a
エ
c, b, a
```
こんな感じの問題が基本除法技術者試験や、応用情報技術者試験にぽろぽろと出題されます。
### 符号付と符号なし整数
pythonでは、符号あり、符号なしの指定を整数につけることはできません。また、bit数による範囲の制限がないため、pythonコーダーの皆さんは、特に整数の型について意識することなくコーデイング出来るということは、前にも書きました。
しかしながら、世の中のこれまでの主流プログラミング言語(C/C++,C#,Javaなど)でのコーデイングの際には、コーダーはそのデータの型の値域を考えて、また、メモリ使用量をなるべく少なくするために適切な型を考えながら書いていくのが通常でした。
(最悪、浮動小数点数よりも整数の方が計算が何倍も速いということで、小数点数を整数で計算するギミックなんかを作ったり。。。)
ということで、整数型では、同じビット幅で同じビット列でも2種類の読み方ができてしまいます。
| 10001000 | 136 | 符号なし |
| -------- | ----- | ---- |
| 10001000 | \-120 | 符号あり |
pythonでは、ほとんど考えに及びませんが、Cプログラマなどは、この差を考えながらコーデイングしているってわけです。
実際には、例えばC言語の場合は変数を宣言するときに、以下のように宣言することになっています。
| signed/ unsigned | 型 | 変数名 | ; | 実際の宣言文(全部繋げたやつ) |
| ---------------- | ---- | ---- | - | ------------------- |
| signed | int | bar | ; | signed int bar; |
| unsigned | int | bar | ; | unsigned int bar; |
| signed | char | cbar | ; | signed char cbar; |
| unsigned | char | cbar | ; | unsigned char cbar; |
signedが符号あり、unsignedが符号なしを表します。
(実数型では、その表現法の内容からsigned,unsignedの区別が持てません)
signed, unsignedは整数型の修飾子ということになります。
また、デフォルトでは変数はsignedとして宣言されることになっているので、signedとあえて書くことはあまりありません。
#### 符号ありと、符号なしの整数値
前回の、説明で以下のような表がありました。
| 型名 | 種類 | サイズ | 範囲 | 備考 |
| ----- | -- | ----- | ------------------------- | --------- |
| int | 整数 | 4byte | \-2147483648 〜 2147483647 | 負数は2の補数表現 |
| short | 整数 | 2byte | \-32768 〜 32767 | 負数は2の補数表現 |
| char | 整数 | 1byte | \-128\~127 | 負数は2の補数表現 |
これは、すべてsignedの時の表となっています。それでは、unsignedの時はどうなるのでしょうか?
| 型名 | 種類 | サイズ | 範囲(signed) | 範囲(unsigned) | 備考 |
| ----- | -- | ----- | ------------------------- | ----------------- | --------- |
| int | 整数 | 4byte | \-2147483648 〜 2147483647 | 0 ~ 4,294,967,295 | 負数は2の補数表現 |
| short | 整数 | 2byte | \-32768 〜 32767 | 0 ~ 65,535 | 負数は2の補数表現 |
| char | 整数 | 1byte | \-128\~127 | 0 ~ 255 | 負数は2の補数表現 |
実際の詳しいビット数とデータ範囲の関係については、MSDocsにまとまっています。
[データ型の範囲 | Microsoft Docs](https://docs.microsoft.com/ja-jp/cpp/cpp/data-type-ranges?view=vs-2019&ref=geekjp.com)
次は、実際にメモリ内で負の数がどう表現されているか見てみます。
### 3つの負数表現
負の数の表現には大きく分けて、3種類あります。
初めに貼った、応用情報技術者試験の問題ではその3つがフル出題されています。
詳しくは以下の3つです。
- **負数の表現**
- 符号付絶対値表現
- 1の補数表現
- 2の補数表現
それぞれの表現法を見ていきましょう。
#### 負の数の表現:符号付絶対値表現
数値を符号と絶対値に分けて表現する方法です。
算数などで習う計算法と同じ表現法なので、非常にわかりやすいです。
符号:(+、-)
絶対値:(0~9の数字の羅列)
1. 100, -100など
これはわかりやすいですね、ただ、(型にうるさい)コンピュータの世界では、0と1しか使えずビット数が決まっています。
例えば8ビット整数(char)で、10進数の-15を表すときに、
| 10進数 | 2進数 | 16進数 |
| ---- | ---------- | ---- |
| \-15 | \-00001111 | \-0F |
と出来ればいいですが、+、-という符号はプログラミング言語(高級言語)では使えても、CPUの命令のレベルでは使えません。
そこで、8ビット中の上位の1ビットを符号として犠牲にして、残りの7ビットで絶対値を表します。
| 符号 | 数値 |
| -- | -- |
| + | 0 |
| \- | 1 |
絶対値は7ビットですので、0~127(2^7 - 1)まで表せます。
1. 105と-105を作ってみましょう
まず、絶対値として、7ビットで10進数の105を作ります。
105(10進数)→ 1101001(2進数)
| 10進数 | 符号 | 絶対値 | 符号付絶対値表現 |
| ----- | -- | ------- | -------- |
| +105 | 0 | 1101001 | 01101001 |
| \-105 | 1 | 1101001 | 11101001 |
と、表現するのが符号付絶対値表現です。わかりやすいですよね。
しかし、10進数の0を表現するときに、
| 10進数 | 符号 | 絶対値 | 符号付絶対値表現 | |
| ---- | -- | ------- | -------- | |
| 0 | \+ | 0000000 | 00000000 | |
| 0 | \- | 0000000 | 10000000 | |
+0と、-0が出てきます。
さらに、
| | +105 | | 01101001 |
| - | ----- | -- | --------- |
| + | \-105 | \+ | 11101001 |
| | 0 | | 101010010 |
10進数は足すと0になるのに、2進数では足しても0になりません。
人間にはわかりやすい表現法ですが、コンピュータが計算を行うためにはいろいろ工夫が必要そうです。
#### 負の数の表現:1の補数表現
次は、補数を使う方法です。
一般的にn進数には、2つの補数があります。nの補数と(n-1)の補数です。
10進数なら10の補数と9の補数があり、2進数なら2の補数と1の補数がある。
8進数なら8の補数と、7の補数がある。
ってな感じです。
| nの補数 | (n-1)の補数 |
| ----------------------- | ----------------------- |
| 足したときにぎりぎりすべての桁が桁上げされる数 | 足したときにぎりぎりすべての桁が桁上げしない数 |
10進数の場合は、
| 元の数 | 10の補数 | 9の補数 |
| --- | ----- | ---- |
| 456 | 544 | 543 |
10の補数:456+544 = 1000
9の補数:456+543 = 999
8進数の場合は
| 元の数 | 8の補数 | 7の補数 |
| --- | ---- | ---- |
| 456 | 322 | 321 |
8の補数:456+322 = 1000
7の補数:456+321 = 777
2進数の場合は
| 元の数 | 2の補数 | 1の補数 |
| ---- | ---- | ---- |
| 1001 | 0111 | 0110 |
2の補数:1001+0111 = 10000
1の補数:1001+0110 = 1111
となります。どの補数も **nの補数=(n-1)の補数+1**とな
っています。
2進数の場合数字のバリエーションが0と1しかないのでとても簡単で、
1の補数→元の数のすべてのビットをビット反転
101001 → 010110
2の補数→1の補数+1
101001 -(1の補数)-> 010110 -(1の補数+1)-> 010111
となります。
ここでやっと、負の数の話に戻りますが、このうち元の数を1の補数に変換したものを負の数として使うものが1の補数表現です。(=ビット反転したらその数の負の数バージョン)
10進数の59で考えてみます
59の2進表現は 00110011
このとき-59は 00110011 -(ビット反転)-> **11001100**
となります。また、最左ビットが1のものを負の数、0のものを正の数として扱います。
つまり、
00001101 => 最左ビットが0なので正の数なので、そのまま10進数に変換して+13を表している。
11110010 => 最左ビットが1なので負の数、 ビット反転してからマイナス符号をつけて10進数に直すと
11110010 -(ビット反転)-> **00001101** \-> -13
ということになります。
ただし、この方法でも、
**00000000 -> +0**
**11111111 -> - 0**
のプラスマイナスの2つの0が存在してしまします。
つぎに、+13 と -13 を足してみます。
00001101
+11110010
11111111
- 13は+13をビット反転したものなので、当たり前のように全ビット1になりますが、これは1の補数表現では -0 なので、計算上は正しく計算できているということになります。
1の補数の世界で、正確に足し算を行うためには、普通に足し算を行って、
最上位で桁上りがない場合 = そのまま答え
最上位で桁上りがある場合 = 桁上りを最右ビットに足す
例1)桁上りなしの場合
10進数: 13 + 8 = 21
2進数: 00001101 + 00001000 = **00010101** \=> 10進数で 13 + 8 = 21
例2)桁上りありの場合
10進数: 13 + (-8) = 5
2進数: 00001101 + (11110111) = 100000100
桁上り1 (1)(00000100)
最右に桁上りを足す **00000101** \=> 10進数で 13-8 = 5
このように、演算的に比較的簡単に正しい結果を導けるので、一昔前のコンピュータでは1の補数を使って負の数を表すものもありました。近年では、次に説明する2の補数表現のものが多いと思います。
#### 負の数の表現:2の補数表現
2の補数の作り方については、上で説明したとおりです。1の補数に1を足してできた2の補数を元の数の負の数バージョンとして使う方法です。
先ほどと同様に、10進数の59で考えてみます。
59の2進表現は 00110011
このとき-59は 00110011 -(ビット反転)-> 11001100 -(+1)-> **11001101**
となります。また、最左ビットが1のものを負の数、0のものを正の数として扱います。
つまり、10進数との対応を考えると
00001101 => 最左ビットが0なので正の数なので、そのまま10進数に変換して+13を表している。
11110010 => 最左ビットが1なので負の数、 ビット反転してからマイナス符号をつけて10進数に直すと
11110010 -(-1)->11110001 -(ビット反転)-> 00001101 -> -13
この方法では、0は 00000000 のみです。
また、2つの数の足し算の結果は以下のように求められます。
最上位で桁上りがない場合 = そのまま答え
最上位で桁上りがある場合 = 桁あふれを捨てると答え
例1)桁上りなしの場合
10進数: 13 + 8 = 21
2進数: 00001101 + 00001001 = **00010101** \=> 10進数で 13 + 8 = 21
例2)桁上りありの場合
10進数: 13 + (-8) = 5
2進数: 00001101 + (11111000) = 100000101
桁上り1 (1)(00000101)
最右に桁上りを捨てる **00000101** \=> 10進数で 13-8 = 5
第1回でも説明しましたが、桁上りではみ出てしまったビットは自動的に捨てられます。
つまり、2の補数表現では負の数が混じっても、通常の足し算を行うだけで計算の結果が得られる。
ということです。
ここまでくれば、初めに提示した、応用情報技術者試験の問題解けますよね?
### ちょっと問題解いてみる
```python
応用情報技術者平成25年秋期 午前 問3
負の整数を表現する代表的な方法として,次の3種類がある。
a. 1の補数による表現
b. 2の補数による表現
c. 絶対値に符号を付けた表現(左端ビットが0の場合は正,1の場合は負)
4ビットのパターン1101を a~c の方法で表現したものと解釈したとき,
値が小さい順になるように三つの方法を並べたものはどれか。
ア
a, c, b
イ
b, a, c
ウ
b, c, a
エ
c, b, a
```
ここで出てくる3つの負の数の表現法は、前の節の通りの3つですね。
そのうえで、4ビットのビット列1101を3つのパターンで解釈したときに、その示す値がちいさい順に並べたのはどれか、って問題です。
値を実際に計算してみます。
a. 1の補数による表現:1101 ->最左ビット1なので負の数 -(bit反転)-> 0010 -> -2
b. 2の補数による表現:1101 ->最左ビット1なので負の数 -(-1)-> 1100 -> (bit反転) -> 0011 -> -3
c. 符号付絶対値表現だった場合:1101 ->最左ビット1なので負の数 -> (符号)(絶対値) =(1) (101) -> -5
| a | \-2 |
| - | --- |
| b | \-3 |
| c | \-5 |
なので、c, b, aとなり、答えは「エ」ですね。
#### pythonと整数型のビット列
pythonでは、整数値のビット列を得るのに
bin(x)
とするとxのビット列が得られますが、
図 負の数のビット列
こうなるので、2の補数を得るためには工夫が必要なようでした。
### 所感
情報処理技術者試験で頻出の、2進数で負の数を表現する3つの方法を解説しました。
実は、pythonでビット列ベースの基数ソートを実装しようと思ったんですが、ちょっとひっかかるところがあったので、この話をしてみました。
次は、ソートの話しできればいいね!
へば、またねー!
↓よかったら押してほしいです!
にほんブログ村
### 初心者がpython3でソートアルゴリズムを実装してみる【バケットソート&基数ソート】
URL: https://www.geekjp.com/2019-11-10-033214/
Last updated: 2026-08-01T13:17:10.000Z
---
title: "初心者がpython3でソートアルゴリズムを実装してみる【バケットソート&基数ソート】"
slug: "2019-11-10-033214"
published\_at: "2019-11-09T18:32:14.000Z"
feature\_image: ""
tags:
- "技術"
- "アルゴリズム"
- "Python"
- "プログラミング"
hatena\_source: "[https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/10/033214](https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/10/033214?ref=geekjp.com)"
gist\_count: 2
---
# 初心者がpython3でソートアルゴリズムを実装してみる【バケットソート&基数ソート】
### 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【バケットソート&基数ソート】
- 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【バケットソート&基数ソート】
- バケットソート
- アルゴリズム
- 実装・結果
- 基数ソート(Radix sort)
- アルゴリズム
- 実装・結果
- 所感
### バケットソート
バケットソートは、ソートのアルゴリズムの一つ。バケツソート、ビンソート(backetとbinでそのままですね)などともいわれる。
データ数nに対して、バケツ数nを用意すると、O(n)でソートが完了するはずの最強ソートに一瞬見えてしまうソートアルゴリズムです。
ただし、データの値の範囲のバケツを必ず用意しなければならないので、実用的ではない場面の多いアルゴリズムです。
似た仕組みのものに、度数分布を記録していきソートを行う数え上げソートや、桁ごとにバケットソートを行う基数ソートがあります。
### アルゴリズム
データに重複がない場合、アルゴリズムはとても単純です。
データ:\[ 3, 1, 5, 4, 2 \]
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | |
①左から順番にデータを取り出します
データ:\[1, 5, 4, 2 \] → 3
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | |
②バケツの3番に3を格納
データ:\[1, 5, 4, 2 \]
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | | | 3 | | |
③1をとりだしバケツに
データ:\[5, 4, 2 \]
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | 1 | | 3 | | |
④以下繰り返しで、
データ:\[2 \]
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | 1 | | 3 | 4 | 5 |
④2を取り出しバケツに入れ、ソート完了
データ:\[ \]
| バケツ | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] |
| --- | ------ | ------ | ------ | ------ | ------ |
| データ | 1 | 2 | 3 | 4 | 5 |
データの入れ替えや、比較なしにソートが完了してしまう、謎アルゴリズムです。
### 実装・結果
実装は、特に何の工夫もなく初心者丸出しでやってみました。
もっと効率の良い書き方はあると思います。
Embedded JavaScript
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/f39b86cd004e411a36d0fe69e39be860?ref=geekjp.com)
`[3, 9, 5, 1, 2, 4, 8, 6, 7, 10] [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]`
並べ替えられてますね(笑)
### 基数ソート(Radix sort)
バケットソートを、桁ごとに行う方法です。バケットソートでは、値の最大値から、最小値の範囲でバケツを用意しなければなりませんでした。
基数ソートでは、基数の桁ベースでソートを行うので、10進数ならバケツは10こ、2進数なら、2ビット区切りなら4つ、3ビット区切りなら8つのバケツでソート可能です。
### アルゴリズム
下の桁から上の桁に向けて、桁ごとにバケットソートを行います。
1の位でソート
データ:\[56, 89, 12, 45, 78, 105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | | | | | | |
①まず、1の位でバケットソートを行います。
データ:\[89, 12, 45, 78, 105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | | | 56 | | | |
データ:\[12, 45, 78, 105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | | | 56 | | | 89 |
データ:\[45, 78, 105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | 12 | | | | 56 | | | 89 |
データ:\[78, 105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | 12 | | | 45 | 56 | | | 89 |
データ:\[105, 23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | 12 | | | 45 | 56 | | 78 | 89 |
データ:\[23, 26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------- | ------ | ------ | ------ | ------ |
| データ | | | 12 | | | 45, 105 | 56 | | 78 | 89 |
データ:\[26, 33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------- | ------ | ------ | ------ | ------ |
| データ | | | 12 | 23 | | 45, 105 | 56 | | 78 | 89 |
データ:\[33, 63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------- | ------ | ------ | ------ | ------ |
| データ | | | 12 | 23 | | 45, 105 | 56,26 | | 78 | 89 |
データ:\[63\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------- | ------ | ------ | ------ | ------ |
| データ | | | 12 | 23, 33 | | 45, 105 | 56,26 | | 78 | 89 |
データ:\[\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ---------- | ------ | ------- | ------ | ------ | ------ | ------ |
| データ | | | 12 | 23, 33, 63 | | 45, 105 | 56,26 | | 78 | 89 |
②データを、順番に取り出します。
データ:\[12, 23, 33, 63, 45, 105, 56, 26, 78, 89\]
③10の位でソート
データ:\[12, 23, 33, 63, 45, 105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | | | | | | |
データ:\[23, 33, 63, 45, 105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 12 | | | | | | | | |
データ:\[33, 63, 45, 105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 12 | 23 | | | | | | | |
データ:\[63, 45, 105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 12 | 23 | 33 | | | | | | |
データ:\[45, 105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 12 | 23 | 33 | | | 63 | | | |
データ:\[105, 56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 12 | 23 | 33 | 45 | | 63 | | | |
データ:\[56, 26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 105 | 12 | 23 | 33 | 45 | | 63 | | | |
データ:\[26, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 105 | 12 | 23 | 33 | 45 | 56 | 63 | | | |
データ:\[78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 105 | 12 | 23, 26 | 33 | 45 | 56 | 63 | | | |
データ:\[89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 105 | 12 | 23, 26 | 33 | 45 | 56 | 63 | 78 | | |
データ:\[\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 105 | 12 | 23, 26 | 33 | 45 | 56 | 63 | 78 | 89 | |
④データを、順番に取り出します。
データ:\[105, 12, 23, 26, 33, 45, 56, 63, 78, 89\]
⑤100の位でソート
データ:\[105, 12, 23, 26, 33, 45, 56, 63, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | | | | | | | | | |
データ:\[12, 23, 26, 33, 45, 56, 63, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | | 105 | | | | | | | | |
データ:\[23, 26, 33, 45, 56, 63, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 12 | 105 | | | | | | | | |
データ:\[26, 33, 45, 56, 63, 78, 89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 12,23 | 105 | | | | | | | | |
(省略)
データ:\[89\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | ----------------------------- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 12,23, 26, 33, 45, 56, 63, 78 | 105 | | | | | | | | |
データ:\[\]
| バケツ | B\[0\] | B\[1\] | B\[2\] | B\[3\] | B\[4\] | B\[5\] | B\[6\] | B\[7\] | B\[8\] | B\[9\] |
| --- | --------------------------------- | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ | ------ |
| データ | 12,23, 26, 33, 45, 56, 63, 78, 89 | 105 | | | | | | | | |
⑥データを、順番に取り出します。
データ:\[12, 23, 26, 33, 45, 56, 63, 78, 89, 105\]
ソート完了!
### 実装・結果
なんか、うまく表現できなかった気がします(笑)
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/f0dccfd633b867f55ad07b0b5ecf64e9?ref=geekjp.com)
一応ちゃんと動いてはいるようです。
`[249, 100, 466, 596, 715, 360, 630, 627, 797, 762] [100, 249, 360, 466, 596, 627, 630, 715, 762, 797]`
### 所感
バケットソートと、基数ソートを実装してみました。メモリさえあれば早く動くソートですが、余り実用されているところは見ない気がします。
可視化もやろうかなと思ったのですが、数値をバケツに移動するところをどう表現しようか悩んでちょい保留しました。Javaかjavascriptなら簡単なのになぁと思ったりもしたけど、ちょいと考えてみます。
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問36~問40【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-08-191030/
Last updated: 2019-11-08T10:10:30.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、今回も問題解いていきまーす。
- [R01基本情報技術者試験 秋期試験に挑戦](#R01基本情報技術者試験秋期試験に挑戦)
- [令和元年度 基本情報技術者試験 午前問題 問36~問40](#令和元年度基本情報技術者試験午前問題問36問40)
- [令和元年度 基本情報技術者試験 午前問題 問36](#令和元年度基本情報技術者試験午前問題問36)
- [解説](#解説)
- [令和元年度 基本情報技術者試験 午前問題 問37](#令和元年度基本情報技術者試験午前問題問37)
- [解説](#解説-1)
- [令和元年度 基本情報技術者試験 午前問題 問38](#令和元年度基本情報技術者試験午前問題問38)
- [解説](#解説-2)
- [令和元年度 基本情報技術者試験 午前問題 問39](#令和元年度基本情報技術者試験午前問題問39)
- [解説](#解説-3)
- [令和元年度 基本情報技術者試験 午前問題 問40](#令和元年度基本情報技術者試験午前問題問40)
- [解説](#解説-4)
- [次回予告](#次回予告)
### 令和元年度 基本情報技術者試験 午前問題 問36~問40
#### 令和元年度 基本情報技術者試験 午前問題 問36
マルウェアの動的解析に該当するものはどれか。
| ア | 検体のハッシュ値を計算し、オンラインデータベースに登録された既知のマルウェアのハッシュ値のリストと照合してマルウェアを特定する。 |
| - | ---------------------------------------------------------------- |
| イ | 検体をサンドボックス上で実行し、その動作や外部との通信を観測する |
| ウ | 検体をネットワーク上の通信データから抽出し、さらに、逆コンパイルして取得したコードから検体の機能を調べる。 |
| エ | ハードディスク内のファイルの拡張子とファイルヘッダの内容をもとに、拡張子が偽装された不正なプログラムファイルを検出する。 |
#### 解説
マルウェアは、様々な悪質な意図を含むソフトウェアやコードの総称となっています。
| 種類 | 動作 |
| ------ | -------------------------------------------------------------------------- |
| ウイルス | 他のプログラムに寄生したり、プログラムを妨害したり、有害な作用を及ぼすためのプログラムで、感染機能や自己拡散機能を持つもの |
| ワーム | 独立のファイルで、他のプログラムの動作を妨害し、ユーザにとって有害な作用を及ぼすプログラムで、感染機能や自己拡散機能を持つ(ウィルスとの違いに注意) |
| トロイの木馬 | 無害なプログラムに偽装し、攻撃者の意図する動作を侵入先のコンピュータで秘密裏に行うプログラム |
| スパイウェア | 感染したパソコンのユーザーの個人情報や行動履歴などの内部情報を外部に勝手に送信する |
| キーロガー | コンピュータのキーボード操作を外部に送信する。スパイウェアの一種(悪質ではない用途もある) |
| バックドア | 「裏口」「勝手口」の意味で、偽装など様々な手法で、不正な侵入口を作るプログラムや「裏口」そのもののこと |
| ボット | 侵入者からの指令を受け取り、ユーザーの意図しないリモート操作をするプログラム |
このような不正や妨害を行うプログラムを発見、解析するための手法としては、
- 表層解析
- ファイル名、ファイル種別、ハッシュ値などのマルウェアの表層的特徴をもとに、インターネットや既にある解析データなどを調査する。
- マルウェアを実際に動作させずに外部で調査が行われるので、比較的危険度が低い解析手法
- 動的解析
- ネットワークやシステムから遮断されたスタンドアローン環境内で、実際にマルウェアを動作させ、挙動を解析する。
- 書き換えや通信などの実際の動作や目的を調査する。
- 静的解析
- マルウェアのプログラムを逆コンパイルするなどしてコード解析する(リバースエンジニアリング)。
- 悪意のあるプログラムの場合、可読性が引く状態で書かれていることが多いため、専用の解析ソフトウェアが用いられることも多い。
表層解析:ファイルの特性
動的解析:プログラムの挙動
静的解析:プログラムの作成手順
が解析される。
のを、踏まえて解答ですが、
| ア | 検体のハッシュ値を計算し、オンラインデータベースに登録された既知のマルウェアのハッシュ値のリストと照合してマルウェアを特定する。 |
| - | ---------------------------------------------------------------- |
先ほどの説明からこれは、表層解析の説明です。
| イ | 検体をサンドボックス上で実行し、その動作や外部との通信を観測する |
| - | -------------------------------- |
サンドボックスは、動的解析で用いられる箱には環境なので、動的解析の説明です。
| ウ | 検体をネットワーク上の通信データから抽出し、さらに、逆コンパイルして取得したコードから検体の機能を調べる。 |
| - | ----------------------------------------------------- |
リバースエンジニアリングにより、プログラムを解析しているので静的解析の説明です。
| エ | ハードディスク内のファイルの拡張子とファイルヘッダの内容をもとに、拡張子が偽装された不正なプログラムファイルを検出する。 |
| - | ------------------------------------------------------------ |
これは、よくみると、解析手法ではなく不正なプログラムの検知についてかいているので、そもそも間違いです。
と、いうことで正解は「イ」です。
#### 令和元年度 基本情報技術者試験 午前問題 問37
WPA3はどれか。
| ア | HTTP通信の暗号化企画 |
| - | ---------------------- |
| イ | TCP/IP通信の暗号化企画 |
| ウ | Webサーバで使用するディジタル証明書の規格 |
| エ | 無線LANのセキュリティ規格 |
#### 解説
WPA3(Wi-Fi Protected Access 3)とは、無線LANの暗号化技術であるWPAの新しい規格で、Wi-Fi Allianceによって策定され、2018年6月に発表された、非常に新しい規格です。
これまで使われてきたWPA2は、WPAを改良して、共通鍵暗号アルゴリズムであるAES(Advanced Encryption Standard)に対応させたものでしたが、2017年に[KRACKs](https://securityblog.jp/words/kracks.html?ref=geekjp.com)と呼ばれる脆弱性が発見されました。これにより、通信内容の秘密が守られなくなってしまう可能性があったため、新しく発表された暗号化技術です。
192ビットの暗号と同等の強度を備えた防御機能や、ブルートフォースアタックへの対応策などが実現されています。
ということで、「エ」が正解
#### 令和元年度 基本情報技術者試験 午前問題 問38
メッセージにRSA方式のディジタル署名を付与して2者間で送受信する。そのときのディジタル署名の検証鍵と使用方法はどれか。
| ア | 受信者の公開鍵であり、送信者がメッセージダイジェストからディジタル署名を作成する際に使用する。 |
| - | ----------------------------------------------- |
| イ | 受信者の秘密鍵であり、受信者がディジタル署名からメッセージダイジェストを算出する際に使用する。 |
| ウ | 送信者の公開鍵であり、受信者がディジタル署名からメッセージダイジェストを算出する際に使用する。 |
| エ | 送信者の秘密鍵であり、送信者がメッセージダイジェストからディジタル署名を作成する際に使用する。 |
#### 解説
RSA方式は、秘密鍵と公開鍵の2つの鍵を使う暗号化方式です。
本来、
送信者のデータ暗号化には公開鍵
受信者のデータ復号化には秘密鍵
を使って、データを送受信します。
暗号化用の、公開鍵(送信者全員が持てる)
復号用の、秘密鍵(受信者自分しか持てない)
という組み合わせですが、
逆に、秘密鍵で暗号化したものを、公開鍵で復号出来たら、その秘密鍵の持ち主の正当性(本人かどうか)は保証されるのではないか?というアイディアのもとに出来たがったのが、デジタル署名です。実際に、RSAでは秘密鍵と公開鍵は同じ構造をしているので秘密鍵で暗号化して、公開鍵で復号することは可能です
ただし、秘密鍵から公開鍵はつくれますが、公開鍵からは当然秘密鍵は作れません(作れたら秘密じゃない。。。)
Aさんからもらった公開鍵で復号出来たら、送信者はAさんでしょう。
ってことですね。(秘密鍵で暗号化って、この表現なんか変だけどね)
RSAによるデジタル署名は、
①送信者は、文書をハッシュ関数によりダイジェスト値(ハッシュ値)に変換する
②送信者は、ダイジェスト値と秘密鍵でデジタル署名を生成、データに添付し、送信する
③受信者は、データとデジタル署名を受け取り、公開鍵でダイジェスト値に変換する
④受信者は、受信したデータを①のハッシュ関数で変換し、ダイジェスト値を得る。
⑤変換したダイジェスト値と、復号したダイジェスト値を比較し署名の正しさを確かめる。
検証鍵として使われるのは、送信者の公開鍵であり、受信したデジタル署名をダイジェスト値に変換するのに用いられる。正解は「イ」
#### 令和元年度 基本情報技術者試験 午前問題 問39
情報セキュリティにおいてバックドアに該当するものはどれか。
| ア | アクセスする際にパスワード認証などの正規の手続きが必要なWebサイトに、当該手続きを経ないでアクセス可能なURL | |
| - | ------------------------------------------------------------------- | |
| イ | インターネットに公開されているサーバのTCPポートの中からアクティブになっているポートを探して、稼働中のサービスを特定するためのツール | |
| ウ | ネットワーク上の通信パケットを取得して通信内容を見るために設けられたスイッチのLANポート | |
| エ | プログラムが確保するメモリ領域に、領域の大きさを超える長さの文字列を入力してあふれさせ、ダウンさせる攻撃 | |
#### 解説
| バックドア | 「裏口」「勝手口」の意味で、偽装など様々な手法で、不正な侵入口を作るプログラムや「裏口」そのもののこと |
| ----- | --------------------------------------------------- |
選択肢の中で、裏口から侵入しているのは、当該手続きをしないでアクセス可能なURLを仕掛けている「ア」ですね。
| イ | インターネットに公開されているサーバのTCPポートの中からアクティブになっているポートを探して、稼働中のサービスを特定するためのツール |
| - | ------------------------------------------------------------------- |
これは、いわゆるポートスキャナーの説明ですね。
順番にポートにアクセスし、脆弱性のあるポートや、アクセス可能なポートを調べて、そこに様々な仕掛けをする攻撃です。
| ウ | ネットワーク上の通信パケットを取得して通信内容を見るために設けられたスイッチのLANポート |
| - | --------------------------------------------- |
スイッチにの中には監視対象のポートの通信をコピーして、通信状況を解析する機能がついているものがあります。監視されるポートを"モニターポート"、コピーが流れてくるポートを"ミラーポート"といいます。ミラーポートを使って通信を監視すること自体を、”ポートミラーリング”といいます。
| エ | プログラムが確保するメモリ領域に、領域の大きさを超える長さの文字列を入力してあふれさせ、ダウンさせる攻撃 | |
| - | ---------------------------------------------------- | |
許容量以上のデータを、コンピュータに送り付け誤動作を誘う攻撃をバッファオーバーフロー攻撃と呼びます。
バッファオーバーフローを起こすと、システムがダウンしたり、意図しないプログラムが実行されたりしますので、システム停止や、乗っ取りの危険性があります。
#### 令和元年度 基本情報技術者試験 午前問題 問40
ファイルの提供者は、ファイルの作成者が作成したファイルAを受け取り、ファイルAと、ファイルAにSHA-256を適用して算出した値Bとを利用者に送信する。そのとき、利用者が情報セキュリティ上実現できることはどれか。ここで、利用者が受信した値Bはファイルの提供者から事前に電話で直接伝えられた値と同じであり、改ざんされていないことが確認できているものとする。
| ア | 値BにSHA-256を適用して値Bからディジタル署名を算出し、そのディジタル署名を検証することによって、ファイルAの作成者を確認できる。 |
| - | -------------------------------------------------------------------------------------------- |
| イ | 値BにSHA-256を適用して値Bからディジタル署名を算出し、そのディジタル署名を検証することによって、ファイルAの提供者がファイルAの作成者かどうかを確認できる。 |
| ウ | ファイルAにSHA-256を適用して値を算出し、その値と値Bを比較することによって、ファイルAの内容が改ざんされていないかどうかを検証できる。 |
| エ | ファイルAの内容が改ざんされていても、ファイルAにSHA-256を適用して値を算出し、その値と値Bの差分を確認することによって、ファイルAの内容のうち改ざんされている部分を修復できる。 |
#### 解説
ファイル作成者 ー(ファイルA)ー> ファイル提供者
ファイル提供者 -(ファイルA+値B)-> 利用者
ファイル提供者 -(値B:電話)ー> 利用者
という状況ですね。
SHA-256(Secure Hash Algorithm 256-bit)は、256ビット(32BYTE)のハッシュ関数で、どんな長さの原文からも256ビットの固定長のハッシュ値を算出することができます。
ハッシュ関数は、同じ原文からは必ず同じハッシュ値が得られ、少しでも原文が違うと、全く違うハッシュ値が得られるように設計されている。
そして、先ほどの問38とも関連がある問題です。
デジタル署名を得るには、公開鍵暗号方式を用いて、さらに秘密鍵が必要でした。なので「ア」「イ」は、問題文の状況だけ(ハッシュ関数のみ)では実現されません。
「ウ」は、ハッシュ値を用いて送信前のメッセージと、送信後のメッセージが同じかどうか検証しています。ハッシュ値を利用すると、このように通信経路上でデータが改ざんされていないかどうかを検証できます。「ウ」が正解。
「エ」では、ハッシュ値を用いて、改ざんされた部分の修復をしようとしていますが、できるわけありません(笑)
### 次回予告
うーん。文字ばっかりでつらくなってきましたね。
ちなみに、じじいは、マネジメント系はめっちゃ苦手です(笑)
お勉強がてらに、調べながら解いてみようかなぁとは思っています。
良かったら、押してください!↓↓↓
にほんブログ村
### 【紅葉】八幡平アスピーテラインと森の大橋【落ち葉】
URL: https://www.geekjp.com/2019-11-08-134827/
Last updated: 2019-11-08T04:48:27.000Z
- [【紅葉】八幡平アスピーテラインと森の大橋【落ち葉】](#紅葉八幡平アスピーテラインと森の大橋落ち葉)
- [紅葉を見に](#紅葉を見に)
- [岩手県北周辺の紅葉おすすめスポット(ネットで適当にピックアップ)](#岩手県北周辺の紅葉おすすめスポットネットで適当にピックアップ)
- [八幡平・松川渓谷](#八幡平松川渓谷)
- [県道から樹海ラインへ](#県道から樹海ラインへ)
- [交差点から樹海ラインへ~森の大橋へ](#交差点から樹海ラインへ森の大橋へ)
- [森の大橋到着](#森の大橋到着)
- [樹海ライン~松川温泉~アスピーテラインへ](#樹海ライン松川温泉アスピーテラインへ)
- [所感](#所感)
- [まさかの雪](#まさかの雪)
### 紅葉を見に
秋も深まってきて、母のリクエストでまだ紅葉見れるところはないかと探してみました。
んー。11月に入ってしまうと岩手県北ではほとんど枯れ木状態、しかも、前回の記事で書いたとおり、今年は寒暖差が激しかったせいで、広葉樹が赤くならず黄色いまま散ってしまっている状態でした。
[https://ko-gaku-jiji.hatenablog.jp/entry/2019/11/05/212735](https://www.geekjp.com/2019-11-05-212735/)
ネットで、何個か候補を調べてみました。
#### 岩手県北周辺の紅葉おすすめスポット(ネットで適当にピックアップ)
- 平庭高原
- 岩手県久慈市(旧山形村)
- 見どころは、広大なシラカバ林とカエデやモミジのコントラスト
- 久慈渓流
- 岩手県久慈市
- [https://matome.naver.jp/odai/2144298421807844101/2144300167434254103](https://matome.naver.jp/odai/2144298421807844101/2144300167434254103?ref=geekjp.com)
- 渓流釣りの名所、ブナやカエデなどの広葉樹と渓谷・渓流が美しいです
- 八幡平・松川渓谷
- 岩手県八幡平市(旧松尾村)
- 岩手山のふもとで広大な景色が望める名所、周辺の紅葉と岩手山の景色が一度に楽しめる
ほかにも、葛巻や馬仙峡など候補が出ましたが、いろいろ話しているうちにお昼になってしまったため近場の八幡平へ行くことに(笑)
### 八幡平・松川渓谷
八幡平は、岩手と秋田の中間に位置していて、昔から温泉地やスキー場などが集まっていてそれなりに有名なスポットだと思います。
その周辺を流れているのが松川です。北上川に注ぎ込む河川で、昔は松尾鉱山の鉱毒が流れて、その中和のために薬品を混ぜて川に流していたので川の色が赤かったり、魚がほとんどいなかったりの川だったのですが、今はかなりきれいになっています。
[http://www.jogmec.go.jp/mp\_control/matsuo\_mine\_001.html](http://www.jogmec.go.jp/mp%5Fcontrol/matsuo%5Fmine%5F001.html?ref=geekjp.com)
子供のころは、松川で釣った魚は食うなとか言われたんですが、今は安心のようです。
さて、今回のコースですが、予定では以下のコースでした。
樹海ラインを通って、アスピーテラインに合流し、ぐるっと回って帰ってくる。
途中で、バエスポットがあるので、バエてくると(笑)
#### 県道から樹海ラインへ
県道23号大更(おおぶけ)八幡平線をずんずん八幡平方面にすすみます。
図 県道23号を直進
道が細くなったり、気に囲まれたりなんか不安になりますが、まーっすぐすすみます。
不安になったら、外を見ましょう、岩手山がお出迎えしてくれます(笑)
図 岩手山のお出迎え
見づらい八幡平市のようこそ看板に歓迎された後、交差点まで行くと喫茶店やラーメン屋があり少し安心します。
図 八幡平へようこそ
ただ、標識や看板が古いままで、どこに行くと何があるか混乱します。
(八幡平スキー場、松川スキー場は今はありません)
#### 交差点から樹海ラインへ~森の大橋へ
図 八幡平交差点標識
とりあえず樹海ラインに合流します。
八幡平の交差点をまっすぐ進み県道212号線へ合流します。
図 県道212号線
また、山と木に囲まれた道路が続きますが、ゲームでしか見ないようなコーナーがところどころありますので油断せずに運転してください。
しかも、**落ち葉が雨や露で湿っていると、雪と同じようにスリップします。**
それで滑ったら、落ち葉だらけなのでゲームのように逆ハンなんて効きませんよ!
そのまま行くと、下倉スキー場の入り口が見えてきます。
図 下倉スキー場入口
212号線の来た方向から見て、右手に下倉スキー場、左手に目的の「森の大橋」があります。
図 森の大橋
#### 森の大橋到着
路肩に駐車スペースがありますので、そこに駐車して端のほうに歩きます。
橋から、見渡すと
図 森の大橋から滝を眺める
おお、きれい!
滝の逆側も
川も、山も、空もきれいですね。
ただ、紅葉って意味ではもう枯れ木になっていてちょっと残念でした。
やっぱり赤くなる前に落ちちゃったんですね。
川の方にも降りていけるみたいで、河原に降りて遊んでいる家族もいました。
また、川沿いに遊歩道があり(ちょっと険しいですが)ちょっとしたお散歩もできます。
図 遊歩道からの眺め
遊歩道からそのまま、玄武岩の方にも行けますよ!
図 玄武岩入口
玄武岩は以下のようなもので、岩の成り立ちによって、幾何学的な構造が見られる柱状節理が見られます。
[](http://daiwaresort.lekumo.biz/hachimantai/images/2018/06/12/01.jpg?ref=geekjp.com)
画像:八幡平公式ブログ
#### 樹海ライン~松川温泉~アスピーテラインへ
景色も堪能できたので、ドライブ再開です。
図 松川温泉を超えてアスピーテラインへ
樹海ラインを登っていくと、松川温泉が近づいてきます。
だんだん、硫黄のにおい(いわゆる屁臭い)がしてくるので近づいているのがすぐわかります。
図 松川温泉
松川荘、峡雲荘、松楓荘などの(これで全部じゃないかな?)温泉宿があります。泉質は、バリッバリの硫黄泉で、湯温も高く入った瞬間体にしみこむ感じがします。
また、近くに日本初の地熱発電所があったりもしますので、一度見てみると面白いです。
[](https://www.pref.iwate.jp/%5Fres/projects/default%5Fproject/%5Fpage%5F/001/023/983/01%5Fhatudensho.jpg?ref=geekjp.com)
画像:岩手県
また、正真正銘本物の温泉卵が売っていたりしますので、近くまで来たらぜひどうぞ。
### 所感
#### まさかの雪
と、温泉を超えたあたりで、フロントからずにかつかつと謎の物体が当たるように、、、あられ(霰)じゃん。
まぁ、大丈夫だろうなとそのまま運転していたら、普通に雪降ってきました。
こりゃだめだなと引き返しました。
仕方ないので、松尾八幡平物産館あすぴーてで買い物して、隣のビジターセンター覗いて帰りました。
図 松尾八幡平ビジターセンターと物産館あすぴーて
無念。。。
図 松尾八幡平ビジターセンター
記事が気に入ったら、押してほしいです!
にほんブログ村
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問32~問35【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-06-230843/
Last updated: 2019-11-06T14:08:43.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、問題解いていきまーす。
- [R01基本情報技術者試験 秋期試験に挑戦](#R01基本情報技術者試験秋期試験に挑戦)
- [令和元年度 基本情報技術者試験 午前問題 問32~問35](#令和元年度基本情報技術者試験午前問題問32問35)
- [令和元年度 基本情報技術者試験 午前問題 問32](#令和元年度基本情報技術者試験午前問題問32)
- [解説](#解説)
- [令和元年度 基本情報技術者試験 午前問題 問33](#令和元年度基本情報技術者試験午前問題問33)
- [解説](#解説-1)
- [令和元年度 基本情報技術者試験 午前問題 問34](#令和元年度基本情報技術者試験午前問題問34)
- [解説](#解説-2)
- [令和元年度 基本情報技術者試験 午前問題 問35](#令和元年度基本情報技術者試験午前問題問35)
- [解説](#解説-3)
- [次回予告](#次回予告)
### 令和元年度 基本情報技術者試験 午前問題 問32~問35
#### 令和元年度 基本情報技術者試験 午前問題 問32
メディアコンバータ、リピータハブ、レイヤ2スイッチ、レイヤ3スイッチのうち、レイヤ3スイッチだけが持つ機能はどれか。
| ア | データリンク層におおいて、あて先アドレスに従って適切なLANポートにパケットを中継する機能 |
| - | --------------------------------------------- |
| イ | ネットワーク層において、あて先アドレスに従って適切なLANポートにパケットを中継する機能 |
| ウ | 物理層において、異なる伝送媒体を接続し、信号を相互に変換する機能 |
| エ | 物理層において、入力信号をすべてのLANポートに対して中継する機能 |
#### 解説
ネットワーク機器に関する問題です。
メディアコンバータ、リピータハブ、L2,L3スイッチが登場しています。
それぞれ、
| メディアコンバータ |
| --------------------------------------- |
| 異なる通信媒体同士の接続を行う装置(光ケーブルとCAT5メタルケーブル、など) |
| リピータハブ |
| 送信信号をすべての接続端末に送信する装置 |
| L2スイッチ |
| 接続ポートと接続端末のMACアドレスで通信制御する装置 |
| L3スイッチ |
| レイヤ2スイッチ+ルーティング、ハードウェア版のルータだと思うといいかも |
選択肢を見ると。
| ア | データリンク層におおいて、あて先アドレスに従って適切なLANポートにパケットを中継する機能 |
| - | --------------------------------------------- |
L2スイッチの機能の説明です。MACアドレスはデータリンク層で扱われます。
| イ | ネットワーク層において、あて先アドレスに従って適切なLANポートにパケットを中継する機能 |
| - | -------------------------------------------- |
OSI参照モデルのネットワーク層(第3層)でのアドレッシング、及びルーティングの説明です。
これがL3スイッチかな
| ウ | 物理層において、異なる伝送媒体を接続し、信号を相互に変換する機能 |
| - | -------------------------------- |
メディアコンバータの説明です。
| エ | 物理層において、入力信号をすべてのLANポートに対して中継する機能 |
| - | --------------------------------- |
リピータハブの説明ですね。
答えになるのは「イ」です。
なんか問題文の日本語変な気もするけど、L3スイッチの説明を書いてあるのは「イ」です。
#### 令和元年度 基本情報技術者試験 午前問題 問33
LANに接続されている複数のPCをインターネットに接続するシステムがあり、装置AのWAN側インターフェースには1個のグローバルIPアドレスが割り当てられている。この1個のグローバルIPアドレスを使って複数のPCがインターネットを利用するのに必要となる装置Aの機能はどれか。
図:接続状況
| ア | DHCP |
| - | -------------- |
| イ | NAPT(IPマスカレード) |
| ウ | PPPoE |
| エ | パケットフィルタリング |
#### 解説
ネットワークの接続方式の問題です。
接続状況を見ると、複数台のPCがハブにつながっていて、その先で装置AとONU経由でインターネットに接続されています。
ONUは光ケーブルとLANケーブルの変換を行います。
ー(ローカルIPアドレス)-【装置A】-(グローバルIPアドレス)-【ONU】-(インターネット)
という接続になります。
読み替えると、装置Aはハブにつながれた複数台のローカルIPアドレスと、グローバルIPアドレスの変換を行って、すべてのPCをインターネットに接続している装置ということになります。
このような変換をおこおなうものに、ネットワークアドレス変換(Network Adress Translation(NAT))があります。しかしながら複数台のPCを同時にアドレス変換することはできません。
そこで、複数台のローカルIPアドレスで1つのグローバルIPアドレスを共有するために、ポート番号とセットでアドレス変換する技術がNAPT(Network Address Port Translation)です。
例えば
図 NAPTのアドレス変換の仕組み
このように、外からのアクセスをポートによる変換テーブルを参照して、ローカルアドレスに変換します。
これにより、NATと違い1対1しか対応できない問題を解決します。
| ア | DHCP |
| - | ---- |
IPアドレスを、端末の接続要求時に動的に割り振る仕組み。(Dynamic Host Configuration protocol)
| イ | NAPT(IPマスカレード) |
| - | -------------- |
NAT+ポート番号で変換テーブルを作りローカルアドレスと、グローバルアドレスを変換する仕組み
IPマスカレードはその、Linuxでの実装のこと。
| ウ | PPPoE |
| - | ----- |
PPP over Ethernetの略、さらに、PPPはPoint to Point Protocolの略で、データリンク層での2点間を接続する仕組みのこと
| エ | パケットフィルタリング |
| - | ----------- |
ルータやファイヤーウォールなどに実装されている、通過パケットを監視して適切なパケットのみを通過させる仕組み
正解は「イ」ですね。
#### 令和元年度 基本情報技術者試験 午前問題 問34
クライアントAがポート番号8080のHTTPプロキシサーバーBを経由してポート番号80のWebサーバCにアクセスしているとき、あて先ポート番号が常に8080になるTCPパケットはどれか。
| ア | AからBへのHTTP要求及びCからBへのHTTP応答 |
| - | -------------------------- |
| イ | AからBへのHTTP要求だけ |
| ウ | BからAへのHTTP応答だけ |
| エ | BからCへのHTTP要求及びCからBへのHTTP応答 |
#### 解説
プロキシサーバーの仕組みに関する問題です。
(クライアントA)⇔ (プロキシB:8080)⇔(WebサーバC:80)
という、接続になっています。この中で、常にあて先ポート番号が8080になるものを考えます。
①(クライアントA)→ (プロキシB:8080)のとき
AはあるポートpaからBの8080番に向けてHTTP要求を出します。
②(プロキシB:8080)→(WebサーバC:80)のとき
BはあるポートpbからCの80番に向けてHTTP要求を出します。
③(プロキシB:8080)←(WebサーバC:80)
Cはポート80からBのポートpbに向けてHTTP応答を送ります。
④(クライアントA)← (プロキシB:8080)
Bはポート8080からAのポート
に向けてHTTP応答を送ります。
あて先が、常に8080になるのは、A→Bのところだけなので、「イ」が正解。
#### 令和元年度 基本情報技術者試験 午前問題 問35
攻撃者が用意したサーバXのIPアドレスが、A社WebサーバのFQDN に対応するIPアドレスとして、B社DNSキャッシュサーバに記憶された。これによって、意図せずサーバXに誘導されてしまう利用者はどれか。ここでA社、B社の各従業員は自社のDNSキャッシュサーバを利用して名前解決を行う。
| ア | A社WebサーバにアクセスしようとするA社従業員 | |
| - | ------------------------ | |
| イ | A社WebサーバにアクセスしようとするB社従業員 | |
| ウ | B社WebサーバにアクセスしようとするA社従業員 | |
| エ | B社WebサーバにアクセスしようとするB社従業員 | |
#### 解説
DNSキャッシュポイズニングによるDNS汚染に関する知識を問う問題です。
[https://www.ipa.go.jp/security/vuln/DNS\_security.html](https://www.ipa.go.jp/security/vuln/DNS%5Fsecurity.html?ref=geekjp.com)
が、どっちかというと単純にDNSの仕組みかな。ってより、日本語の問題かな(笑)
**「B社のDNSキャッシュサーバのA社のレコードが、攻撃者のサーバXのものに書き換えられた」**
と、問題を読み替えると簡単かもしれません。
**「B社のキャッシュサーバー経由でA社Webにアクセスしようとすると、攻撃者のサーバXに到達してしまう」**
ので、両社ともに自社のDNSサーバを使うので、
**「B社のキャッシュサーバー経由で=B社の社員が」**
という、置き換えが可能です。
**「B社の社員が、A社Webにアクセスしようとすると、攻撃者のサーバXに到達してしまう」**
ので、答えは「イ」です。
### 次回予告
今回も、まったりゆっくりでした。
よくある傾向ですが、問30~ぐらいになると、図が減ってきて日本語と略文字の問題がふえてきますよね。
それはそれで、解説のしようがなかったり、ググったほうが早かったりして、なんか寂しいです(笑)
良かったら、押してください!↓↓↓
にほんブログ村
### 【紅葉】虹と丹藤川渓流の紅葉と自家焙煎珈琲と
URL: https://www.geekjp.com/2019-11-05-212735-2/
Last updated: 2019-11-05T12:27:35.000Z
- [丹藤川渓流の紅葉](#丹藤川渓流の紅葉)
- [丹藤川渓流](#丹藤川渓流)
- [アクセス](#アクセス)
- [遊歩道と案内図](#遊歩道と案内図)
- [堰周辺と紅葉](#堰周辺と紅葉)
- [所感](#所感)
### 丹藤川渓流
岩手県岩手町川口にある丹藤川渓流の紅葉を見に行ってきました。
私が子供のころは、釣り客や、ダムよこでピクニック、遊歩道や山菜取りで休みの日などはぼちぼち人とすれ違ったものですが、先日行ったときは車一台とすれ違ったのみでした。
[http://town.iwate.iwate.jp/accessmap/tandogawa/](http://town.iwate.iwate.jp/accessmap/tandogawa/?ref=geekjp.com)
岩手町の公式ページによると、
> 丹藤川頭首工を起点とし丹藤川渓流が始まります。
> 川沿いに遊歩道が8km続き、奇岩と清流の春の藤、ツツジ、秋の紅葉が美しい。
> また、丹藤川はヤマメ、イワナ、アユ、等魚の宝庫として太公望を楽しませてくれます。
>
> 施設概要
> 駐車場 専用駐車場なし(車道空きスペースをご利用ください。)
> トイレ なし
遊歩道8キロもあるんですね。春秋には山菜や、山ブドウ、あけびなどがなっていて、その季節の自然を堪能できます。
また、川自体もきれいな清流で、ヤマメ、イワナ、コイなどが釣れます。
私が子供のころは、ウナギも釣れました。
公式ページにも、紅葉写真が載ってますし、結構おすすめスポットなんですね。
### アクセス
入口は、国道4号線沿いにあり、小さな看板が出ています。
こんな感じで、ちゃんと見てないと見逃がします。
丹藤川渓流入り口
少し進むと、踏切があるので気を付けてください。
踏切注意
あとは、ほっそい道をずんずん進んでいきます!
図 あずまやまでの道
最後ちょっとした開けたスペースとあずまやが見えてきます。
こっから上にダム(というか堰(セキ))と遊歩道があります。
### 遊歩道と案内図
図 遊歩道案内図
あずまやのあるところが、現在地です。
実はここからさらに堰の上の方まで川端を通ってくるまで登れます。
でも、何やら道路が不穏な感じでしたので今回はやめておきました。
上に登っていくと、今では珍しい簗漁を行う簗場(ヤナ場)があったり、ハイキングトレッキング好きには見どころの多い遊歩道ではないでしょうか。
簗場まで行けなかったので、山形の簗場の画像を参考までに。。。
[](https://upload.wikimedia.org/wikipedia/commons/2/27/Kiddle%2C%5FShirataka%5FYanakoen%2C%5FRoadside%5FStation%2C%5FYamagata%2C%5FJapan.jpg?ref=geekjp.com)
ちょうど3キロほど歩いたあたりにある、向こう岸にわたる橋(遊歩道丹藤橋)が崩落していてそこまでしか行けないようです。
### 堰周辺と紅葉
図 あずまやと堰と紅葉1
図 あずまやと堰と紅葉2
図 あずまやと堰と紅葉3
町の人たちに話を聞いたら、今年はずっと暖かかったので、赤く紅葉するはずの木が赤くなる前にはっぱを落としてしまっているといってました。
普段はもっと、赤や黄に鮮やかに紅葉するんでしょうね。
十分きれいでしたけどね!
### 所感
久々にきれいな空気と、懐かしい川の香りをかいだ気がしました。
ただ、ちょっと岩手町の人の少なさには悲しい気持ちになってしまいました。
昔はあそこに店があって、あそこにだれだれが住んでいて、駅がどうで、もっとにぎやかだったのになぁ、と感傷に浸ってしまいました。
そんな気持ちの帰り道、ふと外を眺めてみると。。。
図 心の虹
私の気持ちを知ってか知らずか、きれいで大きな虹が!
なんか得した気分になって、そういえば近くに自家焙煎珈琲豆って看板見たことあるなぁって思って、自家焙煎珈琲 自遊工房さんへ、思い付きで車を走らせてみました。
多分この辺です。多分というのは、googleマップのデータが2014年のものなので、まだお店がありません(笑)
自遊工房さん
閉まっとるやないかーい。
県北では珍しい自家焙煎珈琲を売っているお店です。
行ったことある人レポートお願いします(笑)
記事が気に入ったら、押してほしいです!
にほんブログ村
### 【コーヒー部】盛岡のNagasawa Coffeに行ってきた話
URL: https://www.geekjp.com/2019-11-05-180029/
Last updated: 2019-11-05T09:00:29.000Z
- [【コーヒー部】盛岡のNagasawa Coffeに行ってきた話](#コーヒー部盛岡のNagasawa-Coffeに行ってきた話)
- [盛岡とカフェと](#盛岡とカフェと)
- [店内の様子](#店内の様子)
- [珈琲豆](#珈琲豆)
- [テイスティング](#テイスティング)
- [所感](#所感)
### 盛岡とカフェと
20年ぐらい前、盛岡に住んでいた時は、盛岡には小さな喫茶店がわんさかありました。各駅の周辺には必ずちいさな喫茶店があって、電車を待つ間にちょこっとよって、コーヒーや紅茶を嗜む人がいました。
上田にあった、1ドルコーヒーのお店トビー、昭和の終わりぐらいに1ドル200円台だったので、その当時でもかなり安くコーヒーが飲めるお店でした。
当時はコーヒー1杯は、350~500円ぐらいが多かった気がします。
みたけの名店メルシィさんや、中の橋の名物、六分儀さんも閉店してしまいました。現在営業している喫茶店のマスターたちも結構年配の方が多く、盛岡のコーヒー文化がどうなってしまうか、気が気ではないです。
大きなお店が立ち並んで、そこに人があふれて、にぎやかでってのもいいですが、少し小道にそれると小さなお店や喫茶店が立ち並ぶ素敵な商店街があって、どうやって営業を続けているかわからない謎の雑貨屋があったり、これ何に使うの?っていう手作りの道具が売っていたり、古いもののほうがいいとは言わないけれどそういう町って良くないかな?
ってわけで、昔は学生たちが飲み歩いたり、ご飯を食べたりしていた上田の岩手大学側から盛岡中央病院のある通りをつなぐ上田通りにある、Nagasawa Coffeさんに行ってきました。もう、上田通りにあるところがポイント高すぎです。上田通りポイント★5ゲットです。
【上田通り】★★★★★
ちなみ、私が行ったときは近くで工事をしていて、一回お店の場所に気づかずスルーしてしまいました。
駐車場は、お店の隣に3台分(図の位置)、お店の前にコインパーキング40分100円がありますが、お店でいうとチケットくれます(^^♪
図 駐車場の位置
### 店内の様子
店内の様子を撮影したかったのですが、当然他のお客さんがおりましたので撮影はしませんでした。
店内は、オープンなスペースになっており、ライティングも素敵で夕方のアンニュイな時間も素敵に過ごせそうです。
[](https://tblg.k-img.com/restaurant/images/Rvw/95193/95193455.jpg?ref=geekjp.com)
画像:食べログ
スペースは、結構贅沢な使い方になっているのがわかります。手前にある白い袋に入っているものが、今回お目当ての自家焙煎珈琲豆です。
また、お店に入るとすぐに目を引くアンティークな焙煎機がお出迎えしてくれます。私が行った時も実際にマスターが焙煎中でした。
ドアを開けた瞬間の、ロースト中の珈琲豆の香りは、ぜひ一度体験したほうがいいです。実際に行って確かめてみてください。
図:焙煎機
この焙煎機、ドイツの老舗メーカーが1960年代に製造したもので、日本ではなかなか手に入らないものをドイツからわざわざ入手したものらしいです。
甘みと香りが強く出る傾向があるようです。
珍しいものなので撮影していいですか?ってマスターに聞いたときに、笑顔で「どうぞ、いくらでも」って言っていただいてほっこりしました。
(マスターがもっと、頑固おやじ系だと思ってたのは、内緒です(笑))
### 珈琲豆
さて、テーブルに並ぶ素敵なパッケージの珈琲豆ですが、主にシングル、ブレンド、焙煎具合で分類されています。
テーブルには、浅煎り、中煎り、深入り順に豆が並んでいますが、詳しい人じゃないとなかなかな選ぶのも難しいと思います。
そこでマスターか、奥さんに聞くことをお勧めします。好みを言えば、気さくにおすすめの豆を教えてくれると思いますよ。
(マスターがもっと、頑固おやじ系だと思ってたのは、内緒です(笑)その2)
今回は、中煎りの「グアテマラ コバン ブルボン」を200g購入してみました。
図 グアテマラ コバン ブルボン
グアテマラは国名、コバンは地方名、ブルボンは品種です。
裏側に行って、生産地、品種は商品名とリンクしているので置いといて、精製方法、Fully Washed(フルウォッシュ)とあります。
珈琲豆は、果実として収穫されてからショップで見る形の焙煎された珈琲豆になるまでに長い長い精製過程を通ってやっと珈琲豆になります。
主には、収穫して、加工して、乾燥させてやっと生豆と呼ばれる状態になります。
その生豆になるまでの精製の方法として
- ナチュラル
- 果実を自然乾燥させて脱穀→生豆
- 独特の風味があり、エチオピア、ブラジル、イエメンなどがこの方式が多い
- ドライフルーツのような甘みと香り
- ウォッシュド
- 果肉除去機→水洗い(ミューシレージ除去)→乾燥→生豆
- 均質な生豆が生成される、癖がなく適度な甘みや香り
- **フルウォッシュド:発酵液につけて発酵した後に除去**
- セミウォッシュド:機械で一気に除去
- ケニア式:発酵槽で除去、洗浄後、再度水に漬ける
- パルプドナチュラル
- 果肉除去機→乾燥させる→寝かせ→脱殻機→生豆
- ナチュラルよりは癖は弱く、酸味が入る
- 中南米に多い
- スマトラ式
- 果肉除去機→乾燥→半乾きの状態で脱穀→乾燥→生豆
- マンデリンなどの精製手法、穏やかな酸味と独特の香りとコクがある
の4種類があります。
今回の豆はフルウォッシュドなのでクリアな味わいが期待できるってことですね。
また次に書いている標高は、別に関係ないじゃんと思われるかもしれませんが、コーヒー豆の等級が産地の標高で決められているのをご存じでしょうか。
素人の一般知識ですが、標高による味の違いは**標高が高いほど酸味**が現れ、**標高が低いほど苦み**が現れる、と言われています。
また、標高が高いと気候条件が厳しくなり取れる量も気候に影響されやすくなるため、それを潜り抜けてできた豆はしまったいい豆になりプレミアがつきます。
よくグアテマラの豆を買うとSHBとか書いていることがありますよね、あれが標高を表しています。
| 標高 | 等級・グレード |
| ---------- | ---------------------- |
| 1350m~ | SHB(ストリクトリー ハード ビーン) |
| 1200~1350m | HB(ハード ビーン) |
| 1050~1200m | SH(セミ ハード ビーン) |
| 900~1050m | EPW(エクストラ プライム ウォッシュド) |
| 750~900m | PW(プライム ウォッシュド) |
| 600~750m | EGW(エクストラ グッド ウォッシュド) |
| ~600m | GW(グッド ウォッシュド) |
どれどれ、1350m\~1700mほう。。。最高級じゃん(^^♪
焙煎日も書いていますが5日以内の焙煎豆が飲めるなんてすばらしい。
### テイスティング
今回はカリタの3つ穴2~4人用、
| |
| |
ニトリのドリップカップでハンドドリップで入れました。
[](https://www.nitori-net.jp/ecstatic/image/product/8944233/894423306.jpg?ts=20190725162650854&ref=geekjp.com)
豆はメリタの電動グラインダーで3程度で擂りました。
250mlに対し15gの豆を使って淹れてみました。
[おっさんコーヒードリップ練習中 その2](https://youtube.com/watch?v=vc6gJ4QoKAw&ref=geekjp.com)
図 おいしく召し上がれ
### 所感
Nagasawa Coffeさん、良いですね。おしゃれでオープンな外見ですが、マスターも奥さんも気さくで温かいお店でした。
豆の値段は安いほうではありませんが、クオリティを考えると納得のお値段です。(もうちょい高くても不思議はないです)
> コーヒーの香りに満たされた空間を提供する事
>
> 当店はその事を何より大事に考えております。
>
> ぜひコーヒーに満たされて下さい。
自分もコーヒーが好きで、お客さんにも大好きなコーヒーを楽しんでほしいって気持ちが伝わりますね。
ちなみに、今回は豆を買って自分で入れましたが、自称エスプレッソ好きの私にはちょっと気になるものが店内に。。。
[https://ameblo.jp/nagasawa-coffee/entry-11155079550.html](https://ameblo.jp/nagasawa-coffee/entry-11155079550.html?ref=geekjp.com)
イタリア製の、最強エスプレッソマシンの一つとされるものですよね(涎
どうして、お店行ったときに気づかなかったんだろうか
悲しいので、マキネッタでショボエスプレッソ入れて飲みます(私はこれ好きですけどね)
ちょい高いけど、とてもおいしいモカコーヒー(エスプレッソでいいじゃん)が淹れられます。
ぜひ、試してみてください。
| |
| |
初めはこっちの、2カップか、3カップ用を使うのがいいと思います。
| |
| |
もしよかったら、これ押して応援お願いします。
にほんブログ村
へだば、まだねー
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問26~問31【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-05-022118/
Last updated: 2019-11-04T17:21:18.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、問題解いていきまーす。
- [R01基本情報技術者試験 秋期試験に挑戦](#R01基本情報技術者試験秋期試験に挑戦)
- [令和元年度 基本情報技術者試験 午前問題 問26~問31](#令和元年度基本情報技術者試験午前問題問26問31)
- [令和元年度 基本情報技術者試験 午前問題 問26](#令和元年度基本情報技術者試験午前問題問26)
- [解説](#解説)
- [令和元年度 基本情報技術者試験 午前問題 問27](#令和元年度基本情報技術者試験午前問題問27)
- [解説](#解説-1)
- [令和元年度 基本情報技術者試験 午前問題 問28](#令和元年度基本情報技術者試験午前問題問28)
- [解説](#解説-2)
- [令和元年度 基本情報技術者試験 午前問題 問29](#令和元年度基本情報技術者試験午前問題問29)
- [解説](#解説-3)
- [令和元年度 基本情報技術者試験 午前問題 問30](#令和元年度基本情報技術者試験午前問題問30)
- [解説](#解説-4)
- [令和元年度 基本情報技術者試験 午前問題 問31](#令和元年度基本情報技術者試験午前問題問31)
- [解説](#解説-5)
- [次回予告](#次回予告)
### 令和元年度 基本情報技術者試験 午前問題 問26~問31
#### 令和元年度 基本情報技術者試験 午前問題 問26
”得点”表から、学生ごとに全科目の点数の平均を算出し、平均が80点以上の学生の学生番号とその平均点を求める。aに入れる適切な字句はどれか、実践の下線は主キーを表す。
得点(学生番号,科目,点数)
\[SQL文\]
```sql
SELECT 学生番号, AVG(点数)
FROM 得点
GROUP BY [ a ]
```
| ア | 科目 HAVING AVG(点数) >= 80 |
| - | ------------------------- |
| イ | 科目 WHERE 点数 >= 80 |
| ウ | 学生番号 HAVING AVG(点数) >= 80 |
| エ | 学生番号 WHERE 点数 >= 80 |
#### 解説
SQL文の構文に関する問題です。
きっとこんな票があるんだと思います。
表:得点
| 学籍番号 | 科目 | 点数 |
| ---- | -- | --- |
| 1001 | 国語 | 95 |
| 1001 | 数学 | 65 |
| 1001 | 英語 | 80 |
| 1002 | 国語 | 60 |
| 1002 | 数学 | 80 |
| 1002 | 英語 | 50 |
| 1003 | 国語 | 100 |
| 1003 | 数学 | 90 |
| 1003 | 英語 | 95 |
んで、これから、学籍番号別の、平均点を求めて、
| 学籍番号 | avg(点数) |
| ---- | ------- |
| 1001 | 80.0000 |
| 1002 | 63.3333 |
| 1003 | 95.0000 |
その中で平均点が80点以上の人を表示する。
| 学籍番号 | avg(点数) |
| ---- | ------- |
| 1001 | 80.0000 |
| 1003 | 95.0000 |
集計内容に対して、条件を指定するのは
HAVING句
なので、HAVINGで、条件を指定している「ウ」が正解です。
実際やってみます。
```sql
mysql> create table tokuten( stuID int, class nchar(20), score int );
mysql> insert into tokuten values(1001, "国語", 95);
mysql> insert into tokuten values(1001, "数学", 65);
mysql> insert into tokuten values(1001, "英語", 80);
mysql> insert into tokuten values(1002, "国語", 60);
mysql> insert into tokuten values(1002, "数学", 80);
mysql> insert into tokuten values(1002, "英語", 50);
mysql> insert into tokuten values(1003, "国語",100);
mysql> insert into tokuten values(1003, "数学", 90);
mysql> insert into tokuten values(1003, "英語", 95);
mysql> select * from tokuten order by stuID,class;
+-------+--------+-------+
| stuID | class | score |
+-------+--------+-------+
| 1001 | 国語 | 95 |
| 1001 | 数学 | 65 |
| 1001 | 英語 | 80 |
| 1002 | 国語 | 60 |
| 1002 | 数学 | 80 |
| 1002 | 英語 | 50 |
| 1003 | 国語 | 100 |
| 1003 | 数学 | 90 |
| 1003 | 英語 | 95 |
+-------+--------+-------+
9 rows in set (0.00 sec)
mysql> select avg(score) from tokuten;
+------------+
| avg(score) |
+------------+
| 79.4444 |
+------------+
1 row in set (0.00 sec)
mysql> select avg(score) from tokuten group by class;
+------------+
| avg(score) |
+------------+
| 75.0000 |
| 85.0000 |
| 78.3333 |
+------------+
3 rows in set (0.00 sec)
mysql> select class,avg(score) from tokuten group by class;
+--------+------------+
| class | avg(score) |
+--------+------------+
| 英語 | 75.0000 |
| 国語 | 85.0000 |
| 数学 | 78.3333 |
+--------+------------+
3 rows in set (0.00 sec)
mysql> select stuID, avg(score) from tokuten
-> group by stuID having avg(score) >= 80;
+-------+------------+
| stuID | avg(score) |
+-------+------------+
| 1001 | 80.0000 |
| 1003 | 95.0000 |
+-------+------------+
2 rows in set (0.00 sec)
mysql>
```
ほかのはエラーになるので試さなくていいですよね。
#### 令和元年度 基本情報技術者試験 午前問題 問27
関係モデルにおいて、関係から特定の属性だけを取り出す演算はどれか。
| ア | 結合(join) |
| - | -------------- |
| イ | 射影(projection) |
| ウ | 選択(selection) |
| エ | 和(union) |
#### 解説
データベースなどの関係モデルの操作に関する問題です。
| 属性 | 表の列(カラム)のこと |
| -- | ----------- |
| ア | 結合(join) | 複数のテーブルを結合する操作、内部結合と外部結合がある |
| - | -------------- | --------------------------- |
| イ | 射影(projection) | 条件指定した列(カラム)を抽出する操作 |
| ウ | 選択(selection) | 条件指定した行を抽出する操作 |
| エ | 和(union) | selectの結果を1つに統合する操作 |
ということで、正解は「イ」
#### 令和元年度 基本情報技術者試験 午前問題 問28
一つのトランザクションはトランザクションを開始した後、五つの状態(アクティブ、アボート処理、アボート済、コミット処理中、コミット済み)を取り得るものとする。このとき、**とることのない**状態遷移はどれか。
\\(\\begin{array}{|c|c|c|} \\hline {} & 遷移前の状態 & 遷移後の状態 \\\\ \\hline ア & アボート処理中 & アボート済 \\\\ \\hline イ & アボート処理中 & コミット処理中 \\\\ \\hline ウ & コミット処理中 & アボート処理中 \\\\ \\hline エ & コミット処理中 & コミット済 \\\\ \\hline \\end{array}\\)
#### 解説
トランザクション処理の順番を問う問題です。
トランザクション処理では、いわゆるACIDプロパティを保つために、その操作は必ずすべて成功、または失敗しなければなりません。
アボートは、トランザクション処理中に何か異常があったり、処理が失敗した場合に、処理を終了させます。
アボートが起こると、その時行われたすべての更新を廃棄し、ロールバックが起こります。
コミットは、そのトランザクションのこれまでの一連の操作や変更を確定させる処理です。
このことを踏まえると、アボート処理中の後にアボートが完了することなくコミット処理へ移行することはないのは必然的にわかります。ってことで、答えは「イ」
#### 令和元年度 基本情報技術者試験 午前問題 問29
2層ロッキングプロトコルに従ってロックを獲得するトランザクションA、Bを図のように同時実行した場合に、デッドロックが発生しないデータ処理順序はどれか。ここで、readとupdateの位置は、アプリケーションプログラムでの命令発行時点を表す。また、データWへのreadは共有ロックを要求し、データX、Y、Zへのupdateは各データへの専有ロックを要求する。
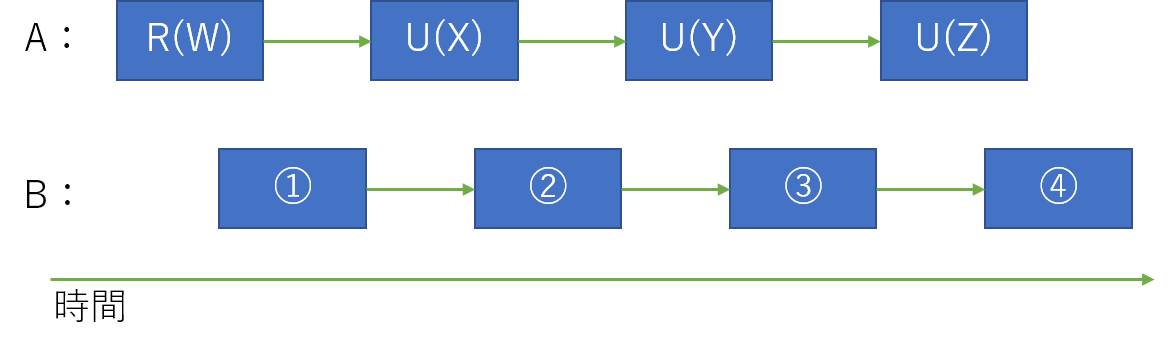
\\(\\begin{array}{ccc} R(x)&:& xへのread要求 \\\\ U(x)&:&xへのupdate要求 \\end{array}\\)
\\(\\begin{array}{|c|c|c|c|c|} \\hline {}&①&②&③&④ \\\\ \\hline ア & R(W) & U(Y) & U(X) & U(Z) \\\\ \\hline イ & R(W) & U(Y) & U(Z) & U(X) \\\\ \\hline ウ & U(X) & R(W) & U(Y) & U(Z) \\\\ \\hline エ & U(Y) & U(Z) & U(X) & R(W) \\\\ \\hline \\end{array}\\)
#### 解説
分散処理や、データベースのトランザクションで使われる2層ロックの問題です。
2層ロックは、
共有ロック(Readロック):読み込みのみを、要求のあったトランザクションすべてに許すロック
専有ロック(Writeロック):ロックしたトランザクションのみが読み書きできる排他的なロック
を用いて、2つのトランザクションを並列的に実行する手法です。
共有ロックは、他社がロックしているものを、ほかの処理がロックしてデータの読み込みのみできますが、専有ロックされると、ロックした処理以外は、そのロックが解除されるまでオブジェクトにアクセスできません。
| 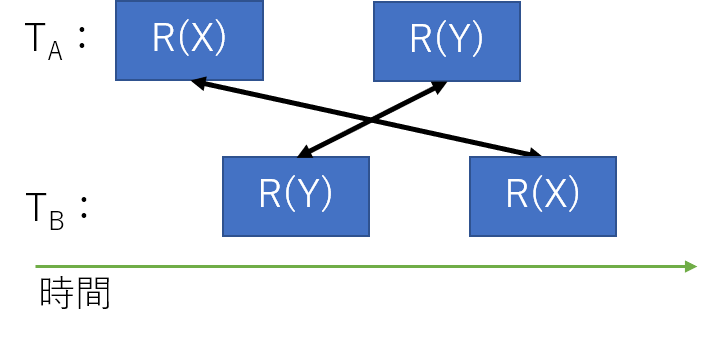 | 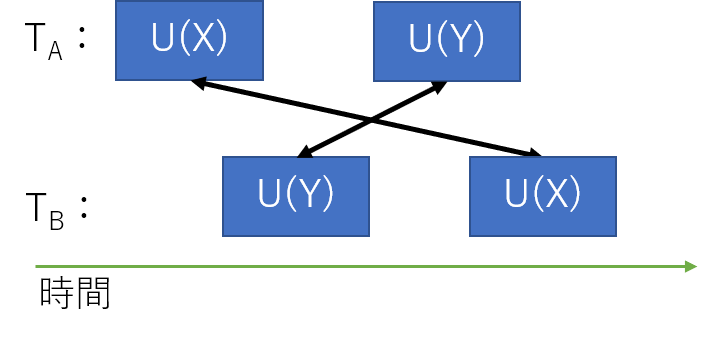 |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| 図1:ロックの共有可能 | 図2:デッドロック発生 |
図2では、TAがXを先にロックし、その後Yをロックしようとしていますが、
すでに、その時点ではTBがYをロックしているため、TBの処理が終了するのを待つことになります。
さらに、TBはその後、Xをロックしようとしていますが、XはすでにTAがロックしてしまっているので、TAのしょりが終了するのを待つことになります。このように、お互いがお互いの処理を待つ状態になりデッドロックが起こります。
選択肢を時系列順に並べて比べてみます。
| ア |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
さっきの図1と同じ状況が起こっているので、デッドロック発生する処理です。
| イ |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
これもお互いに待ち状態が発生しているので、デッドロックします。
| ウ |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
この処理の流れだと、終わった順に順次処理が行われていくので、デッドロックが起こりません。
| エ |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
デッドロックのサンプルと同様、お互いがお互いを待ってますね。
正解は「ウ」ですね。
#### 令和元年度 基本情報技術者試験 午前問題 問30
10Mビット/秒の回線で接続された端末間で、平均1Mバイトのファイルを、10秒ごとに転送するときの回線利用率は何%か。ここで、ファイルの転送時には、転送量の20%が制御情報として付加されるものとし、1Mビット=106ビットとする
| ア | 1.2 | イ | 6.4 | ウ | 8.0 | エ | 9.6 |
| - | --- | - | --- | - | --- | - | --- |
#### 解説
ファイル転送量の問題ですが、どっちかっていうとbitとbyteでミスを誘う問題です。
端末間の回線は
10Mbit/s
10秒に1度 1Mbyteのデータを送信
データ送信には転送量の20%の制御情報が付加される。
10秒に1度 1Mbyte+1Mbyte×0.2=(1+0.2)×**8Mbit**\=9.6**Mbit**(bitに直してある)
のデータが流れます。
これを1秒当たりに直すと、
9.6÷10=0.96Mbit/s
データ量/回線速度 =0.96/10=0.096
百分率に直して9.6%
「エ」が正解
#### 令和元年度 基本情報技術者試験 午前問題 問31
CSMA/CD方式のLANに接続されたノードの送信動作として、適切なものはどれか。
| ア | 各ノードに論理的な順位付けを行い、送信権を順次受け渡し、これを受け取ったノードだけが送信を行う。 |
| - | --------------------------------------------------------------- |
| イ | 各ノードは伝送媒体が使用中かどうかを調べ、使用中でなければ送信を行う。衝突を検出したらランダムな時間の経過後に再度送信を行う。 |
| ウ | 各ノードを環状に接続して、送信権を制御するための特殊なフレームを巡回させ、これを受け取ったノードだけが送信を行う。 |
| エ | タイムスロットを割り当てられたノードだけが送信を行う。 |
#### 解説
| ア | 各ノードに論理的な順位付けを行い、送信権を順次受け渡し、これを受け取ったノードだけが送信を行う。 |
| - | ------------------------------------------------ |
名前があるかわかりませんが、優先制御の説明です。QoSとかの説明でよく見かけます。多分正解じゃないと思います。
| イ | 各ノードは伝送媒体が使用中かどうかを調べ、使用中でなければ送信を行う。衝突を検出したらランダムな時間の経過後に再度送信を行う。 |
| - | --------------------------------------------------------------- |
CSMA/CD方式の説明です。単純な制御方式で効率よく回線を共用できるのが利点だけど、端末の台数の増加とともに急激に性能が落ちるのが知られている。
| ウ | 各ノードを環状に接続して、送信権を制御するための特殊なフレームを巡回させ、これを受け取ったノードだけが送信を行う。 |
| - | --------------------------------------------------------- |
多分、トークンパッシング方式の説明です。円環状にノードを接続し、データの送信権を表すトークンと呼ばれる信号がリング上を高速で周回しており、送信したい端末はこれを取得して送信を開始する。送信が終わるとトークンを再び放流し、別の端末が送信できるようにすることで、ネットワークの衝突を防ぎます。
| エ | タイムスロットを割り当てられたノードだけが送信を行う。 |
| - | --------------------------- |
TDMA(Time Division Multipule Access:時分割多重接続)方式の説明です。データ送信を一定時間間隔で分割して、その分割された単位(スロット)を各ノードに与えることでアクセス制御を行う方式である。
正解は「イ」です。
### 次回予告
これで31問目、ちょっと中途半端な問題数での更新になってしまいました。
試験解説をブログでしている人は結構いますが、あっちのサイトには解説ないかもよ?
こっちで解説見ていってくださいね(笑)
良かったら、押してください!↓↓↓
にほんブログ村
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問21~問25【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-03-013915/
Last updated: 2019-11-02T16:39:15.000Z
## R01基本情報技術者試験 秋期試験に挑戦
基本情報技術者試験(FE)の問題をまったり解いていきます。
IPAの資格試験は、過去問からの出題率が高く、確実に合格するためにはどの区分の試験を受けるにしても過去問学習は大事です。
また、独学でも受験可能ですが、用語が多く初めは戸惑うと思います。が、過去問を十分に学習することで合格点に届くラインまでは問題を解けるようになるとおもいます。今は、オンラインやWEBでもたくさんの解説ページがありますが、Webの情報はどこまでうのみにしていいのかわからない部分もありますので、一応書籍を1~3冊ほど買っておくと確実だと思います。
以下に、私のおすすめ書籍を挙げておきますので、よかったら参考にしてください。
| |
| |
| |
キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験)
最近話題のキタミ式です。解説に漫画や、図表が多く、ビジュアルで訴えてくれるので、繰り返し見ているうちに頭に残りやすいです。
ただ、Amazon等のレビューにもありますが、解説ってよりは用語の羅列とか辞書のような、書き方になっているので、大事なところがわかりづらいという意見も多いです。
| |
| |
| |
平成31/01年 イメージ&クレバー方式でよくわかる 栢木先生の基本情報技術者教室
こちらも有名な、栢木先生シリーズです。イメージはキタミ式と似ていて、図表を多く取り入れており、少し勉強したことがある人なら、頭に書いていることが残りやすいかもしれません。ただ、全くの初学者にとっては、謎の文字と図の羅列に見えてしまうことがありそうです。
現在新版の予約受付中のようです。
| |
| |
| |
平成31年【春期】/01年【秋期】基本情報技術者 合格教本
後は、これを一冊リファレンスとして持っておけば大丈夫かと思います。
これ3冊そろえたら、たいてい合格できるんじゃない?って三兄弟です。
kindle版もありますので、ぜひ通勤途中や、通学途中にお気に入りの音楽でも聴きながら見てみてください!
それでは、問題解いていきまーす。
- [R01基本情報技術者試験 秋期試験に挑戦](#R01基本情報技術者試験秋期試験に挑戦)
- [令和元年度 基本情報技術者試験 午前問題 問21~問25](#令和元年度基本情報技術者試験午前問題問21問25)
- [令和元年度 基本情報技術者試験 午前問題 問21](#令和元年度基本情報技術者試験午前問題問21)
- [解説](#解説)
- [令和元年度 基本情報技術者試験 午前問題 問22](#令和元年度基本情報技術者試験午前問題問22)
- [解説](#解説-1)
- [令和元年度 基本情報技術者試験 午前問題 問23](#令和元年度基本情報技術者試験午前問題問23)
- [解説](#解説-2)
- [令和元年度 基本情報技術者試験 午前問題 問24](#令和元年度基本情報技術者試験午前問題問24)
- [解説](#解説-3)
- [令和元年度 基本情報技術者試験 午前問題 問25](#令和元年度基本情報技術者試験午前問題問25)
- [解説](#解説-4)
- [次回予告](#次回予告)
### 令和元年度 基本情報技術者試験 午前問題 問21~問25
#### 令和元年度 基本情報技術者試験 午前問題 問21
クロックののぼりエッジで、8ビットのシリアル入力、パラレル出力シフトレジスタの内容を上位方向へシフトすると同時に、制論理のデータをレジスタの再開ビットに取り込む。また、ストローブの立ち上がりエッジで値を確定する。各信号の波形を観測した結果が図の通りであるとき、確定後のシフトレジスタの値はどれか。ここで、数値は16進数で表記している。
図:タイミングチャート
| ア | 63 | イ | 8D | ウ | B1 | エ | C6 |
| - | -- | - | -- | - | -- | - | -- |
#### 解説
わりと頻出のタイミングチャートを見て、レジスタの値を読み取る問題です。
日本語が割とアレな感じ~~(散らかりまくって読み取りづらい)~~な問題になっています。
ちょっと整理してみます。
- 8ビットのシフトレジスタがあります。
- (そのシフトレジスタは、シリアル入力パラレル出力です)
- レジスタはクロックの立ち上がりエッジ(ポジエッジ)で動作します。
- ポジエッジ時の動作
- レジスタの値を上位へシフト
- 同時にレジスタの最下位ビットに値をセット
- データは制論理で取得
- ストローブの立ち上がりエッジを検出で値を確定し出力
ストローブとは、データの読み取りタイミングを計るための信号のことです。
図:1ビット目の取得
1回目のクロック立ち上がりでは、空のシフトレジスタを上位へ1ビットシフトしてから、最下位ビットへ値1をセットしています。
次に、2回目のクロック立ち上がりでも同様に、上位へ1ビットシフトしてから、最下位に値1をセットします。
図:2ビット目の取得
同様に3~8ビット目まで取得していきます。
図:8ビット目の取得
図:3ビット目の取得
ここで、問題で使われているシフトレジスタは8ビットのものなので、ビットがすべて埋まってしまいます。
しかしながら、タイミングチャートを見てみると、ストローブの立ち上がりエッジまでまだ1クロック(9クロック目)が残っています。
ここで、9クロック目のデータを取ってくると、シフトレジスタの動作としては、一番上位のビットがあふれてしまいます。
図:9ビット目と桁あふれ
そして、ストローブの立ち上がりエッジを検出して、値が確定。
図:値の確定
と、いうことで、答えは10001101を16進数に直して、8Dなので、「イ」が正解。
2、8、16進数と10進数の変換は確実にマスターしてないと解けませんね。
#### 令和元年度 基本情報技術者試験 午前問題 問22
次の回路図の入力と出力の関係として正しいものはどれか。
図:回路図
ア
\\(\\begin{array}{|c|c|c|} \\hline 入力&入力&出力 \\\\ \\hline A & B & X \\\\ \\hline 0 & 0 & 0 \\\\ \\hline 0 & 1 & 0 \\\\ \\hline 1 & 0 & 0 \\\\ \\hline 1 & 1 & 1 \\\\ \\hline \\end{array}\\)
イ
\\(\\begin{array}{|c|c|c|} \\hline 入力&入力&出力 \\\\ \\hline A & B & X \\\\ \\hline 0 & 0 & 0 \\\\ \\hline 0 & 1 & 0 \\\\ \\hline 1 & 0 & 0 \\\\ \\hline 1 & 1 & 1 \\\\ \\hline \\end{array}\\)
ウ
\\(\\begin{array}{|c|c|c|} \\hline 入力&入力&出力 \\\\ \\hline A & B & X \\\\ \\hline 0 & 0 & 0 \\\\ \\hline 0 & 1 & 0 \\\\ \\hline 1 & 0 & 0 \\\\ \\hline 1 & 1 & 1 \\\\ \\hline \\end{array}\\)
エ
\\(\\begin{array}{|c|c|c|} \\hline 入力&入力&出力 \\\\ \\hline A & B & X \\\\ \\hline 0 & 0 & 0 \\\\ \\hline 0 & 1 & 0 \\\\ \\hline 1 & 0 & 0 \\\\ \\hline 1 & 1 & 1 \\\\ \\hline \\end{array}\\)
#### 解説
解答群、はてな記法でうまく表に出来なかった(笑)
論理回路の問題です。
論理回路に詳しい人なら、一目見ただけで答えがわかります。
かの有名な、排他的論理和の回路図です。ちなみに、この回路図で使われている素子の記号は、[MIL記号](https://ja.wikipedia.org/wiki/MIL%E8%AB%96%E7%90%86%E8%A8%98%E5%8F%B7?ref=geekjp.com)と呼ばれます。
さて、本題に戻って、2入力1出力の排他的論理和なので、
入力が両方同じ(00,11)なら、偽
入力がお互い別(10,01)なら、真
になります。なので、「イ」が正解。
または、2変数しかないので、入力ABの組み合わせは(0,0)、(0,1)、(1,0)、(1,1)の4種類しかありません。
なので、確かめちゃえばいいかと思います。
\\(\\begin{array}{l} (A, B)=(0, 0) \\\\ \\overline{A} \\cdot {B} +{A} \\cdot \\overline{B} = \\overline{0} \\cdot {0} +{0} \\cdot \\overline{0} = 1\\cdot0+0\\cdot1 = 0 \\\\ (A, B)=(0, 1) \\\\ \\overline{A} \\cdot {B} +{A} \\cdot \\overline{B} = \\overline{0} \\cdot {1} +{0} \\cdot \\overline{1} = 1\\cdot1 + 0\\cdot 0= 1 \\\\ (A, B)=(1, 0) \\\\ \\overline{A} \\cdot {B} +{A} \\cdot \\overline{B} = \\overline{1} \\cdot {0} +{1} \\cdot \\overline{0} = 0\\cdot0 + 1\\cdot1 = 1 \\\\ (A, B)=(1, 1) \\\\ \\overline{A} \\cdot {B} +{A} \\cdot \\overline{B} = \\overline{1} \\cdot {1} +{1} \\cdot \\overline{1} = 0\\cdot1 + 1\\cdot0 =0 \\\\ \\end{array}\\)
そのまま答えが出ます。
ところで、排他的論理和ですが、
\\(X=\\overline{A} \\cdot {B} +{A} \\cdot \\overline{B}\\)
以外にも
\\(X=({A} + {B}) \\cdot(\\overline{A} + \\overline{B}\\)
や
\\(X=({A} + {B}) \\cdot\\overline{({A} \\cdot {B})}\\)
などとも表せます。覚えておくと、類題がでたときに便利かもしれません。
#### 令和元年度 基本情報技術者試験 午前問題 問23
コードから商品の内容が容易にわかるようにしたいとき、どのコード体系を選択するのが適切か。
| ア | 区分コード |
| - | ----- |
| イ | 桁別コード |
| ウ | 表意コード |
| エ | 連番コード |
#### 解説
コード化の問題ですが、インタフェース設計に分類されているようですね。
- 区分コード
- グループごとに、順番コードを割り当てる手法。自動車の種類をコード化するときに、メーカー別で1000番台はトヨタ、2000番台は日産、3000番台はホンダ。。。の様にグループごとに大きな桁を割り当て、1001番はカローラ、1002番はヴィッツ、1003番はアクア。。。の様に、車種は連番でコード化していく方法です。
- 桁別コード
- コードの桁ごとに意味をもたせたコードです。
- 似ているデータが近くにあり、探しやすい。ABCDEF=>(ABCD):誕生年(西暦)、(E):男女(1:男、0:女)、F:注文個数(0~9)
- 197815→1978年生まれの男性が5個注文した。
- 大分類、中分類、小分類などに分けて、何種類かのデータを一つのコードで表すことができる。
- 表意コード
- コード自体に意味のある文字や略称などを用いて、データを表す。
- アメリカ→USA、ロシア→RUS、黒→BLK、赤→REDなど、略字などを用いる
- 非専門家が見て理解しやすい、二モニックコードとも呼ばれる
- 連番コード
- 会員番号などのような順番に登録するデータに、連番を与えてコード化する方法
- 通番コード、連番コード、シーケンシャルコードなどとも呼ばれる
この中で商品の内容が容易にわかるようにしたいときは、そのまま意味を略字などで表す、文字通りの「表意コード」が適しています。
「ウ」が正解。
#### 令和元年度 基本情報技術者試験 午前問題 問24
H.264/MPEG-4 AVCの説明として、適当なものはどれか。
| ア | 5.1チャンネルサラウンドシステムで使用されている音声圧縮技術 |
| - | ------------------------------- |
| イ | 携帯電話で使用されている音声圧縮技術 |
| ウ | デジタルカメラで使用されている静止画圧縮技術 |
| エ | ワンセグ放送で使用されている動画圧縮技術 |
#### 解説
> H.264(エイチにろくよん)、MPEG-4 AVC(エムペグフォーエーブイシー)は、動画圧縮規格の一つ。
> 従来方式であるMPEG-2などの2倍以上の圧縮効率を実現する。携帯電話などの低ビットレート用途から、HDTVクラスの高ビットレート用途に至るまで幅広く利用されることを想定している。
(引用:wikipedia H.264)
とありますのが、MPEG-4とありますので、動画圧縮の技術なのは大体わかるかと思います。
あとは選択肢を見ると。。。音声、音声、静止画。。。動画「エ」しかねーじゃんw
#### 令和元年度 基本情報技術者試験 午前問題 問25
UMLを用いて表した図の概念データモデルの解釈として、適切なものはどれか。
図:UML
| ア | 従業員の総数と部署の総数は一致する。 |
| - | ----------------------- |
| イ | 従業員は、同時に複数の部署に所属してもよい |
| ウ | 所属する従業員がいない部署の存在は許されない。 |
| エ | どの部署にも存在しない従業員が存在してもよい。 |
#### 解説
UMLのクラス図読み取りの問題です。この問題も、類似問題が定期的に出ていますので、要チェックかと思います。
クラス同士の関係性の読み取りを擂る問題が多いですが、多重度に関して聞かれることが多いようです。
(語弊があるかもしれませんが、ER図として出題されるときもありますが、考え方は一緒です)
これも、あちこちに解説がありますが、多重度は以下の種類があります。
| 多重度の表記 | 意味 |
| ---------- | ---------- |
| 1 または 1..1 | 必ず1 |
| 0..1 | 存在しないかまたは1 |
| * または 0..* | 0以上 |
| 1..* | 1以上 |
関係性としては、「従業員は、部署に所属する」というクラス同士の関係性が記述してあります。
これを踏まえて、方向順に読んでいけばわかります。
**部署→従業員**
各部署には、(0..*)の従業員がいる。 → 各部署には0人以上の従業員がいる。
**従業員→部署**
各従業員は、(1..*)の部署に所属している。 → 各従業員は1つ以上の部署に所属している。
**ア 従業員の総数と部署の総数は一致する**
部署は、従業員が一人もいなくても成り立つし、従業員は複数の部署に所属できるので、間違い
**イ 従業員は同時に複数の部署に所属してもよい。**
従業員は、必ず1つ以上(複数可)の部署に所属しているので、正解
**ウ 所属する従業員がいない部署の存在は許されない**
部署は、従業員が一人もいなくても成り立つので、間違い
**エ どの部署にも所属しない従業員が存在してもよい。**
従業員は、必ず1つ以上の部署に所属しているので、間違い
### 次回予告
やっとこ25問目、試験解説をブログでしている人は結構いますが、ほとんどお勉強した人向けの内容で優しくないこと多いみたいなんで、猫でもわかる系の説明をしていこうと思っています。
気に入ってくれたら、ブクマしてくださいね。
良かったら、押してください!↓↓↓
にほんブログ村
### 【基本情報処理技術者試験】最新問題のテクノロジ系をまったり解く 問16~問20【令和元年度秋試験】
URL: https://www.geekjp.com/2019-11-01-203250/
Last updated: 2019-11-01T11:32:50.000Z
## R01基本情報技術者試験 秋期試験に挑戦
| |
| ---------------------------------------- |
| キタミ式イラストIT塾 基本情報技術者 平成31/01年 (情報処理技術者試験) |
- [R01基本情報技術者試験 秋期試験に挑戦](#R01基本情報技術者試験秋期試験に挑戦)
- [令和元年度 基本情報技術者試験 午前問題 問16~問20](#令和元年度基本情報技術者試験午前問題問16問20)
- [令和元年度 基本情報技術者試験 午前問題 問16](#令和元年度基本情報技術者試験午前問題問16)
- [解説](#解説)
- [令和元年度 基本情報技術者試験 午前問題 問17](#令和元年度基本情報技術者試験午前問題問17)
- [解説](#解説-1)
- [令和元年度 基本情報技術者試験 午前問題 問18](#令和元年度基本情報技術者試験午前問題問18)
- [解説](#解説-2)
- [令和元年度 基本情報技術者試験 午前問題 問19](#令和元年度基本情報技術者試験午前問題問19)
- [解説](#解説-3)
- [令和元年度 基本情報技術者試験 午前問題 問20](#令和元年度基本情報技術者試験午前問題問20)
- [解説](#解説-4)
- [次回予告](#次回予告)
### 令和元年度 基本情報技術者試験 午前問題 問16~問20
#### 令和元年度 基本情報技術者試験 午前問題 問16
2台の処理装置からなるシステムがある。少なくともいずれか一方が正常に動作すればよいときの稼働率と、2台とも正常に動作しなければならない時の稼働率の差はいくらか。ここで、処理装置の稼働率はいずれも0.9とし、処理装置以外の要因は考慮しないものとする。
| ア | 0.09 | イ | 0.10 | ウ | 0.18 | エ | 0.19 |
| - | ---- | - | ---- | - | ---- | - | ---- |
#### 解説
システムの稼働率の計算です。この問題は、3年に1回くらいは見ますね。
こんな感じで基本情報技術者試験の問題の4割は過去問ゲーなので、過去問チェックは大事です!
2台の装置があって、2つのケースが設定されています。
①システムとして、一方が動作していれば稼働するもの
②システムとして、両方が正常に動作しなければならないもの
これは、言い換えると、
①並列に装置を並べたシステム
②直列に装置を並べたシステム
となります。それぞれの稼働率の計算は以下のようになります。
図:システム稼働率の計算
計算していきます。それぞれの稼働率は0.9なので、
①(並列の稼働率)= 1 - (1 - 0.9)×(1 - 0.9) = 0.99
②(直列の稼働率)= 0.9 × 0.9 = 0.81
①-②=0.18 となり、「ウ」が正解
ところで、直列の時の稼働率は、両方の装置が同時に動いている確率を出せばいいので、二つの装置の稼働率同士をかければいいのは、直感的でわかりやすいと思います。それでは、並列の場合の稼働率はどうやって導き出したらいいでしょうか?参考書やその辺のページ見ても、結構公式だけ書いちゃってるものが多いです。
**そこで・・・ちょいと考えてみます。**
2台を並列に並べた時の、稼働状態をすべて考えてみます。
稼働=〇、故障=×で表します。
| | 装置S1 | 装置S2 | 確率 |
| - | ---- | ---- | ---------------------------- |
| ① | 〇 | 〇 | 0.9×0.9 = 0.81 |
| ② | 〇 | × | 0.9 × (1-0.9) = 0.09 |
| ③ | × | 〇 | 0.9 × (1-0.9) = 0.09 |
| ④ | × | × | (1 - 0.9) × (1 - 0.9) = 0.01 |
どちらかが正常稼働していれば良い=①+②+③ = 1 - ④ = 0.99
となります。並べてみると簡単ですね。
#### 令和元年度 基本情報技術者試験 午前問題 問17
図の送信タスクから受信託すくにT秒間連続してデータを送信する。1秒当たりの送信量をS、1秒当たりの受信料をRとしたとき、バッファがオーバーフローしないバッファサイズLを表す関係式として適切なものはどれか。ここで、受信タスクよりも送信タスクの方が転送速度は速く、次の転送開始までの時間間隔は十分にあるものとする。
(送信タスク)-(S)ー>(バッファサイズ:L)-(R)->(受信タスク)
| ア | \\(L < (R-S) \\times T\\) |
| - | ------------------------------ |
| イ | \\(L < (S-R) \\times T\\) |
| ウ | \\(L \\geqq (R-S) \\times T\\) |
| エ | \\(L \\geqq (S-R) \\times T\\) |
#### 解説
バッファと送受信データ量の関係に関する問題です。
単純に考えちゃえば解けます。
バッファLには1秒当たり、Sのデータが入ってきて、
バッファLから1秒当たり、Rのデータが受信タスクに吸い取られます。
つまり、T秒後には (S-R)×T のデータがバッファに残っているということになります。
それがL以下の時はバッファはあふれないので、「エ」の \\(L \\geqq (S-R) \\times T\\) が正解!
#### 令和元年度 基本情報技術者試験 午前問題 問18
優先度に基づくプリエンプティブなスケジューリングを行うリアルタイムOSで、2つのタスクA、Bをスケジューリングする。Aの方がBよりも優先度が高い場合にリアルタイムOSが行う動作のうち、適切なものはどれか?
| ア | Aの実行中にBに起動がかかると、Aを実行可能状態にしてBを実行する。 |
| - | ---------------------------------- |
| イ | Aの実行中にBに起動がかかると、Aを待ち状態にしてBを実行する。 |
| ウ | Bの実行中にAに起動がかかると、Bを実行可能状態にしてAを実行する。 |
| エ | Bの実行中にAに起動がかかると、Bを待ち状態にしてAを実行する。 |
#### 解説
リアルタイムOSやマルチタスクのスケジューリング方式の問題です。
マルチタスクの方式には、
**①ノンプリエンプティブ方式**
→プログラム側が短時間で区切られていた時間ごとにOSに制御を返し、別の処理に切り替える方式のこと。切り替えタイミングはプログラムごとに決められる。
**②プリエンプティブ方式**
→ユーザーやOS側が決めた優先度順に、プログラムを実行待機状態にしておき、実行するプログラムを切り替える方式。待たされるほうは、状態を保存しておきすぐに再開可能な状態で待機する。
選択肢中の待ち状態というのが問題になるんでしょうね。「Bの起動中に優先度の高いAが起動すると」までは、おそらくいいのですが、Bを待ち状態にするのか、Bを実行可能状態にするのかが正解、不正解の分かれ目になると思います。
この場合に正しいのは、Bは、待っている間でも、以前の状態を保存してすぐに実行可能な状態で待っているので、「ウ」が正解ということらしいです。(私は間違えました(笑))
タスクの状態には、以下の3つがあります。
| 待ち状態 | 入力待ちなどで、タスクが止まっている状態 |
| ------ | -------------------- |
| 実行可能状態 | CPUさえ空けばすぐに実行可能な状態 |
| 実行状態 | タスクが実行されている状態 |
基本的に、1つのタスクしか実効状態にはできないので、OSの機能でこれらをうまく制御して様々なタスクが、あたかも同時に動いているように見せるのがスケジューラーということになります。
関連する用語として、
- プリエンプション
- ディスパッチ
- コンテキスト切り替え
なども調べおくといいかもしれません。(今回は省きますw)
#### 令和元年度 基本情報技術者試験 午前問題 問19
バックアップ方式の説明のうち、増分バックアップはどれか。ここで最初のバックアップでは、すべてのファイルのバックアップを取得し、OSが管理しているファイル更新を示す情報はリセットされるものとする。
| ア | 最初のバックアップの後、ファイル更新を示す情報があるファイルだけをバックアップし、ファイル更新を示す情報は更新しないでそのまま残しておく。 |
| - | ------------------------------------------------------------------------------- |
| イ | 最初のバックアップの後、ファイル更新を示す情報にかかわらず、すべてのファイルをバックアップし、ファイル更新を示す情報はリセットする。 |
| ウ | 直前に行ったバックアップの後、ファイル更新を示す情報があるファイルだけをバックアップし、ファイル更新を示す情報はリセットする。 |
| エ | 直前に行ったバックアップの後、ファイル更新を示す情報にかかかわらず、すべてのファイルをバックアップし、ファイル更新を示す情報は変更しないでそのまま残しておく。 |
#### 解説
ファイルシステムとバックアップに関する問題です。
増分バックアップについての問題で、まず用語を知らないとですね。
増分バックアップでは、**前回のバックアップ時から、更新や追加のあった部分のみ**をバックアップしていきます。毎回毎回、前回と変わった部分のみがバックアップされます。
なので、
| ウ | 直前に行ったバックアップの後、ファイル更新を示す情報があるファイルだけをバックアップし、ファイル更新を示す情報はリセットする。 |
| - | --------------------------------------------------------------- |
とありますので、「ウ」が正解!
ところで、似たようなバックアップ法に差分バックアップがあります。
用語が似ていますが、差分バックアップでは、初回フルバックアップまでは同じですが、次のバックアップ時から毎回、初回バックアップから更新・追加された部分をバックアップします。
| バックアップ法 | 初回 | 2回目 | 3回目 | ・・・ | |
| -------- | -------- | ------- | -------- | -------- | --- |
| 差分バックアップ | フルバックアップ | 初回からの差分 | 初回からの差分 | 初回からの差分 | ・・・ |
| 増分バックアップ | フルバックアップ | 初回からの差分 | 1回目からの差分 | 2回目からの差分 | ・・・ |
ここで、差分=更新・追加箇所のこととする。
差分バックアップでは、初回バックアップからある程度の期間がたち、初回からの差分が大きくなるとバックアップの時間と容量が増えてしまいます。また、毎回のバックアップを残しておくと、差分が大きくなればなるほど毎回大きな差分ファイルを保存することになります。(世代を残しておくと容量をくう)
復元時には、必ず「**初回バックアップ+ある世代の差分**」の2ファイルから復元なのでシンプルです。
一方、増分バックアップでは、前回との差分のみ残しておくので、更新・追加部分がなければないほどファイル容量は小さく、バックアップ時間も短くなります。世代を残すときでも容量の増加は少なくて済みます。
復元時には、その世代から初回バックアップまでの間のすべての差分ファイルが必要になり、復元作業が複雑になりがちです。また、途中の世代の差分に障害が生じたりすると目も当てられない状況に。。。
ちなみに、私は、lsyncdでバックアップサーバーを立てておいて、さらに差分派です。
#### 令和元年度 基本情報技術者試験 午前問題 問20
DRAMの特徴はどれか。
| ア | 書き込み及び消去を一括またはブロック単位で行う | |
| - | ------------------------------------- | |
| イ | データを保存するためのリフレッシュ操作またはアクセス操作が不要である | |
| ウ | 電源が遮断された状態でも、記憶した情報を保持することができる。 | |
| エ | メモリセル構造が単純なので高集積化することができ、ビット単価を安くできる。 | |
#### 解説
DRAMの特徴に関する問題です。この問題も3年に1回くらい見る気がします。
RAMとROMの違いは、大丈夫ですよね?
RAM:Random Access Memory の略で、読み出し専用のデータ保存専門のメモリです。
RAM:Random Access Memory の略で、読み書きができる作業用のメモリです。
そして、次にそのRAMの種類のはなしになります。
| DRAM | Dynamic RAM | 揮発性[\*1](#f-e63a5477 "電力供給がないとデータ消える") | 記憶を保持し続けるためにリフレッシュが必要 | 比較的安価 |
| ---- | ----------- | -------------------------------------- | --------------------- | ----- |
| SRAM | Static RAM | 揮発性 | アクセスが高速でリフレッシュ不要 | 比較的高価 |
SRAMはキャッシュメモリなどに用いられて比較的高価で容量が稼げません。
ということで、DRAMのことを書いてあるのは「エ」ということになります。
その他にフラッシュROMなんてのもあります。フラッシュメモリとも呼ばれ、不揮発性で書き換え可能なROMです。(もうROMの定義がw)
書き換え可能ですが、開発由来がROMの方から来ているのでROMに分類されているみたいです。
NAND型とNOR型の2種類があります。USBメモリやSDメモリに用いられている技術です。
ちなみに、スマホなどのスペック表記でRAM/ROMというのを見かけることがあります。
基本情報を受けるぐらいの人にはわかると思いますが、あれっておかしい感じがしますよね。
RAM=CPUに対するメインメモリ
ROM=システムに対する内蔵されている外部メモリ
の意味で使われているようです。
今度気を付けてみてみてください!
### 次回予告
まったりと、ちょっとずつ解いていますが、なんだかんだ問20まで来ましたね。
過去問が結構登場している感じがしますが、どうでしょうか?
次も頑張って、解いていきましょう!
良かったら、押してください!↓↓↓
にほんブログ村
[\*1](#fn-e63a5477):電力供給がないとデータ消える
### 令和元年度秋期 基本情報技術者試験 午前 問11~問15|過去問解説
URL: https://www.geekjp.com/2019-11-01-005609/
Last updated: 2026-07-28T17:22:27.000Z
> **この記事について**
> 2019年(令和元年度)秋期に実施された基本情報技術者試験 午前の問11~問15を扱う過去問解説です。現在の試験制度や出題形式とは一部異なりますが、コンピュータサイエンスの基礎学習には引き続き活用できます。
> **出典・引用について**
> 問題文、選択肢および試験問題に含まれる図表は、独立行政法人情報処理推進機構(IPA)が公開している令和元年度秋期試験から引用しています。掲載にあたり、改行、表組み、全角・半角、画像配置などを調整している場合があります。問題の趣旨は変更していません。解説、補足、計算過程および当サイト作成の図は、工学じじいの縁側日記によるものです。
> [IPA公式・問題冊子(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com) / [IPA公式・解答例(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fans.pdf?ref=geekjp.com) / [2019年度の過去問題一覧](https://www.ipa.go.jp/shiken/mondai-kaiotu/2019h31.html?ref=geekjp.com)
## R01基本情報技術者試験 秋期試験に挑戦
- R01基本情報技術者試験 秋期試験に挑戦
- 令和元年度 基本情報技術者試験 午前問題 問11~問15
- 令和元年度 基本情報技術者試験 午前問題 問11
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問12
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問13
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問14
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問15
- 解説
- 次回予告
### 令和元年度 基本情報技術者試験 午前問題 問11~問15
#### 令和元年度 基本情報技術者試験 午前問題 問11
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問11](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
自然数(n)に対して、次の通りに再帰的に定義される(f(n))を考える。(f(5))の値はどれか。
(\\begin{array}{ccccrlcc} f(n)& : & n\\leqq 1 & then &return& 1 & else &return &n + f(n-1) \\end{array})
| ア | 6 | イ | 9 | ウ | 15 | エ | 25 |
| - | - | - | - | - | -- | - | -- |
#### 解説
再帰関数の理解に関する問題です。
見たまま、書くと関数(f(n))は、
| \\(n\\leqq1\\)の場合 | 1を返す |
| ----------------- | ----------------- |
| それ以外の場合 | \\(n+f(n-1)\\)を返す |
という関数です。慣れないと、関数が関数を返すってちょっと混乱しますよね(笑)
それでは解いていきます。
| 入力 | \\(n\\leqq1\\) | return |
| ---------- | -------------- | ------------ |
| \\(f(5)\\) | False | \\(5+f(4)\\) |
| \\(f(4)\\) | False | \\(4+f(3)\\) |
| \\(f(3)\\) | False | \\(3+f(2)\\) |
| \\(f(2)\\) | False | \\(2+f(1)\\) |
| \\(f(1)\\) | True | \\(1\\) |
総合すると
$ \\begin{eqnarray\*} f(5) &=& 5+f(4) = 5+ 4 +f(3) = 5+4+3+f(2) \\ &=&5+4+3+2+f(1) = 5+4+3+2+1=15 \\end{eqnarray\*} $
#### 令和元年度 基本情報技術者試験 午前問題 問12
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問12](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
1GHzのクロックで動作するCPUがある。このCPUは、機械語の1命令を平均0.8クロックで実行できることがわかっている。このCPUは1秒間に平均何万命令を実行できるか。
| ア | 125 |
| - | ------- |
| イ | 250 |
| ウ | 80,000 |
| エ | 125,000 |
#### 解説
MIPS(ミプス)=100万命令毎秒(million instructions per second、1秒間に何百万個の命令が実行できるか)を求める問題の仲間です。
MIPSは秒間当たり何(百万命令)が実行できるか?ですが、問題では、平均何万命令を実行できるか、になっています。単位がちょっと違うんですね。
情報として、1命令あたり 0.8 クロックで実行できることがわかっています。
1命令:0.8 クロック = (x)命令:1 クロック
より、1.25 命令/クロックが求められます。
後は、このCPUのクロック周波数=1秒間当たりのクロック数をかけてあげればいいですね。
CPUは 1 GHz = 1 × 1,000 × 1,000 × 1,000 Hz = 10億クロック/秒です。
したがって、
1.25 x 1000 x 1000 x 1000 命令/S = 1250000000 = 125000 (万)
が導かれるので、「エ」が正解
#### 令和元年度 基本情報技術者試験 午前問題 問13
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問13](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
メイン処理、及び表に示す2つの割り込みA、Bの処理があり、多重割込みが許可されている。割り込みA,Bが図のタイミングで発生するとき、0ミリ秒から5ミリ秒までの間にメイン処理が利用できるCPU時間は何ミリ秒か。ここで、割り込み処理の呼び出し及び復帰に伴うオーバーヘッドは無視できるものとする。
\\( \\begin{array}{|c|c|c|} \\hline 割り込み & 処理時間(ミリ秒)& 割り込み優先度 \\\\ \\hline A & 0.5 & 高 \\\\ \\hline B & 1.5 & 低 \\\\ \\hline \\end{array} \\)
*図:割り込み発生タイミング*
| ア | 2 | イ | 2.5 | ウ | 3.5 | エ | 5 |
| - | - | - | --- | - | --- | - | - |
#### 解説
割り込み処理の問題です。優先度の違う2つの割り込みが用意された処理系で、 割り込み中の割り込みが許可されています。
優先度の低い割り込みの処理時間中に、優先度の高い割り込みが実行されると、優先度の低いほうはいったん待機して、先に優先度の高い割り込み処理が終了するのを待つ。という仕組みです。
それを踏まえて、図を見てみると、
①優先度の低いBが先に割り込みでメイン処理を中断させます。
②その1ミリ秒後に優先度の高い割り込みAが発生します。
③割り込みBは、割り込みAが処理を終了するまでの0.5ミリ秒待機させられて、その後残りの0.5ミリ秒の割り込みを実行します。以下同様に考えていくと
メインで使える部分を数えてみると、2msなので、「ア」が正解
#### 令和元年度 基本情報技術者試験 午前問題 問14
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問14](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
次に示す接続のうち、デイジーチェーンと呼ばれる接続方法はどれか。
| ア | PCと接続機器とをRS-232Cで接続し、PCとプリンタとをUSBを用いて接続する。 |
| - | ---------------------------------------------------------------------------------------------------------------- |
| イ | Thunderbolt接続ポートが2口ある4Kディスプレイ2台を、PCのThunderbolt接続ポートから1台目のディスプレイにケーブルで接続し、さらに1台目のディスプレイと2台目のディスプレイとの間をケーブルで接続する。 |
| ウ | キーボード、マウス及びプリンタをUSBハブにつなぎ、USBハブとPCとを接続する。 |
| エ | 数台のネットワークカメラ及びPCをネットワークハブに接続する。 |
#### 解説
デイジーチェーンの用語説明です。
そもそも、コスモスと、デイジーとマーガレットの区別がつかないのでちょっと難しいです。
冗談はさておきw
本物のデイジーチェーンが何なのか、わかれば想像で答えがわかる問題です。
*図:デイジーチェーン*
ヒナギクで作った花飾りの輪のことをデイジーチェーンというらしいですね。その状態で機器が接続されているのは?
いわゆる数珠つなぎに接続されているのは、「イ」なので、「イ」が正解
#### 令和元年度 基本情報技術者試験 午前問題 問15
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問15](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
RAIDの分類において、ミラーリングを用いることで信頼性を高め、障害発生時には冗長ディスクを用いてデータ復元を行う方式はどれか?
| ア | RAID1 | イ | RAID2 | ウ | RAID3 | エ | RAID4 |
| - | ----- | - | ----- | - | ----- | - | ----- |
#### 解説
なんか、久々にRAID関連の用語に関する問題を見た気がする。。。
RAIDは複数ディスクを用いたデータ保存法です。その接続と冗長性の保持の仕方から種類が分かれています。
$$ \\renewcommand{\\arraystretch}{1.7} \\begin{array}{c|c|c|c} \\textbf{RAID} & \\textbf{仕組み} & \\textbf{長所・特徴} & \\textbf{短所・条件} \\\\ \\hline \\text{RAID 0} & \\begin{array}{c} \\text{複数ディスク分散で}\\\\ \\text{データを記録する}\\\\ \\text{(ストライピング)} \\end{array} & \\begin{array}{c} \\text{アクセス速度の}\\\\ \\text{向上} \\end{array} & \\begin{array}{c} \\text{1台壊れると}\\\\ \\text{アクセス不能} \\end{array} \\\\ \\hline \\text{RAID 1} & \\begin{array}{c} \\text{複数ディスクに}\\\\ \\text{同じデータを記録する}\\\\ \\text{(ミラーリング)} \\end{array} & \\begin{array}{c} \\text{障害耐性の}\\\\ \\text{向上} \\end{array} & \\begin{array}{c} \\text{容量が}\\\\ \\text{半減} \\end{array} \\\\ \\hline \\text{RAID 5} & \\begin{array}{c} \\text{分散記憶}\\\\ +\\text{パリティ}\\\\ \\text{(誤り訂正符号)} \\end{array} & \\begin{array}{c} \\text{障害耐性}\\\\ +\\text{容量が稼げる} \\end{array} & \\begin{array}{c} \\text{最低3台の}\\\\ \\text{ディスクが必要} \\end{array} \\\\ \\hline \\text{RAID 2} & \\begin{array}{c} \\text{分散記憶}\\\\ +\\text{誤り訂正用ディスク}\\\\ \\text{(ハミングコード)} \\end{array} & \\begin{array}{c} \\text{ほぼ}\\\\ \\text{概念上のみ} \\end{array} & \\begin{array}{c} \\text{最低5台}\\\\ \\text{データ2台}\\\\ \\text{誤り訂正3台} \\end{array} \\\\ \\hline \\text{RAID 3} & \\begin{array}{c} \\text{RAID 2の訂正符号を}\\\\ \\text{パリティにしたもの} \\end{array} & \\begin{array}{c} \\text{ほぼ}\\\\ \\text{概念上のみ} \\end{array} & \\begin{array}{c} \\text{最低3台}\\\\ \\text{データ2台}\\\\ \\text{パリティ1台} \\end{array} \\\\ \\hline \\text{RAID 4} & \\begin{array}{c} \\text{ブロック単位保存}\\\\ +\\text{パリティディスク} \\end{array} & \\begin{array}{c} \\text{ほぼ}\\\\ \\text{概念上のみ} \\end{array} & \\begin{array}{c} \\text{最低3台}\\\\ \\text{データ2台}\\\\ \\text{パリティ1台} \\end{array} \\end{array} $$
そのほか、ストライピングをミラーするRAID 0+1やミラーをストライピングするRAID 1+0などがある。
これをふまえて、問題を見てみると、ミラーリングしか書いてないのでRAID1=「ア」が正解なのがわかります。
### 次回予告
今日も、まーったり何問かときました。こうしてみると、なんか、いつもと傾向が違う気がしますね。
少しでも、参考になればうれしいです。
---
## シリーズ内の記事
- 前の記事:[問7~問10の解説](https://www.geekjp.com/2019-10-31-014254/)
- 一覧:[令和元年度秋期 基本情報技術者試験 テクノロジ系まとめ](https://www.geekjp.com/2019-11-18-144908/)
- 次の記事:[問16~問20の解説](https://www.geekjp.com/2019-11-01-203250/)
内容の誤りや分かりにくい箇所は、[お問い合わせページ](https://www.geekjp.com/contact/)からお知らせください。
### 令和元年度秋期 基本情報技術者試験 午前 問7~問10|過去問解説
URL: https://www.geekjp.com/2019-10-31-014254/
Last updated: 2026-07-26T14:10:40.000Z
> **この記事について**
> 2019年(令和元年度)秋期に実施された基本情報技術者試験 午前の問7~問10を扱う過去問解説です。現在の試験制度や出題形式とは一部異なりますが、コンピュータサイエンスの基礎学習には引き続き活用できます。
> **出典・引用について**
> 問題文、選択肢および試験問題に含まれる図表は、独立行政法人情報処理推進機構(IPA)が公開している令和元年度秋期試験から引用しています。掲載にあたり、改行、表組み、全角・半角、画像配置などを調整している場合があります。問題の趣旨は変更していません。解説、補足、計算過程および当サイト作成の図は、工学じじいの縁側日記によるものです。
> [IPA公式・問題冊子(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com) / [IPA公式・解答例(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fans.pdf?ref=geekjp.com) / [2019年度の過去問題一覧](https://www.ipa.go.jp/shiken/mondai-kaiotu/2019h31.html?ref=geekjp.com)
## R01基本情報技術者試験 秋期試験に挑戦
### 令和元年度 基本情報技術者試験 午前問題 問7~問10
#### 令和元年度 基本情報技術者試験 午前問題 問7
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問7](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
次のBNFで定義される変数名に合致するものはどれか。
```text
<数字> ::= 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9
<英字> ::= A | B | C | D | E | F
<英数字> ::= <英字> | <数字> | _
<変数名> ::= <英字> | <変数名><英数字>
```
| 選択肢 | 文字列 |
| --- | ----- |
| ア | \_B39 |
| イ | 246 |
| ウ | 3E5 |
| エ | F5\_1 |
#### 解説
BNF(Backus-Naur Form)の問題です。
BNFの基本的な読み方は、次のとおりです。
```text
<左辺> ::= <右辺>
```
これは、左辺を右辺の規則によって生成できるという意味です。
今回調べる規則は、次の部分です。
```text
<変数名> ::= <英字> | <変数名><英数字>
```
変数名は、最初の1文字が必ず英字になります。その後ろには、英字、数字、またはアンダースコアを追加できます。
各選択肢を分解すると、次のようになります。
```text
ア _B39 = <英数字><英字><数字><数字>
イ 246 = <数字><数字><数字>
ウ 3E5 = <数字><英字><数字>
エ F5_1 = <英字><数字><英数字><数字>
```
ア、イ、ウは、先頭が英字ではありません。したがって、変数名の規則には合致しません。
エの `F5_1` は、次のように生成できます。
```text
F
↓
F5
↓
F5_
↓
F5_1
```
BNFの記号で表すと、次の流れです。
```text
<変数名>
→ <英字>
→ <英字><英数字>
→ <英字><英数字><英数字>
→ <英字><英数字><英数字><英数字>
→ F5_1
```
よって、**エの `F5_1` が正解**です。
#### 令和元年度 基本情報技術者試験 午前問題 問8
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問8](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
A、C、K、S、Tの順に文字が入力される。スタックを利用して、S、T、A、C、Kという順に文字を出力するために、最小限必要となるスタックは何個か。
ここで、どのスタックにおいても、ポップ操作が実行されたときには必ず文字を出力する。また、スタック間で文字を移動することはできない。
| 選択肢 | スタック数 |
| --- | ----- |
| ア | 1 |
| イ | 2 |
| ウ | 3 |
| エ | 4 |
#### 解説
スタックは、後入れ先出し(LIFO)のデータ構造です。
`push(x)`でデータを積み、`pop()`で一番上のデータを取り出します。
例えば、次の順番で操作します。
```text
① push(3)
② push(5)
③ push(2)
④ pop() → 2を取り出す
⑤ push(1)
⑥ pop() → 1を取り出す
⑦ pop() → 5を取り出す
```
スタックの状態は、次のように変化します。左側が取り出し口、右側が底です。
```text
操作前 [ ]
push(3) [ 3 ]
push(5) [ 5 | 3 ]
push(2) [ 2 | 5 | 3 ]
pop() → 2 [ 5 | 3 ]
push(1) [ 1 | 5 | 3 ]
pop() → 1 [ 5 | 3 ]
pop() → 5 [ 3 ]
```
今回の入力順は、次のとおりです。
```text
入力順:A → C → K → S → T
出力順:S → T → A → C → K
```
スタックが1個の場合、すべて積むと次の状態になります。
```text
[ T | S | K | C | A ]
```
最初に取り出せるのはTなので、Sから出力できません。
スタックが2個の場合、Tを別のスタックへ入れることでS、Tまでは取り出せます。
```text
スタック1:[ S | K | C | A ]
スタック2:[ T ]
```
しかし、その後にA、C、Kの順で取り出せません。
配置を工夫しても、2個ではCとKの順番を解決できません。
```text
スタック1:[ S | A ]
スタック2:[ T | K | C ]
```
スタックを3個にすると、次のように配置できます。
```text
スタック1:[ S | A ]
スタック2:[ T | K ]
スタック3:[ C ]
```
この状態なら、次の順番で取り出せます。
```text
S → T → A → C → K
```
よって、**ウの3個が正解**です。
#### 令和元年度 基本情報技術者試験 午前問題 問9
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問9](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
配列Aが図2の状態のとき、図1の流れ図を実行すると、配列Bが図3の状態になった。図1のaに入れる操作はどれか。
ここで、配列A、Bの要素を、それぞれ `A(i,j)`、`B(i,j)` とする。
*図1 流れ図*
*図2 配列Aの状態*
*図3 実行後の配列Bの状態*
| 選択肢 | 操作 |
| --- | -------------------- |
| ア | B(7-i, 7-j) ← A(i,j) |
| イ | B(7-j, i) ← A(i,j) |
| ウ | B(i, 7-j) ← A(i,j) |
| エ | B(j, 7-i) ← A(i,j) |
#### 解説
配列のインデックスを使って、配列Aの配置を時計回りに90度回転させる問題です。
図2と図3を見比べると、例えば次の位置が対応しています。
```text
A(0,1) → B(1,7)
A(7,1) → B(1,0)
A(3,4) → B(4,4)
```
まず、`A(0,1) → B(1,7)`を各選択肢へ代入します。
```text
ア B(7-0, 7-1) = B(7,6)
イ B(7-1, 0) = B(6,0)
ウ B(0, 7-1) = B(0,6)
エ B(1, 7-0) = B(1,7)
```
この時点で、エが対応しています。
ほかの座標でも確認します。
```text
A(7,1) → B(1,0)
エ:B(1, 7-7)
= B(1,0)
→ 一致
```
```text
A(3,4) → B(4,4)
エ:B(4, 7-3)
= B(4,4)
→ 一致
```
よって、**エが正解**です。
#### 令和元年度 基本情報技術者試験 午前問題 問10
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問10](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
10進法で5桁の数 `a1a2a3a4a5` を、ハッシュ表を用いて配列へ格納したい。
ハッシュ関数を次のように定める。
```text
mod(a1 + a2 + a3 + a4 + a5, 13)
```
求めたハッシュ値に対応する位置の配列要素へ格納する場合、54321は配列のどの位置に入るか。
ここで、`mod(x,13)`は、xを13で割った余りとする。
| 選択肢 | 配列の位置 |
| --- | ----- |
| ア | 1 |
| イ | 2 |
| ウ | 7 |
| エ | 11 |
#### 解説
指定されたハッシュ関数へ、54321の各桁を代入します。
```text
mod(5 + 4 + 3 + 2 + 1, 13)
= mod(15, 13)
= 2
```
ハッシュ値は2なので、**イが正解**です。
### 次回予告
次回も、まったり問11から解いていこうと思います。
参考になれば幸いです。
---
## シリーズ内の記事
- 前の記事:[問3~問6の解説](https://www.geekjp.com/2019-10-30-042832/)
- 一覧:[令和元年度秋期 基本情報技術者試験 テクノロジ系まとめ](https://www.geekjp.com/2019-11-18-144908/)
- 次の記事:[問11~問15の解説](https://www.geekjp.com/2019-11-01-005609/)
内容の誤りや分かりにくい箇所は、[お問い合わせページ](https://www.geekjp.com/contact/)からお知らせください。
### 令和元年度秋期 基本情報技術者試験 午前 問1~問2|過去問解説
URL: https://www.geekjp.com/2019-10-30-113249/
Last updated: 2026-07-26T13:45:39.000Z
> **この記事について**
> 2019年(令和元年度)秋期に実施された基本情報技術者試験 午前の問1~問2を扱う過去問解説です。現在の試験制度や出題形式とは一部異なりますが、コンピュータサイエンスの基礎学習には引き続き活用できます。
> **出典・引用について**
> 問題文、選択肢および試験問題に含まれる図表は、独立行政法人情報処理推進機構(IPA)が公開している令和元年度秋期試験から引用しています。掲載にあたり、改行、表組み、全角・半角、画像配置などを調整している場合があります。問題の趣旨は変更していません。解説、補足、計算過程および当サイト作成の図は、工学じじいの縁側日記によるものです。
> [IPA公式・問題冊子(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com) / [IPA公式・解答例(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fans.pdf?ref=geekjp.com) / [2019年度の過去問題一覧](https://www.ipa.go.jp/shiken/mondai-kaiotu/2019h31.html?ref=geekjp.com)
## R01基本情報技術者試験 秋期試験に挑戦
- R01基本情報技術者試験 秋期試験に挑戦
- 令和元年度 基本情報技術者試験 午前問題
- 令和元年度 基本情報技術者試験 午前問題 問1
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問2
- 解説
### 令和元年度 基本情報技術者試験 午前問題
#### 令和元年度 基本情報技術者試験 午前問題 問1
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問1](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
次の流れ図は、10進整数j(0<j<100)を8桁の2進数に変換する処理を表している。2進数は下位桁から順に、配列の要素NISHIN(1)からNISHIN(8)に格納される。流れ図のa及びbに入る処理はどれか?ここで、jdiv2はjを2で割った商の整数部分を、jmod2はjを2で割った余りを表す。
*図:フローチャート*
注意:ループ端の繰り返し指定は、変数名:初期値、増分、終値を示す。
| | a | b |
| - | ------------------- | ------------------- |
| ア | j ← j div 2 | NISHIN(k) ← j mod 2 |
| イ | j ← j mod 2 | NISHIN(k) ← j div 2 |
| ウ | NISHIN(k) ← j div 2 | j ←j mod 2 |
| エ | NISHIN(k) ← j mod 2 | j ← j div 2 |
#### 解説
ちょうどこの前、変数の型の話をしたときに、2進数と10進数の変換やりましたね。
[Pythonで基数変換を考える関連記事](https://www.geekjp.com/2019-10-28-135618-2/)
2で割っていって、余りを下から並べる
```text
2) 20
2) 10 ...0 ←①
2) 5 ...0 ←②
2) 2 ...1
2) 1 ...0
2) 0 ...1
```
10100が2進数で書いた10進数の20ということでした。
処理の流れを見てみると、
ア、イは、jを更新してから、更新したjを使ってNISHIN(k)を更新、
ウ、エは、NISHIN(k)を更新してから、同じjを使ってjを更新、という流れになります。
先ほどの筆算をかんがえると、
①は、**20**を2で割った商を書き、隣に**20**を2で割った余りを書いている
②は、**10**を2で割った商を書き、隣に**10**を2で割った余りを書いている
両方同じjで処理するということですので、ウかエが答えってことになります。
んで、実際に、2進数の数値となるのは、余りの方なので、配列に入るのは確実にmod演算の結果ですね。
じゃぁ、**エが正解**
#### 令和元年度 基本情報技術者試験 午前問題 問2
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問2](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
8ビットの値の全ビットを反転する操作はどれか。
| ア | 16進表記00のビット列と排他的論理和を取る |
| - | ---------------------- |
| イ | 16進表記00のビット列と論理和を取る |
| ウ | 16進表記FFのビット列と排他的論理和を取る |
| エ | 16進表記FFのビット列と論理和を取る |
#### 解説
論理演算の問題です。
論理和と、排他的論理和が出てきています。これらを知らないとどうしようもないですよね。
逆に知ってれば、考えるまでもない問題なのですが、全員がそうとも限らないのでまじめに考えてみます。
それぞれの、1ビットずつでの演算は以下のようになります。
$$\\begin{array}{c|c|c|c}\\text{演算}&X&Y&\\text{出力}\\cr\\hline\\text{論理和}&0&0&0\\cr&0&1&1\\cr&1&0&1\\cr&1&1&1\\cr\\hline\\text{排他的論理和}&0&0&0\\cr&0&1&1\\cr&1&0&1\\cr&1&1&0\\end{array}$$
サンプルに、16進表記のA4(10100100(2)=164(10))を使って、実際に計算してみます。
| ア | 16進表記00のビット列と排他的論理和を取る |
| - | ---------------------- |
$$\\begin{array}{c|cccccccc}\\mathrm{A4}&1&0&1&0&0&1&0&0\\cr\\mathrm{00}&0&0&0&0&0&0&0&0\\cr\\hline\\text{排他的論理和}&1&0&1&0&0&1&0&0\\end{array}$$
| イ | 16進表記00のビット列と論理和を取る |
| - | ------------------- |
$$\\begin{array}{c|cccccccc}\\mathrm{A4}&1&0&1&0&0&1&0&0\\cr\\mathrm{00}&0&0&0&0&0&0&0&0\\cr\\hline\\text{論理和}&1&0&1&0&0&1&0&0\\end{array}$$
| **ウ** | **16進表記FFのビット列と排他的論理和を取る** |
| ----- | -------------------------- |
$$\\begin{array}{c|cccccccc}\\mathrm{A4}&1&0&1&0&0&1&0&0\\cr\\mathrm{FF}&1&1&1&1&1&1&1&1\\cr\\hline\\text{排他的論理和}&0&1&0&1&1&0&1&1\\end{array}$$
| エ | 16進表記FFのビット列と論理和を取る |
| - | ------------------- |
$$\\begin{array}{c|cccccccc}\\mathrm{A4}&1&0&1&0&0&1&0&0\\cr\\mathrm{FF}&1&1&1&1&1&1&1&1\\cr\\hline\\text{論理和}&1&1&1&1&1&1&1&1\\end{array}$$
全部見てみるとウだけが、元のすべてのビットが反転されてますね。
演算結果がわかっていれば並べてみるだけの問題です。
---
## シリーズ内の記事
- 一覧:[令和元年度秋期 基本情報技術者試験 テクノロジ系まとめ](https://www.geekjp.com/2019-11-18-144908/)
- 次の記事:[問3~問6の解説](https://www.geekjp.com/2019-10-30-042832/)
内容の誤りや分かりにくい箇所は、[お問い合わせページ](https://www.geekjp.com/contact/)からお知らせください。
### 令和元年度秋期 基本情報技術者試験 午前 問3~問6|過去問解説
URL: https://www.geekjp.com/2019-10-30-042832/
Last updated: 2026-07-26T13:45:03.000Z
> **この記事について**
> 2019年(令和元年度)秋期に実施された基本情報技術者試験 午前の問3~問6を扱う過去問解説です。現在の試験制度や出題形式とは一部異なりますが、コンピュータサイエンスの基礎学習には引き続き活用できます。
> **出典・引用について**
> 問題文、選択肢および試験問題に含まれる図表は、独立行政法人情報処理推進機構(IPA)が公開している令和元年度秋期試験から引用しています。掲載にあたり、改行、表組み、全角・半角、画像配置などを調整している場合があります。問題の趣旨は変更していません。解説、補足、計算過程および当サイト作成の図は、工学じじいの縁側日記によるものです。
> [IPA公式・問題冊子(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com) / [IPA公式・解答例(PDF)](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fans.pdf?ref=geekjp.com) / [2019年度の過去問題一覧](https://www.ipa.go.jp/shiken/mondai-kaiotu/2019h31.html?ref=geekjp.com)
## R01基本情報技術者試験 秋期試験に挑戦
- R01基本情報技術者試験 秋期試験に挑戦
- 令和元年度 基本情報技術者試験 午前問題 問3\~問6
- 令和元年度 基本情報技術者試験 午前問題 問3
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問4
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問5
- 解説
- 令和元年度 基本情報技術者試験 午前問題 問6
- 解説
### 令和元年度 基本情報技術者試験 午前問題 問3\~問6
#### 令和元年度 基本情報技術者試験 午前問題 問3
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問3](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
ノードとノードの間のエッジの有無を隣接行列を用いて表す。ある無向グラフの隣接行列が次の場合、グラフで表現したものはどれか。ここでノードを隣接行列の行と列に対応させて、ノード間にエッジが存在する場合は1で、エッジが存在しない場合は0で表す。
$$\\begin{array}{c|cccccc}{}&a&b&c&d&e&f\\cr\\hline a&0&1&0&0&0&0\\cr b&1&0&1&1&0&0\\cr c&0&1&0&1&1&0\\cr d&0&1&1&0&0&0\\cr e&0&0&1&0&0&1\\cr f&0&0&0&0&1&0\\end{array}$$
| ア |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| イ |  |
| ウ |  |
| エ |  |
#### 解説
無向グラフの問題です、行列(行列の書き方悩んで、表にしちゃいましたが、本物の試験では行列表記です)で接続されているエッジは1で表されています。
接続の状況を1になっているところだけ抜き出してみてみます。
(↓)行列(→) =>( a-b ), ( b-a ), ( b-c ), ( b-d ), ( c-b ), ( c-d ), ( c-e ), ( d-b ), ( d-c ), ( e-c ), ( e-f ), ( f-e )
下線のものは、a-b, b-aのように両側から書いているもの、今回は無向グラフなのでどっちかがわかってれば解ける!
\=>( a-b ), ( b-c ), ( b-d ), ( c-d ), ( c-e ), ( e-f )
の接続がされているものを選べばよい。
解答群は(c-e)、(b-d)の接続はすべて共通なので、a-fの横並びの切れ目を見ていくと、a-b-c-d e-fとなっているものは、ウが正解
#### 令和元年度 基本情報技術者試験 午前問題 問4
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問4](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
$a$ 及び $b$を定数とする関数 $f(t)=\\frac{a}{t+1}$ 及び $g(t)=\\frac{b}{t^2-t}$ に対して $\\lim\_{t \\to \\infty} \\frac{g(t)}{f(t)}$はどれか?
ここで$a\\neq0, b\\neq0, t>0$とする。
| ア | 0 |
| - | -------------- |
| イ | 1 |
| ウ | $\\frac{a}{b}$ |
| エ | ∞ |
#### 解説
がっつり数学の問題ですが、簡単な極限の求め方がわかっていればさほど難しくありません。
まず数式を、組み立ててみます。
$f(t)=\\frac{a}{t+1}$、 $g(t)=\\frac{b}{t^2-t}$
なので、
$\\lim\_{t \\to \\infty} \\frac{g(t)}{f(t)}= \\lim\_{t \\to \\infty} \\frac{b}{t^2-t}/\\frac{a}{t+1}$
ここで、頑張って変形(式の整理)していきます。
$\\lim\_{t \\to \\infty} \\frac{b}{t^2-t}\\div\\frac{a}{t+1}=\\lim\_{t \\to \\infty}\\frac{b}{t^2-t}\\cdot\\frac{t+1}{a}$ ← 割り算を逆数の掛け算に直します
$=\\lim\_{t \\to \\infty}\\frac{b(t+1)}{a(t^2-t)}$ ← 約分します。
$=\\lim\_{t \\to \\infty}\\frac{b}{a}\\cdot\\frac{(t+1)}{(t^2-t)}=\\lim\_{t \\to \\infty}\\frac{b}{a}\\cdot\\frac{\\frac{1}{t}+\\frac{1}{t^2}}{1-\\frac{1}{t}}$ ← 一番次数の大きい項で割っていきます
これで極限を考えると
$t \\to \\infty$の時、$\\frac{1}{t}, \\frac{1}{t^2} \\to 0$
$\\frac{b}{a}\\cdot\\frac{0 + 0}{1-0} \\to 0$
アが正解
#### 令和元年度 基本情報技術者試験 午前問題 問5
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問5](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
平均が60、標準偏差が10の正規分布を表すグラフはどれか。
| ア |  | イ |  |
| - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- | - | ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
| ウ |  | エ |  |
#### 解説
数学の確率統計の分野の問題です。今回どうしちゃったんでしょうね?(笑)
正規分布(ガウス分布)は、以下の数式で表されます。
\\\[ f(x)=\\dfrac{1}{\\sqrt{2\\pi}\\sigma}\\exp\\left(-\\dfrac{(x-\\mu)2}{2\\sigma2}\\right) \\\]
平均が$\\mu$で分散が$\\sigma^2$です。
グラフにすると、以下のようになります。
*図:正規分布*
よって、その性質を表しているグラフは、平均と分散の関係を正しく表している「ア」ということになります。
ちなみに、pythonとmatplotlibで書いたものは以下のようになります。
*図:pythonとmatplotlibで書いたやつ*
#### 令和元年度 基本情報技術者試験 午前問題 問6
> 出典:[令和元年度 秋期 基本情報技術者試験 午前 問6](https://www.ipa.go.jp/shiken/mondai-kaiotu/gmcbt8000000dict-att/2019r01a%5Ffe%5Fam%5Fqs.pdf?ref=geekjp.com)
Random(n)は0以上n未満の整数を一様な確率で返す関数である。整数型の変数A,B及びCに対して次の一連の手続きを実行したとき、Cの値が0になる確率はどれか?
| A=Random(10) |
| ------------ |
| B=Random(10) |
| C=A-B |
| ア | 1/100 |
| - | ----- |
| イ | 1/20 |
| ウ | 1/10 |
| エ | 1/5 |
#### 解説
数学の確率の問題です。
Aが0~9の乱数を発生して、Bが0~9の乱数を発生させるとき、AとBが同じ値になる確率を求めなさい。
という問題に置き換えられます。
さいころ2つふって同じ目になる確率の計算と一緒ですね。
1回目0が出る確率は1/10、2回目も0が出る確率は1/10となります。
そのパターンが、0\~9まで10種類あるので、
1/10×1/10×10=1/10
「ウ」が答え。
---
## シリーズ内の記事
- 前の記事:[問1~問2の解説](https://www.geekjp.com/2019-10-30-113249/)
- 一覧:[令和元年度秋期 基本情報技術者試験 テクノロジ系まとめ](https://www.geekjp.com/2019-11-18-144908/)
- 次の記事:[問7~問10の解説](https://www.geekjp.com/2019-10-31-014254/)
内容の誤りや分かりにくい箇所は、[お問い合わせページ](https://www.geekjp.com/contact/)からお知らせください。
### 【コーヒー部】ニトリのコーヒーミル買ってみた!
URL: https://www.geekjp.com/2019-10-30-025737/
Last updated: 2019-10-29T17:57:37.000Z
## ふわもこドリップしたくてニトリのコーヒーミル買ってみた
- [ふわもこドリップしたくてニトリのコーヒーミル買ってみた](#ふわもこドリップしたくてニトリのコーヒーミル買ってみた)
- [ニトリのコーヒーミル](#ニトリのコーヒーミル)
- [中身拝見](#中身拝見)
- [使用感](#使用感)
- [所感](#所感)
### ニトリのコーヒーミル
ニトリのコーヒーミルCC-0202を買ってみました。この子を選んだ理由は、何しろ安い!1000円切ってました。
ウス部分は、カリタやメリタのものとは違って金属製ではなく、セラミックです。
金属は、回しているうちに熱を持ってしまって云々らしいですが、セラミックはどうなんでしょうね?
- 主なスペック
- サイズ:約98×98×160mm、約460g
- 材質:本体…木、金具…鉄(メッキ)、ミル部・ミル受け…セラミック
- 挽きたての美味しさが楽しめる手挽きコーヒーミル。
- 調整ネジを調整することで細挽き・粗挽きができます。
- 原産国:中国
[](https://images-na.ssl-images-amazon.com/images/I/51J5SrVKMXL.jpg?ref=geekjp.com)
便利な引出し!
便利な引出しって書いてますが、引き出しがないと、すった豆が取り出せません(笑)
[](https://images-na.ssl-images-amazon.com/images/I/51kV0vO9zpL.jpg?ref=geekjp.com)
ミル部分拡大図
そして、同じものがAmazonでも買えますが、ニトリで買ったほうがとても安いのは内緒ですw
### 中身拝見
外箱はこんな感じです。
図:外箱(表)

図:外箱(裏)
中から出すと、レバーと本体と、注意書きと説明書が入っています。
ちょいと組み立てなければいけません。
図:中身一覧
**このとき注意してほしいのが、豆のひき具合の調整です。説明書を見てもさっぱりと意味が分かりませんw**
図:ひき具合の調整法1
図:引き具合の調整法2
中挽きは11メモリだから、2週ぐらいまわしとけばいいかな。。。
図:組み立て終了
とりあえず、組み立て終了しましたので、実際に使ってみます。
### 使用感
それでは実際にひいてみます!
図:実際挽いてミル
はい、しっぱーいwwwww
これはムラがあるし粗すぎです。
もう一度調整しなおして。。。
図:今度は成功!
今度はうまく言ったっぽいです。結構調整がシビアなようです。
回す感じは、ほかの高級なみるとちがって、本体が劇的に軽いので回しているときの安定感がないので、ガタガタするしたまに倒しそうになっちゃいます。
ただ、セラミック製のせいか案外軽い力で回すことができるのはいいところかもしれないです。
あと、この手のミル全般なんですが、すり終わってからトレイを引き出したときに、豆がぱーってとびます。静電気とか、仕組み的にとかどうしようもないのですが、敷物はしいて使ったほうがいいです。
### 所感
ニトリの激安コーヒーミル買ってみました。というネタでしたが、実際使ってみて感想としては、とても満足でした。
ちゃんと調節すれば、粒も結構そろったそれなりのクオリティの粉になります。
ドリップもしてみましたが、いい具合に豆も膨らんでよい香りのコーヒーがいただけました。
図:ふっくら豆とおいしいコーヒー
ただ、エスプレッソやマキネッタで使うのはちょっと無理があるので、その時はデロンギとかのコーン型やカッター式の粒ぞろいのよい電動のものをお勧めします。
| |
| ------------------------------- |
| DeLonghi コーン式 コーヒーグラインダー KG364J |
じじい程度が、ドリップで個人的に楽しむには、結構いい商品だと思います。
私的には、以下のような評価です。
実用性:★★★★☆
デザイン:★★☆☆☆
クオリティ:★★★☆☆
コスパ:★★★★☆
満足度:★★★★☆
へだば、まだねー
### 【python】第1回 チキチキ プログラミング初心者のための型に関する考察 ~pythonで基数変換できるかな?~【学習】
URL: https://www.geekjp.com/2019-10-28-135618-2/
Last updated: 2026-07-31T16:22:50.000Z
# 【python】第1回 チキチキ プログラミング初心者のための型に関する考察 ~pythonで基数変換できるかな?~【学習】
- 第1回 チキチキ プログラミング初心者のための型に関する考察 ~pythonで基数変換できるかな?~
- はじめに
- 型って?
- C言語の主な型
- C言語の演算にかかわる型の扱われ方
- ちょっと型の中身をのぞいてみる
- 2進数の数値表現
- 10進数と2進数の変換
- 2進数と10進数の変換
- 2進数と整数型
- pythonと整数型
- 所感
### はじめに
こんな記事を見たんですよ。
[Sum of three cubes for 42 finally solved – using real life planetary computer](https://www.bristol.ac.uk/news/2019/september/sum-of-three-cubes-.html?ref=geekjp.com)
要は、(x3+y3+z^3=n) となる (n)(1~100の自然数)((x, y, z))の組を求める問題です。
33と42以外のほとんどの整数については、解かれているか、解がないことが証明されていました。
今年に入って、33の解がスパコンで解かれて、最近42の解が50万台のコンピュータをネットワークで接続し、アイドル時間を借りて計算を行う方式の分散コンピューティングで解かれました。([SETI](https://ja.wikipedia.org/wiki/SETI@home?ref=geekjp.com)プロジェクトみたいなもんかな?)
分散コンピューティングにより、今までの探索範囲よりも桁の範囲を広げて計算することができたのが勝因のようです。
ちなみに、答えは。。。
$$ (-80538738812075974^3 + 80435758145817515^3 + 12602123297335631^3 = 42) $$
となります。
ちょっと確認してみますね。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/576a09ca64ff6741e5e0a1957ec9984b?ref=geekjp.com)
ほんとだw
それで思ったんですよ。pythonって、こんなでかい値計算できるわけで、んでpythonって、いわゆる型推論してるけど、整数の大きさってどこまで使えるの?
### 型って?
むかしながらの、FORTRAN, pascal, Cなどのプログラミング言語には、確実に型ってのが存在しています。
簡単には、データを入れるための箱の形式=コンピュータがデータの形式を判断し、正確に処理を行うための仕組みなのかなと思います。
#### C言語の主な型
C言語の例を見ると(一部処理系依存の部分がありますので、悪しからず)
| 型名 | 種類 | サイズ | 範囲 | 備考 |
| ------ | -- | ----- | -------------------------------------------- | -------------- |
| int | 整数 | 4byte | \-2147483648 〜 2147483647 | 負数は2の補数表現 |
| short | 整数 | 2byte | \-32768 〜 32767 | 負数は2の補数表現 |
| char | 整数 | 1byte | \-128\~127 | 負数は2の補数表現 |
| float | 実数 | 4byte | 1.17549e-38 〜 3.40282e+38(±10-38 〜 1038) | IEEE754浮動小数点形式 |
| double | 実数 | 8byte | 2.22507e-308 〜 1.79769e+308(±10-308 〜 10308) | IEEE754浮動小数点形式 |
つまり、型はそのデータがメモリ上でどう表現されているか、ということになります。
#### C言語の演算にかかわる型の扱われ方
C言語では変数を使うときは型同士のやり取りに細心の注意を払ってソースを書かなければなりません。
例えば、
```
#include
int main(void){
// Your code here!
int x=3;
int y=5;
printf("%lf", x/y);
}
```
出力は 「0.0000」 になります。
C言語では、整数を整数で割った余りは整数で返ってきます。
また、char型(8bit:-128\~127)の整数をカウントアップしていき(そもそも127以上カウントアップできないのでintの変数を作ってそれをchar型に代入します)、どのように値が変化するか観察する処理を書いてみます。
```
#include
int main(void){
// Your code here!
char c = 0;
int i;
for(i=0;i<300;i++)
{
c = i;
printf("%04d ", c);
if(i%25 == 0)printf("\n");
}
}
```
実際の出力は、
```
0000
0001 0002 0003 0004 0005 0006 0007 0008 0009 0010 0011 0012 0013 0014 0015 0016 0017 0018 0019 0020 0021 0022 0023 0024 0025
0026 0027 0028 0029 0030 0031 0032 0033 0034 0035 0036 0037 0038 0039 0040 0041 0042 0043 0044 0045 0046 0047 0048 0049 0050
0051 0052 0053 0054 0055 0056 0057 0058 0059 0060 0061 0062 0063 0064 0065 0066 0067 0068 0069 0070 0071 0072 0073 0074 0075
0076 0077 0078 0079 0080 0081 0082 0083 0084 0085 0086 0087 0088 0089 0090 0091 0092 0093 0094 0095 0096 0097 0098 0099 0100
0101 0102 0103 0104 0105 0106 0107 0108 0109 0110 0111 0112 0113 0114 0115 0116 0117 0118 0119 0120 0121 0122 0123 0124 0125
0126 0127 -128 -127 -126 -125 -124 -123 -122 -121 -120 -119 -118 -117 -116 -115 -114 -113 -112 -111 -110 -109 -108 -107 -106
-105 -104 -103 -102 -101 -100 -099 -098 -097 -096 -095 -094 -093 -092 -091 -090 -089 -088 -087 -086 -085 -084 -083 -082 -081
-080 -079 -078 -077 -076 -075 -074 -073 -072 -071 -070 -069 -068 -067 -066 -065 -064 -063 -062 -061 -060 -059 -058 -057 -056
-055 -054 -053 -052 -051 -050 -049 -048 -047 -046 -045 -044 -043 -042 -041 -040 -039 -038 -037 -036 -035 -034 -033 -032 -031
-030 -029 -028 -027 -026 -025 -024 -023 -022 -021 -020 -019 -018 -017 -016 -015 -014 -013 -012 -011 -010 -009 -008 -007 -006
-005 -004 -003 -002 -001 0000 0001 0002 0003 0004 0005 0006 0007 0008 0009 0010 0011 0012 0013 0014 0015 0016 0017 0018 0019
0020 0021 0022 0023 0024 0025 0026 0027 0028 0029 0030 0031 0032 0033 0034 0035 0036 0037 0038 0039 0040 0041 0042 0043
```
となります。
char型の変数の範囲は-128\~127までですので、127までは順調にカウントアップしています。
127の次は、-128,-127,...と負の数が登場して1ずつ増えてゆき-2,-1の後、0,1,2,3とカウントアップになっています。
C言語は声高らかに、自分の使うデータ型を宣言して、プログラマの理解の範疇で適切な処理を施していくプログラミング言語ですので、別の型同士の演算などはC言語で決められているルールをプログラム製作者が正確に理解していないと、データ表現の違いによるバグを引き起こしてしまいます。
pythonなどの言語は、その辺はシステムの方が推定して適切な型を内部で使ってくれるのでこのようなことは起こりにくい?と思われます。
### ちょっと型の中身をのぞいてみる
ちょっと細かい話になるのですが、**基本情報処理技術者試験**や**応用情報処理技術者試験**のテクノロジ系でよく出てくる話ですので、知ってるといいことあるかもしれないよ。
型のある言語C/C++, JAVA, C#等では大体同じような型が使われており、中身も共通する部分が多いです。
一番簡単な整数型に関して、考えてみます。
よく言われるように、コンピュータの内部データはすべて、0と1でできています。(皆さんの書いたソースコード自体も内部では0と1で表される命令群に変換されます)
0と1は、電気的にはONかOFFの信号を表しています。電気的にONかOFFかの羅列でプログラムやデータを読んだり書いたり、加工していったりするんですね。
よく考えてみると面白くないですか?
図:メモリ内のイメージ
#### 2進数の数値表現
前にも書いたのですが、pythonでは、細かいことをやらない限りプログラム製作者はこんなこと気にすることはないのかもしれませんが、知っているとバグの原因の特定が早かったり、ほかの言語への対応が簡単になるかもです。(まぁ、私自身がpython初心者なんですが。。。)
それではさっそく。
整数型は、「プログラム上の処理で扱う変数の入れ物として、整数を表すもの」です。大きさが決まった整数を入れる箱だと思うといいかも。
内部では2進数で値を表します。
2進数は、いわゆるコンピュータの中で使われているとされる0と1しかない値の表現です。10進数は0,1,2。。。8,9で10、11と10ごとに桁が上がっていきます。
ちなみに、このように、\*\*桁が上がるベースとなっている数を「基数(radix)」\*\*といいます。
2進数は、
| 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | … |
| - | - | -- | -- | --- | --- | --- | --- | ---- | - |
| 0 | 1 | 10 | 11 | 100 | 101 | 110 | 111 | 1000 | … |
と、2進数だと2ごとに桁が上がっていきます。
何とか進数(n進数)には、2進数以外にも、4進数、5進数・・・と無限に進数があります。
コンピュータの世界では、2,8,16進数を覚えておけば間違いないです。
10進数と1~9進数までの数字の並びの対応表を以下に示しておきます。
| 10進数 | 2進数 | 3進数 | 4進数 | 5進数 | 6進数 | 7進数 | 8進数 | 9進数 |
| ---- | ---- | --- | --- | --- | --- | --- | --- | --- |
| 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 | 0 |
| 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 | 1 |
| 2 | 10 | 2 | 2 | 2 | 2 | 2 | 2 | 2 |
| 3 | 11 | 10 | 3 | 3 | 3 | 3 | 3 | 3 |
| 4 | 100 | 11 | 10 | 4 | 4 | 4 | 4 | 4 |
| 5 | 101 | 12 | 11 | 10 | 5 | 5 | 5 | 5 |
| 6 | 110 | 20 | 12 | 11 | 10 | 6 | 6 | 6 |
| 7 | 111 | 21 | 13 | 12 | 11 | 10 | 7 | 7 |
| 8 | 1000 | 22 | 20 | 13 | 12 | 11 | 10 | 8 |
| 9 | 1001 | 100 | 21 | 14 | 13 | 12 | 11 | 10 |
| 10 | 1010 | 101 | 22 | 20 | 14 | 13 | 12 | 11 |
| 11 | 1011 | 102 | 23 | 21 | 15 | 14 | 13 | 12 |
| 12 | 1100 | 110 | 30 | 22 | 20 | 15 | 14 | 13 |
| 13 | 1101 | 111 | 31 | 23 | 21 | 16 | 15 | 14 |
| 14 | 1110 | 112 | 32 | 24 | 22 | 20 | 16 | 15 |
| 15 | 1111 | 120 | 33 | 30 | 23 | 21 | 17 | 16 |
この表を見てわかる通り、n進数には0~(n-1)の数字しかでてきません。
だから2進数は、0と1なんですね。
#### 10進数と2進数の変換
10進数をn進数に変換するときは、以下の図のように目的の数をnで割っていき、余りを並べるとn進数に変換できます。
図:10進数からn進数への変換
実際に、10進数の13を2進数に変換してみます。
図:10進数から2進数への変換
10進数の13は2進数では1101であることがわかりました。
ほかの進数でも同じようにできます。10進数の24を5進数に変換します。
図:5進数への変換
10進数の14は5進数では24であることがわかりました。
#### 2進数と10進数の変換
2進数を10進数に戻すときのイメージを考えるために、10進数を基数をベースに分解してみます。
\\(1978 =1000+900+70+8 = 1\\times10^3+9\\times10^2+7\\times10^1+8\\times10^0 \\\\ここで (n^0=1)\\) \\(\\begin{array}{l|l|l|l|l} 基数 & 10^3 & 10^2 & 10^1 & 10^0 \\\\ \\hline 値 & 1 & 9 & 7 & 8 & \\\\ \\end{array}\\)
桁の仕組みってこうなってたんですね、n桁目=基数のn乗桁目になっていて、すべての桁の基数の重みxその桁の数をかけて足したものが、元の数値になる(よくわからない説明w)
多分2進数で同じことをやってみるとすぐわかります。
2進数は、基数2なので桁の重みは(20,21,22,…,2n)と増えていきます。(2進のときは桁のことをビット(bit)と呼びます、知ってますよね?)
2進数の1011で考えてみると
\\(\\begin{array}{l|l|l|l|l} 基数 & 2^3 & 2^2 & 2^1 & 2^0 \\\\ \\hline 値 & 1 & 0 & 1 & 1 & \\\\ \\end{array}\\) \\(1\\times2^3+0\\times2^2+1\\times2^1+1\\times2^0 = 1\\times8+0\\times4+1\\times2+1\\times1 = 8+2+1=11\\)
2進数の1011は10進数では11です(1と0しかない数字選んじゃって分かりづらくなってしまったw)
どんな基数の時もこのルールは一緒です。
8進数の765を10進数に変換してみます。
\\(\\begin{array}{l|l|l|l} 基数 & 8^2 & 8^1 & 8^0 \\\\ \\hline 値 & 7 & 6 & 5 \\\\ \\end{array}\\) \\(7\\times8^2+6\\times8^1+5\\times8^0 = 7\\times64+6\\times8+5\\times1 = 448+48+5=501\\)
これで、n進数⇔10進数の変換ができるようになりましたね!
### 2進数と整数型
整数型は、コンピュータの内部形式では2進数で表すことはわかりました。現実世界ではほとんどのものが10進数で表されていますので、普段は2進数やほかのn進数について考えることもないと思います。
実際プログラミングをしていても、pythonを使っている分にはそんなに気にならないのかなと思います。
(でも、実質C言語と絡むと、ちゃんと理解してるしかないし、基本情報では基礎事項として入ってるし。。。)
コンピュータの回路には、一度にデータをやり取りできる数が決まっています。
図:昔のCPU
CPUの裏側を見ると細かい足がたくさん生えています、このうちの何本かがデータをやり取りする配線になっています。
CPUの何ビットCPUというのは一度にメモリとのやり取りをするのに使えるビット数のことです。(正確にはレジスタの幅かな?)
大体、データや命令が2進数で表されることもあって、8の倍数(乗数)で増えていきます。
一度にやり取りできる命令やデータのビット数が決められているということは、先ほどの計算のようにただ10進数を2進数に変換したものを使うと、ビット数が足りなくなったり、余ったりと、いろいろ不都合が出てきます。8ビットしか使えないのに2ビットだけ使ってるとか、8ビットしか使えないのに、データが15ビットとか、多くても、少なくてもめんどくさいことになりそうですよね。
そこで型の登場なのですが、もう一度型とデータサイズ(ビット幅)の関係を見てみます。
| 型名 | 種類 | サイズ |
| ------ | -- | ----- |
| int | 整数 | 4byte |
| short | 整数 | 2byte |
| char | 整数 | 1byte |
| float | 実数 | 4byte |
| double | 実数 | 8byte |
一番小さいchar型で1byte=8bitですね。
このときに、1ってデータはどのように入っているのでしょうか?箱が8ビットでできているんで、当然1のみってことはあり得ません。
正解は、
\\(\\begin{array}{l|l|l|l|l|l|l|l|l|l} ビット & 7 & 6 & 5 & 4 & 3& 2& 1 & 0\\\\ \\hline 値 & 0 & 0 & 0 & 0 &0 & 0 &0 & 1 \\\\ \\end{array}\\)
00000001でした。箱の何も入っていないところは0で埋めます。
それでは、すべて1で埋まった数はいくつでしょうか?
\\(\\begin{array}{l|l|l|l|l|l|l|l|l|l} ビット & 7 & 6 & 5 & 4 & 3& 2& 1 & 0\\\\ \\hline 値 & 1 & 1 & 1 & 1 & 1 & 1 & 1 & 1 \\\\ \\end{array}\\)
8ビットの整数では0~255の範囲があらわされることがわかりました。
さて、この11111111に1足しちゃったらどうなるでしょう?
数学的には、
(11111111+00000001=100000000)
です。9ビットの100000000になりますね。でも、今用意している箱は8ビットしかありません。
\\(\\begin{array}{l|l|l|l|l|l|l|l|l|ll} ビット & \[\] & 7 & 6 & 5 & 4 & 3& 2& 1 & 0\\\\ \\hline 値 & 1 & 0 & 0 & 0 & 0 &0 & 0 &0 & 0 \\\\ \\end{array}\\)
型のある言語では、この場合、あふれた1ビットは捨てられます。
結果残った00000000が答えとなります。なので、11111111+1は0です(笑)
この現象を\*\*桁あふれ(Overflow:オーバーフロー)\*\*と呼びます。
聞いたことはありますよね。
#### pythonと整数型
さて、pythonの話に戻りますが、pythonでは整数型は多倍長型と呼ばれる記録できるメモリ量が許す限りの大きさが使える整数型を採用してます。つまり、C言語のintやchar型とちがって、型としてビット長がきまっていないのでオーバーフローが起こらない仕様ということになります(それが計算速度が速いかどうかは別)
なので、冒頭のような、-8京とかいう数値の計算をさせても何事もなく計算できるんですね。おもしろいw
### 所感
Sum of three cubes 問題を発端に、pythonの整数の扱いについて、いろいろ考えてみました。
今回は正の整数についてのみ考えましたが、次回は負の数や小数についても考えてみたいと思います。
気づく人は気づいたと思いますが、途中に出てきた表の整数範囲と、今回導き出した範囲は異なっています。この違いについても次回には触れようと思います。
へば、またねー!
### 初心者がpythonでソートアルゴリズム実装して時間計測してみた
URL: https://www.geekjp.com/2019-10-25-022314/
Last updated: 2026-08-01T12:58:50.000Z
# 初心者がpythonでソートアルゴリズム実装して時間計測してみた
- 初心者がpythonでソートアルゴリズム実装して時間計測してみた
- pythonの時間計測
- 時間計測の方法
- 時間計測用のスクリプト
- ソートアルゴリズムの計測
- 結果
- 所感
### pythonの時間計測
ソートアルゴリズムをいくつか実装したので、その計算時間の違いを見るために計算時間を計測してみました。
学生時代を思い出します(笑)
昔のプログラミング言語に比べてコンピュータの時間に対する分解能も上がってますし、計測が簡単になってる気がしました。
数値計算の課題でいくら計測しても計算時間0sで出力されて、担当の先生に文句言いに行ったのを思い出します。
結局先生が資料を作った時よりも、使用していたWSの計算能力がかなり上がっていて、課題程度の処理ではすぐ終わってしまい、もっと細かい命令を使わないと時間が図れないという落ちでした(笑)
今回は、これまで実装した、
- 選択ソート
- バブルソート
- シェーカーソート
- 挿入ソート
- シェルソート
のデータ数を変化させたときの処理時間を測ってみたいと思います。
### 時間計測の方法
[https://docs.python.org/ja/3/library/time.html](https://docs.python.org/ja/3/library/time.html?ref=geekjp.com)
によると、時間計測のための関数はいくつかあるらしいです。
んで、
| time.get\_clock\_info(**name**) |
| ------------------------------- |
で、その情報が得られると、ほうほう。
**name**に入るのは、
> 'clock': time.clock()
> 'monotonic': time.monotonic()
> 'perf\_counter': time.perf\_counter()
> 'process\_time': time.process\_time()
> 'thread\_time': time.thread\_time()
> 'time': time.time()
とりあえず表示してみればいっかw
```python
print(time.get_clock_info('clock'))
print(time.get_clock_info('monotonic'))
print(time.get_clock_info('perf_counter'))
print(time.get_clock_info('process_time'))
print(time.get_clock_info('thread_time'))
print(time.get_clock_info('time'))
```
実行、っと。
```python
DeprecationWarning: time.clock has been deprecated in Python 3.3 and will be removed from Python 3.8: use time.perf_counter or time.process_time instead
print(time.get_clock_info('clock'))
namespace(adjustable=False, implementation='QueryPerformanceCounter()', monotonic=True, resolution=1e-07)
namespace(adjustable=False, implementation='GetTickCount64()', monotonic=True, resolution=0.015625)
namespace(adjustable=False, implementation='QueryPerformanceCounter()', monotonic=True, resolution=1e-07)
namespace(adjustable=False, implementation='GetProcessTimes()', monotonic=True, resolution=1e-07)
namespace(adjustable=False, implementation='GetThreadTimes()', monotonic=True, resolution=1e-07)
namespace(adjustable=True, implementation='GetSystemTimeAsFileTime()', monotonic=False, resolution=0.015625)
```
なんかいっぺーでてきたw
ドキュメントに戻ると、
> adjustable: 自動 (NTP デーモンによるなど) またはシステム管理者による手動で変更できる場合は True、それ以外の場合は False になります。
> implementation: クロック値を取得するために内部で使用している C 関数の名前です。 使える値については Clock ID Constants を参照してください。
> monotonic: クロック値が後戻りすることがない場合 True が、そうでない場合は False になります。
> resolution: クロックの分解能を秒 (float) で表します。
なるほど、resolutionの値を比べてみると
| 関数名 | 分解能 | 備考 |
| -------------------- | ------------------- | ------------------------------------------------ |
| time.clock() | resolution=1e-07 | python3.8から削除? |
| time.monotonic() | resolution=0.015625 | モノトニッククロックの値 (小数点以下がミリ秒) を返します |
| time.perf\_counter() | resolution=1e-07 | パフォーマンスカウンターの値 (float) を返す短時間を正確に計測スリープも計測 |
| time.process\_time() | resolution=1e-07 | CPU 時間の合計値 (小数点以下はミリ秒) を返すスリープは含まない |
| time.thread\_time() | resolution=1e-07 | 現在のスレッドのシステムおよびユーザーの CPU 時間の合計値 (小数点以下ありの秒数) を返す |
| time.time() | resolution=0.015625 | エポック秒(UNIX時間)を返す |
つまり、**time.perf\_counter()** または、**time\_process\_time()** を使うのがよさそうですね。
って、ところまで読んだところで、ちゃんと検証している方発見(´;ω;`)
20ms以上の精度を求めるなら「time.perf\_counter()」,それ以下で良いなら「time.process\_time()」
ってことで、計測は**time.perf\_counter()**を使います。
### 時間計測用のスクリプト
時間計測の関数を調べていると。。。
> 一方、time() および sleep() は Unix の同等の関数よりましな精度を持っています。
[time --- 時刻データへのアクセスと変換 — Python 3.8.0 ドキュメント](https://docs.python.org/ja/3/library/time.html?ref=geekjp.com#time.monotonic)
じゃぁ、高精度で測ってみよう!w
```python
import time
import sys
mtime = 0.0
for i in range(10):
start = time.perf_counter()
time.sleep(10.0)
end = time.perf_counter()
mtime += end - start
print(end - start)
mtime = mtime/10.0
print(mtime)
```
10秒を10回計測してみます。
| 1 | 10.000415 |
| -- | ------------------ |
| 2 | 9.999896600000001 |
| 3 | 10.000802 |
| 4 | 9.999936600000002 |
| 5 | 10.000314600000003 |
| 6 | 10.000423999999995 |
| 7 | 10.006602 |
| 8 | 10.000490799999994 |
| 9 | 9.999910200000002 |
| 10 | 10.000438899999992 |
| 平均 | 10.000923069999999 |
うん。いいのか悪いのか、Sleep()の誤差もあるしねw
### ソートアルゴリズムの計測
各ソート処理の計算時間を計測するスクリプトを書いていきます。
```python3
def sort_sammary(f, datalist, file):
pd = copy.deepcopy(datalist)
ttime = 0.0
i = 0
while i < 10:
p = copy.deepcopy(pd)
starttime = time.perf_counter()
s = f(p)
endtime = time.perf_counter()
interval = endtime - starttime
ttime += interval
i = i + 1
print(interval)
ttime = ttime/10.0
file.write(str(s[0])+","+str(s[1])+","+str(ttime)+"\n")
# ソートを10回実行して、実行時間の平均値を出す
```
ここで、
| f | ソートを行う関数(計測される処理) |
| -------- | ----------------- |
| datalist | ソートされるデータ |
| file | 結果記録用のファイル |
です。
```python
def bakasort(datalist):
change = 0
comp = 0
for x in range(0, len(datalist)):
tmp = x
for y in range(x, len(datalist)):
comp += 1
if datalist[tmp] >= datalist[y]:
tmp = y
change += 1
datalist[x], datalist[tmp] = datalist[tmp], datalist[x]
return comp, change
# 単純選択ソートの実装
file = open('test2.txt', 'w')
#valには、ソートされるデータが入っている
file.write('selection sort\n')
sort_sammary(bakasort,vals, file)
file.close()
```
こんな感じで書くと、計測できるはずですね。
```
selection sort
500500,6336,0.06867423000000002
shell sort
2693,2693,0.012094429999999979
bubble sort
499500,249107,0.12809839
shaker sort
273034,214243,0.09548444999999997
```
データは、左から比較回数、交換(代入)回数、処理時間、のつもりです。
### 結果
それぞれのソートでデータ数を増やしながら時間計測をしてみます。
表:各ソートアルゴリズムの処理時間
図:データ数別の各ソートアルゴリズムの処理時間推移
大体、最悪計算量がO(n^2)のアルゴリズムなので、それに従って計算時間が伸びているのがわかります。
シェルソートのみ最悪O(nlog2n)、最良O(n)、平均O(n^1.25)なので、なぞの安定感を見せていますw
### 所感
今回は、学生時代を思いだして、ソートアルゴリズムの処理時間を計測して比べてみました。
こうしてみると、シェーカーソートとバブルソートのグラフはほぼ重なっており、あまり改良されてるとは言えない結果となりました。
(アルゴリズムなんか間違ってるかもしれないので、後で見直してみないと。。。)
最後に今回のソースコードをすべて載せておきます。
なにか突っ込みどころがあれば、コメントお願いします。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/e2b4e3d286a98eceb7a6611f40c180a4?ref=geekjp.com)
### 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【シェーカーソート】
URL: https://www.geekjp.com/2019-10-24-015714/
Last updated: 2026-08-01T13:20:29.000Z
#
- 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【シェーカーソート】
- シェーカーソート
- アルゴリズム
- 所感
### シェーカーソート
シェーカーソートはバブルソートの改良版です。
バブルソートは、並びが良い場合(交換が少なくて済む場合)はソートが早いという特徴があります。
ということは、最悪のケースを考えてみたときに、逆側からバブルソートを行うと早くソートが終わるってことになります。
最悪のケースの逆は最高のケースででしょう、という前提でバブルソートを往復で行うことにより、交換回数を減らそうというものです。
実際比較はほぼすべてに対して行うので、アニメーションの処理回数的には変わらないですが、交換という部分で見ると処理は早くなっているはずです。
### アルゴリズム
バブルソートを往復で行うだけですので、特に工夫もなく直感的に実装できます。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/46c3f96452437a32dc63964fe11962fa?ref=geekjp.com)
まんまですね。
### 所感
実装は当然のように簡単なアルゴリズムだけれども、効果はそれなりにあるかなぁと思いました。
アニメーションではわからないですが、交換回数は減ってるはずです。
### 【コーヒー部】ニトリのドリップカップ(1000円ちょい)買ってみた!
URL: https://www.geekjp.com/2019-10-23-235605/
Last updated: 2019-10-23T14:56:05.000Z
## ふわもこドリップしたくてドリップカップ(1000円ちょい)買ってみた
### ドリッパーによるドリップコーヒー
私は、コーヒーを飲むときは、豆をすって、ドリッパーにセットして、香りを楽しみながらドリップして、できたものをまったり飲む、のが好きです。
ドリッパーは、いくつか持っていますが、今手元にあるのは
#### HARIOの円錐型ドリッパー
| |
| ---------------------------------------------------------- |
| HARIO (ハリオ) V60 01 透過 コーヒードリッパー クリア コーヒードリップ 1\~2杯用 VD-01T |
#### メリタの1つ穴ドリッパー
| |
| ------------------------------------------------------ |
| メリタ コーヒードリッパー 陶器フィルター 2\~4杯用 オフホワイト メジャースプーン付 SF-T 1×2 |
をメインで使っています。
HARIOのドリップケトルを使って、ドリップを楽しんでいたのですが、いろいろあって今ドリップケトルが使えずにこまっていました。
んで、買っちゃおうかなぁって思ってた時に、ニトリでいいもん見つけたんですよ。
#### ニトリのドリップカップ
[](https://www.nitori-net.jp/ecstatic/image/product/8944233/894423306.jpg?ts=20190725162650854&ref=geekjp.com)
です。
沸騰したお湯入れて、ちょっと90℃くらいまで冷ましてから入れるのにちょうどいい!
んでもって、一人分だけ入れることが多いので、ケトルよりも量を測りやすくていい!
んで、見た目かわいくていい!
ドリップ上手な人は、割と口が広い、このタイプがいいらしいですが[\*1](#f-1f5246bc)、
| |
| ------------------------------- |
| カリタ Kalita コーヒー ドリップポット シルバー 1L |
私は、調節下手なので、細口の方が一定で屋根を崩さず入れることができました。
しかも、この手のドリップカップですが、コーヒー関係の専門店とかで買うと、3~4000円ぐらいしたりします。
高いものになると。。。
| |
| ------------------------------ |
| ボンマック ドリップポットPro 750ml #897183 |
買えるかーい!
んでも、ニトリのものはなんと
1,195円(税別)( 1,314円(税込))です。Amazon探すともっと安いものがありますが、送料とかいろいろ考えるとお得かな。
後、シルバーの色遣いが結構気に入ってます!
素敵なシルバーのボディ
岩手県一関市のチャフさんの豆+HARIOの円錐型ドリッパー+ニトリのドリップカップで入れてみました。
### 実際使ってみたよ
お湯が、だばだば出るわけではなく、コーヒー豆に当たるときも優しく注がれるので、山が崩れずにふわっとお湯を注げます。
香りがいい(^^♪
へだば、まだねー!
[\*1](#fn-1f5246bc):youtubeとかで達人ぽい人はみんなこのタイプです
### 【python】python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 後半【入門】
URL: https://www.geekjp.com/2019-10-21-151034/
Last updated: 2026-07-31T16:06:37.000Z
# 【python】python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 前半【入門】
- [python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 前半](#python3%E3%81%A8pycharm%E3%81%A8pygame%E3%81%A7%E3%83%86%E3%83%88%E3%83%AA%E3%82%B9%E9%A2%A8%E3%82%B2%E3%83%BC%E3%83%A0%E4%BD%9C%E3%81%A3%E3%81%A6%E3%81%BF%E3%81%9F%E7%AC%AC%EF%BC%92%E5%9B%9E%E5%89%8D%E5%8D%8A)
- [今回の内容](#%E4%BB%8A%E5%9B%9E%E3%81%AE%E5%86%85%E5%AE%B9)
- [今回のスクリプト](#%E4%BB%8A%E5%9B%9E%E3%81%AE%E3%82%B9%E3%82%AF%E3%83%AA%E3%83%97%E3%83%88)
- [結果](#%E7%B5%90%E6%9E%9C)
### 今回の内容
初心者ですが、生意気にもゲームプログラミングにチャレンジしようと思います。
今回は、テトリス風ゲームに挑戦してみました。
第2回目は
1. セル画像の切り出し(スプライトシート)
2. 各色のセル画像配列の作成
3. キーイベントの取得と色画像の表示
4. セルの切り出しと表示
までやってみました。
まだ、色のついた正方形が出るだけです。
いったい、いつテトリスになるのだろうか。。。
### 今回のスクリプト
今回のスクリプトを置いときます。
何かお気づきの点ありましたら、コメントでお知らせください。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/faea2969d8d1a66afa72e89682e20bf1?ref=geekjp.com)
### 結果
今回やったところまで、動画にまとめました。
[https://youtu.be/8QuRkZfh6O4](https://youtu.be/8QuRkZfh6O4?ref=geekjp.com)
良かったら、チャンネル登録お願いします。
### 【python】python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 前半【入門】
URL: https://www.geekjp.com/2019-10-21-020144/
Last updated: 2026-07-31T16:05:16.000Z
# 【python】python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 後半【入門】
- [python3とpycharmとpygameでテトリス風ゲーム作ってみた 第2回 後半](#python3%E3%81%A8pycharm%E3%81%A8pygame%E3%81%A7%E3%83%86%E3%83%88%E3%83%AA%E3%82%B9%E9%A2%A8%E3%82%B2%E3%83%BC%E3%83%A0%E4%BD%9C%E3%81%A3%E3%81%A6%E3%81%BF%E3%81%9F%E7%AC%AC%EF%BC%92%E5%9B%9E%E5%BE%8C%E5%8D%8A)
- [今回の内容](#%E4%BB%8A%E5%9B%9E%E3%81%AE%E5%86%85%E5%AE%B9)
- [今回のスクリプト](#%E4%BB%8A%E5%9B%9E%E3%81%AE%E3%82%B9%E3%82%AF%E3%83%AA%E3%83%97%E3%83%88)
- [結果](#%E7%B5%90%E6%9E%9C)
### 今回の内容
初心者ですが、生意気にもゲームプログラミングにチャレンジしようと思います。
今回は、テトリス風ゲームに挑戦してみました。
第2回目は
1. セル画像の切り出し(スプライトシート)
2. 各色のセル画像配列の作成
3. キーイベントの取得と色画像の表示
4. セルの切り出しと表示
後半では、ピースの画像を画面に描画するところまで実装しました。
次は、ピースを動かしてみたいなとおもってます。
までやってみました。
まだ、色のついた正方形が出るだけです。
いったい、いつテトリスになるのだろうか。。。
### 今回のスクリプト
今回のスクリプトを置いときます。
何かお気づきの点ありましたら、コメントでお知らせください。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/198d667363a33d54f00c0c3f91f7d947?ref=geekjp.com)
### 結果
今回やったところまで、動画にまとめました。
[初心者がpythonとpygameでテトリス風ゲームを作ってみた #02 後半](https://youtube.com/watch?v=J4ckfS2eHPA&ref=geekjp.com)
へばまたね!
良かったら、チャンネル登録お願いします。
### 【python】python3とpycharmとpygameでテトリス風ゲーム作ってみた 第1回【入門】
URL: https://www.geekjp.com/2019-10-18-054204/
Last updated: 2026-07-31T16:03:28.000Z
- python3とpycharmとpygameでテトリス風ゲーム作ってみた
- 今回の内容
- 今回のスクリプト
- 結果
### 今回の内容
初心者ですが、生意気にもゲームプログラミングにチャレンジしようと思います。
今回は、テトリス風ゲームに挑戦してみました。
今回は一回目なので、
1. プロジェクトの作成
2. 画像の生成
3. 画像の読み込み
4. 画像の切り出しと表示
までやってみました。
### 今回のスクリプト
今回のスクリプトを置いときます。
何かお気づきの点ありましたら、コメントでお知らせください。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/89952ce98cb0089f0b3545c26ca846fe?ref=geekjp.com)
```
import pygame
from pygame.locals import *
import sys
import random
import copy
window_size = 640, 480 # 画面サイズの指定
def main():
pygame.init() # pygameの初期化(おまじない)
screen = pygame.display.set_mode(window_size) # pygameの画面サイズを設定
pygame.display.set_caption("Ahoris") # タイトルバーに表示されるゲームタイトル(どうでもいいやつ)
image = pygame.image.load("./tile.png") # 画像の読み込み
cropimage = pygame.Surface((20, 20))
cropimage.blit(image, (0, 0), (0, 0, 40, 40))
pygame.transform.scale(cropimage, (20, 20))
while True: # 画面やイベントの更新処理
for event in pygame.event.get(): # イベントを取得
if event.type == QUIT: # ×ボタンや、終了イベントが発生した時の処理
pygame.quit() # これを書いていないと、冷害やエラーで終了する
sys.exit()
screen.blit(cropimage, (0, 0, 20, 20)) # screenへの画像の貼り付け
# imageは読み込んだ画像, カッコ内は画像の貼り付け座標, 画像幅, 画像高さを指定
# (画像, (画像の左上.x, 画像の左上.y, 画像幅, 高さ)
pygame.display.update() # 画面の更新処理(設定したFPSで更新される)
if __name__ == "__main__":
main()
```
今回のソースコード
### 結果
今回やったところまで、動画にまとめました。
[初心者がpythonとpygameでテトリス風ゲームを作ってみた #01](https://youtube.com/watch?v=8FfxHyYBgLI&ref=geekjp.com)
(NEW) 今回使った画像です。良かったらどうぞ
画像:tile.png
良かったら、チャンネル登録お願いします。
### 【コーヒー部】Brooksが今熱い!かも
URL: https://www.geekjp.com/2019-10-16-171804/
Last updated: 2019-10-16T08:18:04.000Z
- [Brooksが今熱い(かも)](#Brooksが今熱いかも)
- [Brooksと僕](#Brooksと僕)
- [Brooksの価格帯](#Brooksの価格帯)
- [お友達紹介キャンペーン](#お友達紹介キャンペーン)
### Brooksと僕
いろんなコーヒー探し歩いてさ迷っていた、20年位前、ネットである通販サイトに出会いました。
そう。【Brooks】です。
若干、毎回豆を擂って、ハンドドリップして。。。が面倒になってた私にとっては、衝撃でした。
[](https://images-na.ssl-images-amazon.com/images/I/5198YnFR5LL.%5FAC%5F.jpg?ref=geekjp.com)
ドリップバッグ
これです。当時は、1杯分だけ豆が入っているドリップバッグなんて代物はほとんど出回っておらず、しかもお試しで3000円で200袋+αでおまけがついてきた気が。。。
(でも200袋あると途中で飽きちゃって、実家の床屋さんにに半分あげてました)
### Brooksの価格帯
現在はコーヒー豆の価格の高騰や、物価の上昇などもあり、以前よりはもうちょっと高くなっていますが、相変わらずお得感はあります。
例えば、以下の商品
| |
| ----------------------------------------------------------------------------------------------------------------------------------- |
| ブルックス 10gコーヒーお試しセット 52袋 10銘柄 ドリップバッグコーヒー ドリップコーヒー コーヒー ドリップパック 珈琲 BROOK'S BROOKS モカ ヨーロピアン ロイヤル お試し新品価格¥2,580から(2019/10/16 17:00時点) |
ですが、brooksのコーヒーは大体1杯10グラムが基本的な分量になっています。
このセットはい90袋ですので
10(g)×52(袋)=520(g)
2580(円)÷520(g)= 約5(円/g)
私がいつも行くお気に入りの某店のキリマンジャロブレンドは、
100(g)あたり700円
700(円)÷100(g)=7(円/g)
で、結構お得です。(計算した割によくわからない比較になってしまった。。。)
しかも、Amazon経由ではなく、[ブルックスの公式に登録して](https://www.brooks.co.jp/first/otameshi.php?ref=geekjp.com)購入すると、もうちょっと安いです。
しかもいまなら!
### お友達紹介キャンペーン
[https://www.brooks.co.jp/friend/](https://www.brooks.co.jp/friend/?ref=geekjp.com)
お友達紹介キャンペーンやってます。
[](https://www.brooks.co.jp/friend/images/friend%5Fnew%5F1809%5F33.png?ref=geekjp.com)
メール、line、Facebook、Twitterで**まだブルックスを利用したことないお友達**に登録してもらうと、
紹介した側: モカ15袋プレゼント
紹介された側: 1980円で52袋のお試しセット購入すると、おまけの人気セットがもらえる
紹介された側が実際に購入しないともらえませんが、かなりお得なキャンペーンだと思いませんか?
私はもう登録してるので紹介する側しかできません(笑)
↑こちらの食物繊維たっぷり健康志向コーヒー:カフェサプリもおすすめです。
へば、まだねー
### 【コーヒー部】岩手の自家焙煎珈琲豆が買えるお店【穴場?】
URL: https://www.geekjp.com/2019-10-15-213924/
Last updated: 2019-10-15T12:39:24.000Z
## 自家焙煎珈琲豆が買えるお店 岩手編
岩手でも、結構な数の自家焙煎珈琲豆販売店があります。結構なお店を回ってますが、それぞれ良いところがあって順番はつけられません。
そんな中で、いくつかのお店をピックアップして独断と偏見で紹介してみます。
スターバックス、ドトール、タリーズ、カルディ等の大手チェーン店などは今回は紹介しません。
気になるお店があったら、ぜひ行ってみて、感想をコメントしてほしいです。
### 盛岡周辺
盛岡は昔住んでいたので、結構な数のお店を回りました。
一覧にすると以下のような感じです。|
| 店名 | 住所 | 営業時間 | 定休日 | |
| ----------------------------------------------------------------------------------------------------------------------------- | ------------------------------------------------------------------------------------------------------------------------------- | ----------------- | -------------------------------- | |
| [(有)キャメル珈琲店](https://www.camel-coffee.jp/?ref=geekjp.com) | [岩手県盛岡市加賀野4丁目13−28](https://goo.gl/maps/72uxG7qbwqr2yH4h7?ref=geekjp.com) | 10 : 30 ~18 : 30 | 日・祝日 | |
| [(有)キャメル珈琲店梨木店](https://www.camel-coffee.jp/?ref=geekjp.com)[\*1](#f-384ef8bf "キャメルコーヒーの店舗") | [岩手県盛岡市梨木町5-47 ジュネス梨木1F](https://goo.gl/maps/N42qgC5W3HPaG7rd7?ref=geekjp.com) | 9:00~18:30 | 土・日 祝祭日 | |
| [クラムボン](https://ja-jp.facebook.com/pages/%E3%82%AF%E3%83%A9%E3%83%A0%E3%83%9C%E3%83%B3/158409250839451?ref=geekjp.com)(Webなし) | [ 岩手県盛岡市紺屋町5−33](https://ja-jp.facebook.com/pages/%E3%82%AF%E3%83%A9%E3%83%A0%E3%83%9C%E3%83%B3/158409250839451?ref=geekjp.com) | 10 : 00 ~ 19 : 00 | 水・日 | |
| [機屋(はたや)](https://hatayacoffee.com/information/shop.html?ref=geekjp.com) | [岩手県盛岡市本町通3丁目2-11 ](https://goo.gl/maps/QhNe31uAA66JrDVF8?ref=geekjp.com) | 10:30~19:30 | 月(祝日の場合火曜日休)・第1火曜 | |
| [機屋demi](https://hatayacoffee.com/information/demi.html?ref=geekjp.com)[\*2](#f-1a8be0a5 "機屋の支店です") | [岩手県盛岡市菜園1丁目8-15 カワトクcubeⅡ1F](https://hatayacoffee.com/information/demi.html?ref=geekjp.com) | 10:00~19:00 | 年中無休 | |
| [自家焙煎珈琲 六月の鹿](http://6gatsunoshika.blog109.fc2.com/?ref=geekjp.com) | [岩手県盛岡市内丸5−5](https://goo.gl/maps/nQu4sq9J4ouYC6Jr9?ref=geekjp.com) | 7:30 - 16:00 | 日・月[\*3](#f-f73995ba "たまに日曜も営業") | |
| [Nagasawa Coffe](http://www.nagasawa-coffee.net/?ref=geekjp.com) | [岩手県盛岡市上田1丁目11-23](http://www.nagasawa-coffee.net/?ref=geekjp.com) | 11:00\~20:00 | 木曜 | |
| [fulalafu](https://fulalafu.sakura.ne.jp/fulalafu/?ref=geekjp.com) | [岩手県盛岡市鉈屋町15-8](https://fulalafu.sakura.ne.jp/fulalafu/?ref=geekjp.com) | 10:00~19:00 | 水曜 | |
この中でよくお世話になっていたのは、キャメルコーヒーと、クラムボンさんです。
キャメルコーヒーさんは、誰にでも出せる、癖がなくすっきりした味わいのコーヒー豆な気がします。
(たまに変わり種売ってるので、つい買っちゃう)
クラムボンさんのは、マスターこだわりの焙煎で、苦みが強く、風味の高いコーヒーが特徴だと思います。
### 所感
盛岡で、お世話になった&気になっている自家焙煎珈琲豆が買えるお店をリストアップしてみました。
ちなみに、私はほとんどの場合豆のまま買ってきて自分で吸ってハンドドリップかマキネッタでコーヒーを楽しんでいます。
コーヒーミルは以前はカリタの
| |
| -------------------------------- |
| カリタ Kalita コーヒーミル 手挽き KH-5#42039 |
手回しのミルを使ってました。見た目がレトロ感あり、形が可愛くてお気に入りだったのですが、だんだん横着癖が出てきて、電動に手を出してしまいました。
次に使ったのが、メリタの電動のミルです。
| |
| ----------------------------------------- |
| Melitta(メリタ) 【電動コーヒーミル】 パーフェクトタッチII CG-5B |
これも、安価な割に耐久性もありよかったのですが、粉が飛び散るようになってきたのと、マキネッタを使い始めると、もう少し細かくて粒のそろった引き上りが欲しくて、最終的には。。。
デロンギのコーヒーグラインダー買っちゃいました。
まずは、入門編ということでエントリーモデル買いましたが、音も静かで上品、引きあがりも粒がそろっていて非常に気に入っています。
コスパ高いモデルだと思いますので、ぜひ使ってみてください!
私は、実家と職場と自宅に3台持ってます(笑)
へだばまだねー
[\*1](#fn-384ef8bf):キャメルコーヒーの店舗
[\*2](#fn-1a8be0a5):機屋の支店です
[\*3](#fn-f73995ba):たまに日曜も営業
### 【雑談】薬屋さんが作った、あのスーパーモデルも愛飲する、発酵食品で、花粉症にも効く、2秒に1本売れている、ノニジュースについて調べてみた
URL: https://www.geekjp.com/2019-10-14-161036/
Last updated: 2019-10-14T07:10:36.000Z
#### ノニジュースについてちょっと色々調べてみた
### ノニジュースって?
タイトル通り、結構テレビやネットで見るノニジュースですが、実際どんなもんなのか気になって調べてみました。
結構罰ゲームで出てくることが多い印象です。きっと最近青汁がいわゆる、「あー、まずい、もう一杯」ではなく、結構おいしくなっちゃ多野で、次のまずい?健康飲料として注目されていそうな感じ。
| モリンダ MORINDA タヒチアンノニジュース 1000ml\[4本セット\]新品価格¥19,900から(2019/10/14 14:20時点) | オーガニックノニジュース タヒチ産 直輸入 醗酵ノニ100%原液 1000ml 有機JAS認定新品価格¥3,240から(2019/10/14 14:21時点) |
| ------------------------------------------------------------------------- | ------------------------------------------------------------------------------- |
とりあえず、Amazonで調べてみました。
そんなに入手しづらいものでもないみたいですね。
> ノニとは、からだに良いものとして、ジュースの形で販売されていることが多いようです。ノニは、インディアン・マルベリー、ヤエヤマアオキ、モリンダなどとも呼ばれています。太平洋諸島、東南アジア、オーストラリア、およびインドにある常緑樹で、溶岩流地形に多く生息します。昔から、赤や黄色の洋服の染色に利用されてきました。ノニは、カリウムなどの多くの成分を含んでいます。
> 日本医師会Webより :
>
> [https://www.med.or.jp/people/knkshoku/noni.html](https://www.med.or.jp/people/knkshoku/noni.html?ref=geekjp.com)
>
商品としては、[モリンダ](http://www.nonifamily.co.jp/?ref=geekjp.com)のものがメジャーみたいですね。
### 原料
ノニジュースの原料は、きっと「ノニ」なんじゃね?って思いましたが、調べてみます。
お手軽にwikipediaっと。。。
| [](https://upload.wikimedia.org/wikipedia/commons/6/6f/Noni%5Ffruit%5Fdev.jpg?ref=geekjp.com) |
| ---------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------- |
> ヤエヤマアオキ(八重山青木 学名:Morinda citrifolia)は、アカネ科ヤエヤマアオキ属の常緑小高木。学名のMorindaは、ラテン語の「morus」(クワ)と、「indus」(インド)との2語からなるが、果実の形状に由来する。citrifoliaは「citrus」(シトロン)と「folius」(葉)とからなり、柑橘に似た葉を有する意味である。和名に「アオキ」とあるがアオキはミズキ目ミズキ科で遠縁である。ハワイの現地語であるノニ(noni)が、ノニジュース等を販売する業者が「健康食品」と称して宣伝していることもあり、良く知られる名称の1つになっている。
植生は、東南アジア~オセアニアで、学名はモリンダシトリフォリア(Morinda citrifolia)というらしいです。
日本でも沖縄に自生しているそうです。
画像見て、何かに似てるなぁ。。。。ってずっと思ってたら。
子供のころに見た、みんなのトラウマ
[X(旧Twitter)の投稿を見る](https://twitter.com/yokaikarte/status/1043486485918375936?ref%5Fsrc=twsrc%5Etfw&ref=geekjp.com)
水木しげる先生の、「妖怪百目」そのものじゃん(笑)
しかも、熟すにつれて黄色く変色してゆき、強烈な発酵臭を放つそうです。
そのため、食用としては、相当飢饉の時のみしか用いられなかったという記録があります。
### 健康効果
健康食品として、日本に上陸したノニジュースですが、実際のところの効果はどうなんでしょうか?
これも調べてみます。
最近は、ノニの葉を使ったお茶などもあるみたいですが、今回はノニジュースに限って調べてみます。
実やそれを搾ったジュースの成分はいろいろなところの情報を総合すると、
| 成分 | 効用 |
| ------------------------ | -------------------- |
| ゼロニン | 体内酵素活性化・自然治癒力向上 |
| 多糖類 | 免疫力向上・殺菌・抗癌作用 |
| スコポラミン | 降圧作用(血管拡張)・抗ヒスタミン・鎮痛 |
| ビタミンC、マグネシウム、 鉄、亜鉛、ナトリウム | (省略) |
後は、青汁などもそうですが、葉っぱ類には多くの場合多量のカリウムが含まれています。
ただ、ほかの健康食品やサプリメントに関してもカリウムに関しては成分表示にかかれないことが多いそうです。
#### ゼロニン
プロゼロニン・プロゼロネーゼが体内で変化して、ゼロニンになるらしいです。体内で痛んだ細胞を正常化し、より活発にする体にとって必要不可欠な成分です。ゼロニンは常に体内で不足していて、常に補給する必要があるとされるそうです。[\*1](#f-bf00af14)
#### 多糖類
いわゆる炭水化物で、エネルギーになるものです。体にいい悪いではなく、エネルギーなので体には必要でしょう。
#### スコポレチン
もう名前だけで面白いですが、ノニの有効成分の中で最も効果が高そうなものらしいです。
もともと、ノニから抽出された成分で、血圧降下作用、抗菌作用、鎮痛作用、うつ症・睡眠障害の改善(セロトニンの合成に関与するといわれているため)の効果がある。
関連論文:
[https://www.jstage.jst.go.jp/article/bunsekikagaku/65/6/65\_301/\_pdf](https://www.jstage.jst.go.jp/article/bunsekikagaku/65/6/65%5F301/%5Fpdf?ref=geekjp.com)
#### その他
ビタミン・ミネラル類もたくさん入っているらしいです。まぁ、これは果実なら大体そうじゃないかな?
前述しましたが、カリウムには気を付けてください。医学的エビデンスが得られた、ノニの含有するカリウム起因とされる健康被害が何件か報告されています。
主に肝機能障害のようです。
[https://www.med.or.jp/people/knkshoku/noni.html](https://www.med.or.jp/people/knkshoku/noni.html?ref=geekjp.com)
### 味・風味
健康に良さそうな成分が入っていそうなのはわかりました。
でも、よく、テレビやYoutubeなどで罰ゲームに使われるのはどうしてでしょうか?
笑っていいともでは、ココリコ田中いわく、「どぶの味だ!」
ほか、Webを検索しても、まずい、渋井、酸っぱい、口当たり悪い、と散々です。
実際に罰ゲームで使われている動画を紹介します。
[https://youtu.be/oiYQaYSOXsE](https://youtu.be/oiYQaYSOXsE?ref=geekjp.com)
Fischer's:【話題】激まずいと噂のノニジュース4番勝負が白熱した!!
[https://youtu.be/6FOE4DVL5QM](https://youtu.be/6FOE4DVL5QM?ref=geekjp.com)
東海オンエア:【疑惑】テレビの飲み物系の罰ゲームって実際どうなの?
ものによるみたいですが、ほかのジュースとミックスして飲みやすくしてあるものが多いみたいなので、罰ゲームで使うときはピュア原液エキスみたいなやつを選ぶといいと思います(笑)
### 所感
あのスーパーモデルも飲んでいて、健康にいいけど、おいしくないと噂の、ノニジュースについて調べてみました。
罰ゲーム慣れしているYoutuber達も、モノによっては悶絶してたので、買ったもの次第ではやばそうですね(笑)
皆さんも一本どうですか?
| |
| ---------------- |
| タヒチアンノニジュース (1L) |
へだば、まだね!
[\*1](#fn-bf00af14):科学的には、存在が証明されておらず、成分の含有量なども測定不可能なため、信じるか信じないかはあなた次第です
### 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【シェルソート】
URL: https://www.geekjp.com/2019-10-13-182338/
Last updated: 2026-08-01T16:16:58.000Z
#
- 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【シェルソート】
- シェルソート
- アルゴリズム
- 結果
- 所感
### シェルソート
前回に引き続いて調子に乗って別のソートアルゴリズムも試してみました。
まぁありがちですが。。。
あちこち見れば書いてますが、シェルソートは挿入ソートを改良したものです。
挿入ソートは、整列済みに近いデータ列に対しては、割と早い特徴があります。
最悪に近いケース
[https://youtu.be/jSbfxJ5lqcs](https://youtu.be/jSbfxJ5lqcs?ref=geekjp.com)
最善に近いケース
[https://youtu.be/8YHwsRLdueI](https://youtu.be/8YHwsRLdueI?ref=geekjp.com)
原理を考えれば、そりゃそうですが、かなり違いますね。
なので、この最善に近いケースにデータを近づけながら挿入ソートしたら早くなるんじゃね?
って言うのが、シェルソートの基本的なアイデアです。
### アルゴリズム
データをある刻み幅hでグループ分けします。
例えば、
| v = \[ 3, 7, 1, 4, 10, 2, 8, 9, 5, 6 \] |
| --------------------------------------- |
を h=4 で分割すると、
| v1 = \[ 3, 10, 5 \] |
| ------------------- |
| v2 = \[ 7, 2, 6 \] |
| v3 = \[ 1, 8 \] |
| v4 = \[ 4, 9 \] |
のグループに分けられます。
これをそれぞれ、ソートして元の順番でつなぎ合わせます。
①ソート
| v1 = \[ 3, 5, 10 \] |
| ------------------- |
| v2 = \[ 2, 6, 7 \] |
| v3 = \[ 1, 8 \] |
| v4 = \[ 4, 9 \] |
②繋ぎなおし
| v = \[ 3, 2, 1, 4, 5, 6, 8, 9, 10, 7\] |
| -------------------------------------- |
なんとなく、昇順に近い並びで並んでいるのがわかります。
次は、刻み幅を h = 2 として同じことを行うと、もう少し完全な昇順に近づきます。
最後に、通常の挿入ソートを行う。という手順です。
python的には、以下のように書いてみました。
(初心者ですので、効率は悪いと思います。)
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/5cc40a345edd5dbefebf537cafc32dc7?ref=geekjp.com)
### 結果
データの比較、並び替えの処理のみ記録してゆき、アニメーションにしてみました。
初めはランダムだったデータがだんだん昇順に近づいていくのがわかると思います。
[https://youtu.be/4LnMiNi9ZRQ](https://youtu.be/4LnMiNi9ZRQ?ref=geekjp.com)
最後は、気持ちいい速さで整列されますね。
### 所感
シェルソートを実装して可視化してみました。
可視化の部分は、汚すぎてお見せできないので、後回しに(-\_-;)
Shellソートの名前の由来は、Donald L. Shellが、1959年に発表したアルゴリズムであることに由来しているそうです。
アルゴリズムやソートについて、なにか突っ込みやコメントありましたら、気軽にお願いします。
さて、次は何やってみようかな?
へだば、まだね!
### 【コーヒー部】よろしい ならば珈琲だ
URL: https://www.geekjp.com/2019-10-10-180507/
Last updated: 2026-07-20T17:19:50.000Z
## 諸君、私はコーヒーが好きだ
- [諸君、私はコーヒーが好きだ](#諸君私はコーヒーが好きだ)
- [序章](#序章)
- [コーヒーのグローバリズム ~コーヒーってなんだ?~](#コーヒーのグローバリズムコーヒーってなんだ)
- [俺のコーヒー](#俺のコーヒー)
- [ドリッパー](#ドリッパー)
- [ドリッパー(金属メッシュフィルター)](#ドリッパー金属メッシュフィルター)
- [フレンチプレス](#フレンチプレス)
- [サイフォン](#サイフォン)
- [マキネッタ](#マキネッタ)
- [所感](#所感)
### 序章
コーヒーっておいしいですよね。最近は、コンビニでもおいしいコーヒーが安価で販売されるようになり、いつでもどこに行ってもある程度のクオリティのコーヒーを飲むことができるっていい時代ですね!
私が、コーヒーが好きになったのはもはや三十数年も前。。。
実家の周りでは、当時はコーヒーといえばインスタントコーヒーが、当たり前でした。
当時主流だった非チェーン系の喫茶店でコーヒーを飲んでも特に何も思わず飲んでいました。
子供のころから全く勉強せず、試験の前の日のみ気合で勉強し好成績をとるのが趣味だった、私は、もっぱら、寝ないため、つまり、カフェイン摂取のためだけにコーヒーを飲んでいました。
珈琲に飽きたら、緑茶、それも飽きたら紅茶、それも飽きたら薬局でエスタロンモカ錠をと、無限カフェインループに陥っていました。
なので、コーヒーにも、お茶類にも砂糖は加えず、すべてストレートでぶち込んでいました。(今でもそうですが)
そんな調子だったので、初めのころはコーヒーが好きっていうよりは、コーヒーを飲む習慣がついたって感じでした。
これはきっと、同じような人も多いと思います。
そして、高校、大学、大学院へと進み、コーヒーを飲みながら作業ができる機会が増えて、だんだんおいしい、
おいしくない、を意識し、好みというものが出てきました。
それで、そのころ遂にある疑問にたどり着いてしまいました。
**・・・コーヒーって、なんだ?**
### コーヒーのグローバリズム ~コーヒーってなんだ?~
単純な疑問でした。そのころ思っていたのは、
コーヒーの味の違い = 豆の違い
って事でした。つまり、私の中では、
- 自宅のコーヒーメーカーに勝ってきた豆をぶち込んで出てくる液体
- ドトールなどのコーヒーショップで注文すると出てくるもの
- 喫茶店でマスターがなんかかんやして(笑)作る液体
が、コーヒーで、その違いは豆にあるのだと思っていました。
ところが、大学生の時インターネット技術が一気に広がり、個人でも情報発信できる時代が来ると、
コーヒーに関する様々な情報が手に入るようになりました。
また、現地に行かなくても、様々なショップのコーヒー豆がネットショップ経由で購入できるようになりました。
私の中で、起こった現象
**コーヒーのグローバル化**
そう、専門家しか知りえなかったコーヒーに関する技術や知識が一般人でも入手できるようになり、コーヒーへの距離がぐっと近くなりました。
コーヒーを淹れるための器具や、豆、知識やコツも、おいしいコーヒーを淹れるために研究してる人の解説も、いろいろ学べるようになってしましました。
もう、自分的に産業革命でしたw
### 俺のコーヒー
ネットや、あちこち歩きまわって情報収集し、自分なりにおいしいコーヒーを淹れるために様々なことを試してみました。
まずは、様々な器具を試してみました。
#### ドリッパー
ドリッパーも様々なものを使ってみました。
まずは代表的なもの、
| カリタ(kalita) | メリタ(melitta) |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ | ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| 日本企業 | ドイツ企業 |
| 1つ穴 | 3つ穴 |
| [](https://images-na.ssl-images-amazon.com/images/I/719-9dmTWGL.%5FAC%5FSL1500%5F.jpg?ref=geekjp.com) | [](https://images-na.ssl-images-amazon.com/images/I/517N5jHEKfL.%5FAC%5FSL1500%5F.jpg?ref=geekjp.com) |
| カリタ Kalita コーヒー ドリッパー 磁器製 波佐見焼 2\~4人用 HASAMI & Kalita HA102 #02010 | メリタ コーヒードリッパー 陶器フィルター 2\~4杯用 オフホワイト メジャースプーン付 SF-T 1×2 |
どちらも、メジャーよく見ると思います。
カリタの方は、一つ穴で、慣れないとよく詰まらせて、えぐい味のコーヒーが出来上がります。
メリタの方は、3つ穴なので、通りがよいのですが、慣れないと豆のひき具合によってうっすいコーヒーが出来上がります。
どちらがいいとは言い切れないですが、道具の違いって寄りは淹れる方の腕前次第な気がします。
またどちらもペーパーフィルタを使います。フィルタは、台形型ならカリタ、メリタ純正のものでなくとも大体合います。
**ドリッパー(ペーパーフィルタ)**
- メリット
- メジャーで入手しやすい
- 淹れ方も簡単
- 雑味などもよく取り除く
- デメリット
- ペーパーが消耗品
- 入れる人の技量に味が左右される
- オイルが取り除かれる
#### ドリッパー(金属メッシュフィルター)
次に使ったものは、金属メッシュのフィルターです。
| HARIO 金属メッシュフィルター |
| ------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------------ |
| [](https://images-na.ssl-images-amazon.com/images/I/81S8U0rMvIL.%5FAC%5FSL1500%5F.jpg?ref=geekjp.com) |
| HARIO (ハリオ) ドリッパー |
特徴としては、穴あの代わりに金属メッシュが取り付けられており、ペーパーフィルタがなくても使えるます。
また、紙のフィルターを通さないので、コーヒー豆から出るオイル成分を取り除かないというのも大きいです。
紙フィルタは、コーヒーのうまみ成分の一つとされるコーヒーオイルを吸収してしまい、香りととろみと旨味が落ちてしまうといわれています。
**ドリッパー(金属メッシュフィルタ)**
- メリット
- ペーパーいらず
- 淹れ方もペーパドリップとほぼ一緒で比較的簡単
- コーヒーのうまみ成分を逃さない
- デメリット
- 豆のひき方が難しい(へたくそだと粉っぽくなります)
- 後片付けが人によっては。。。
- 味の好みが分かれやすい
#### フレンチプレス
おいしいコーヒーを求めて次に使ってみたのが、フレンチプレスです。
昔使っていた、コーヒー豆の通販ショップのメールマガジンでおすすめされていたので使ってみたのがきっかけでした。
| ボダム フレンチプレス |
| ----------------------------------------------------- |
| 【正規品】 BODUM ボダム KENYA フレンチプレスコーヒーメーカー 0.35L 10682-01J |
|
メリットデメリットは以下の通りです。
**フレンチプレスコーヒー**
- メリット
- ペーパーいらず
- 淹れ方が決まっておりだれが作っても均質
- コーヒーのうまみ成分を逃さない
- デメリット
- 豆のひき方が難しい(へたくそだと粉っぽくなります)
- 後片付けがしんどすぎる。。。
- 味の好みが分かれやすい
ここだけの話、僕の好みには合いませんでした。
買って数か月で、ペーパードリップに戻ってしまいました。
ちなみに、これは豆知識なのですが、スタバで注文するときに「フレンチプレスで!」っていうと、フレンチプレスで渡されます。(アイスもホットも可)
#### サイフォン
とある古い喫茶店に立ち寄った時、ご年配の蝶ネクタイのマスターが、懐かしくて面白いものを見せてくれました。
サイフォンで入れるコーヒーです。昔の喫茶店は結構サイフォンが多かった気がします。
見た目も面白く、理系にはたまらない原理でコーヒーを抽出します。
[https://youtu.be/XGqvfdrj2VA](https://youtu.be/XGqvfdrj2VA?ref=geekjp.com)
**サイフォン**
- メリット
- 何しろ見た目がサイコー
- ペーパーいらず(ネルフィルタは消耗品)
- 淹れ方がわかれば失敗はほぼない
- フィルタが紙じゃないのでうまみ成分を逃さない
- デメリット
- フィルタのセットがむずい(へたくそだと粉っぽくなります)
- 後片付けが人によっては。。。
- 使うものが多すぎて、壊れやすい
#### マキネッタ
| ビアレッティ マキネッタ |
| --------------------- |
| Bialetti Moka Express |
最近は、これにはまっています。
直火式エスプレッソマシンとか言われたりもしています。
原理的にはサイフォンとあまり変わりませんが、もっと圧力を高めて一気に抽出します。
サイフォンでは、上に上がったコーヒーがフィルターを通って下に降りてきてフラスコにたまったものをいただきます。
対して、マキネッタでは、コーヒー豆が中層にセットされており、水が上層に上がる過程でコーヒーが抽出されます。
wikipediaのアニメがわかりやすいです。
[](https://upload.wikimedia.org/wikipedia/commons/d/dd/Moka%5FAnimation.gif?ref=geekjp.com)
抽出時の音と香りは、ほんと癖になります。
イタリアでは、これで入れたコーヒーはモカコーヒーとか呼ばれていて、エスプレッソではないとかいう人もいます。
でも、
[https://images-na.ssl-images-amazon.com/images/I/C12IQeMyHmS.mp4](https://images-na.ssl-images-amazon.com/images/I/C12IQeMyHmS.mp4?ref=geekjp.com)
Amazonのビアレッティのページを見ると思いっきりエスプレッソって書いているので、僕はエスプレッソだと思っています。
香りが高く、砂糖を多めにして、ちびちび飲むのがおいしいです。
**マキネッタ**
- メリット
- エスプレッソというスペシャリティ
- ペーパーいらず(ゴムパッキンは消耗品、丸ろ紙も使えるよ)
- 淹れ方がわかれば失敗はほぼない
- 作るのに時間がかからない
- 片付けも簡単!
- デメリット
- 粉のひき方にコツがある
- エスプレッソ自体が好みが分かれる
- 1回の抽出量が少ない
### 所感
私の今までのコーヒー遍歴を勝手に語りました。
現在のおすすめは、断然マキネッタです。
ブラックで飲むのはお勧めしませんが、仕事で疲れた時などに少し甘めで楽しんだり、カプチーノなどもおいしく簡単に作れます。
伝統的なものは、アルミ製ですが最近はステンレス製のものも出ていますので、HIでも使用できるものもあります。
ただ、IHの仕組み的にマキネッタの底の半径が小さすぎると、モノによっては検知されず温められません。
そんな時は、プレートかませばいいです。
| |
| ------------------------------------------------------------------------- |
| Frabosk (フラボスク) モカポット用IHヒーティングプレート直径12cm【エスプレッソメーカー用、IH・ガスコンロ両用】 099.00.3 |
それでは、皆さん、よいコーヒーライフを!
へだばまだねー。
[\*1](#fn-fa405408):だったかな?正式名称は定かではないです
### 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【バブルソート】【インサーションソート】
URL: https://www.geekjp.com/2019-10-10-015348/
Last updated: 2026-08-01T14:23:00.000Z
- 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【バブルソート】【インサーションソート】
- バブルソート
- 結果
- インサーションソート
- 結果
- 所感
### バブルソート
前回に引き続いて調子に乗って別のソートアルゴリズムも試してみました。
まぁありがちですが。。。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/2471b1cdafa29743cf74c963a00b893b?ref=geekjp.com)
バブルソートは隣り合う要素の値を比較して条件に応じた交換をしてゆき。
最大値(または最小値)を逐次右端(または左端)に寄せていくことによりソートを実現します。
大きい順(または小さい順に)順次値が泡のように浮いていくのでバブルソートと呼ばれます。
詳しいことは、ググるとたくさん載ってるのでこの辺でw
効率については、悪いほうのアルゴリズムです。
とりあえず、pythonだと実装めっちゃ簡単でびっくりしました。
(まぁ、速度はC/C++の方が早いんだろうけど)
何がって、値の交換が
| a, b = b, a |
| ----------- |
で書けるってのがでかいですね。
バブルソートやインサーションソートのようにインデックスベースで入れ替えが起こる処理では、楽できるね。
### 結果
前回同様、入れ替えの操作をリストに記録して、後で再生してます。
### インサーションソート
注目要素の値を、順次適切な位置に挿入することによって、整列を行うアルゴリズムです。
処理が簡単なので、バブルソートのように隣接する要素と比べて値を交換していきますが、適切な挿入位置に値が収まると次のループに移行します。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/a1c82bdd2a52541a19602ee99a58a7e1?ref=geekjp.com)
### 結果
動画を見ると、バブルソートとインサーションソートの違いが判ると思います。
### 所感
交換していく系のソート2つを実装してみました。
リストの操作や、繰り返しでミスったりいろいろありましたが、pythonの練習にはちょうど良かったかな?
そして、pygameが使いづらい。。。
enchant.jsで遊んでた時はとても楽だったのに笑
くじけずもうちょい遊んでみようかなって思います。
へだば、また!
### 初心者がpython3とpygameでソートアルゴリズムを可視化してみる【単純選択ソート】
URL: https://www.geekjp.com/2019-10-09-032551/
Last updated: 2026-08-01T16:32:11.000Z
- [python3とpygameでソートアルゴリズムを可視化してみる](#python3とpygameでソートアルゴリズムを可視化してみる)
- [準備](#準備)
- [スクリプトの記述](#スクリプトの記述)
- [結果](#結果)
- [所感](#所感)
### 準備
ひな形として、
[pygameで画像表示の記事](https://www.geekjp.com/2019-10-06-143046/)
この辺を参考にプロジェクトを作り、スクリプトを書いていきます。
### スクリプトの記述
初心者が書いたスクリプトなので、冗長で稚拙かもしれないですが、一応動きましたので、載せておきます。
### 結果
### 所感
んー。while True内でイベントを処理しているので、イベントリブンのコールバック的な書き方ができない。
やり方あるのかもしれないですが、ユーザー定義イベントと、必要なもの(交換の作業ログ)を保存して、アニメーションとして再生する方法をとりました。(インチキ臭い)
よくわからんで書いているので、アドバイスいただければ幸いです。
へだば、まだ!
### python3とpycharmとpygameで画像表示してみた 第3回
URL: https://www.geekjp.com/2019-10-08-013716/
Last updated: 2026-07-31T16:26:07.000Z
## 画像を拡大縮小してみる
# python3とpycharmとpygameで画像表示してみた 第3回
## 画像を拡大縮小してみる
- [画像を拡大縮小してみる](#%E7%94%BB%E5%83%8F%E3%82%92%E6%8B%A1%E5%A4%A7%E7%B8%AE%E5%B0%8F%E3%81%97%E3%81%A6%E3%81%BF%E3%82%8B)
- [使うもの](#%E4%BD%BF%E3%81%86%E3%82%82%E3%81%AE)
- [使うモジュール](#%E4%BD%BF%E3%81%86%E3%83%A2%E3%82%B8%E3%83%A5%E3%83%BC%E3%83%AB)
- [スクリプトを変更](#%E3%82%B9%E3%82%AF%E3%83%AA%E3%83%97%E3%83%88%E3%82%92%E5%A4%89%E6%9B%B4)
- [実行例(ratio=0.2)](#%E5%AE%9F%E8%A1%8C%E4%BE%8Bratio02)
- [実行例(ratio=2.0)](#%E5%AE%9F%E8%A1%8C%E4%BE%8Bratio20)
- [所感](#%E6%89%80%E6%84%9F)
### 使うもの
- 前回のプロジェクト
- 前回のスクリプト
- 前回の画像
前回までで、画像を表示できたのですが、画像を張り付けるときに拡大縮小をしてみます。
画像自体のサイズを変えてもいいのですが、今回は読み込んだ画像をプログラムの中で拡大縮小してみました。
### 使うモジュール
| **pygame.transformモジュール** |
| ------------------------- |
を使います。
**pygame.taransform**モジュールには、いくつか拡大縮小ができるメソッドがあります。
| モジュール | 機能 | 備考 |
| -------------------------------- | ----------------- | --------------------------------------------------------------- |
| **pygame.taransform.scale** | 指定Surfaceの拡大縮小を行う | 速さ重視で拡大縮小 |
| **pygame.transform.smoothscale** | 指定Surfaceの拡大縮小を行う | 見た目重視で拡大縮小[\*1](#f-6a4e442a "拡大縮小に適用されるフィルタも指定できますが、ここでは割愛します") |
それぞれ引数は、(surface, (width, height)) で、変換後のsurfaceを返すメソッドになっています。
### スクリプトを変更
今回は、pygame.transform.smoothscaleメソッドを使って拡大縮小してみます。
こっちのメソッドにした意味は。。。特にないです。なんとなく。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/8abe3dd3c81a977dd5466c5ac278644f?ref=geekjp.com)
mainの中をこう変更します。
やっていることは、
1. imagerectに元画像の幅と高さを記録
2. ratioに拡大縮小率を決定
3. ratioとimagerect.widthを使って変換後の画像幅を計算
4. ratioとimagerect.heightを使って変換後の画像高を計算
5. 元画像(image)を(imagerect.width, imagerect.height)の大きさに変換
となっています。
### 実行例(ratio=0.2)
図:ratio=0.2の時の実行例
ちゃんと縮んでますね!
### 実行例(ratio=2.0)

図:ratio=2.0の時の実行例
こちらもちゃんと拡大されています!
## 所感
拡大縮小も簡単にできました。
実は、紹介したメソッドのほかにも、拡大縮小できるメソッドが幾つかあります。
| メソッド | 戻り値 | 機能 |
| ------------------------------------------------ | ------- | ------------ |
| pygame.transform.rotozoom(Surface, angle, scale) | surface | 拡大縮小回転を同時に行う |
| pygame.transform.scale2x(Surface) | surface | 画像を2倍に拡大 |
pygame.transform.smoothscaleのところを変更するだけなので試してみると面白いと思います。
図:pygame.transform.rotozoom(image, -45.0, 0.5)の例
こんけできれば、いろんたごだやれそんたなっす
へだば、まだ。[\*3](#f-ceebb0b7)
| |
| ---------------------------------- |
| 12歳からはじめる ゼロからの Pythonゲームプログラミング教室 |
[\*1](#fn-6a4e442a):拡大縮小に適用されるフィルタも指定できますが、ここでは割愛します
[\*2](#fn-9b71d486):このぐらいできれば、いろんなことができそうですね
[\*3](#fn-ceebb0b7):それじゃ、また!
### 工学じじいの縁側日記
URL: https://www.geekjp.com/2019-10-07-212230/
Last updated: 2019-10-07T12:22:30.000Z
## 本ブログについて
じじい(私)が、興味あることや、日々のことを綴っていくごくありふれたblogかもしれません。
主に以下のような内容でやってます。
- 技術系
- 情報処理技術者試験対策
- コンピュータ関連知識
- python初心者講座(自分が)
- ゲーム制作入門(自分が)
- 趣味
- 岩手紹介(主に自分の周り)
- 珈琲
- 自家焙煎店紹介
- 器具紹介
- 自己満レビュー
- ただの日記(自己満100%)
- じじいの謎解き
じじいの謎解きは、結構おすすめですので、ぜひ挑戦してみてください!
たまに、南部弁[\*1](#f-19de51a4)が出ます。
要望があれば、紹介していこうかと思います。
何しろ初心者ですので、コメントなど気軽にしていただければ、こちらも参考になるので助かります。
それではよろしくお願いします。
[\*1](#fn-19de51a4):旧南部藩の方言のさらに岩手県北地方の方言
### pycharm(IDE)+python3(言語)+pygame(ライブラリ)で画像表示 第2回
URL: https://www.geekjp.com/2019-10-07-195352/
Last updated: 2026-08-01T12:33:49.000Z
##
## pycharm(IDE)+python3(言語)+pygame(ライブラリ)で画像表示 第2回
- [pycharm(IDE)+python3(言語)+pygame(ライブラリ)で画像表示 第2回](#pycharmIDEpython3%E8%A8%80%E8%AA%9Epygame%E3%83%A9%E3%82%A4%E3%83%96%E3%83%A9%E3%83%AA%E3%81%A7%E7%94%BB%E5%83%8F%E8%A1%A8%E7%A4%BA%E7%AC%AC%EF%BC%92%E5%9B%9E)
- [プロジェクトを作成](#%E3%83%97%E3%83%AD%E3%82%B8%E3%82%A7%E3%82%AF%E3%83%88%E3%82%92%E4%BD%9C%E6%88%90)
- [画像表示の練習用のプロジェクトを作成](#%E7%94%BB%E5%83%8F%E8%A1%A8%E7%A4%BA%E3%81%AE%E7%B7%B4%E7%BF%92%E7%94%A8%E3%81%AE%E3%83%97%E3%83%AD%E3%82%B8%E3%82%A7%E3%82%AF%E3%83%88%E3%82%92%E4%BD%9C%E6%88%90)
- [画像を用意](#%E7%94%BB%E5%83%8F%E3%82%92%E7%94%A8%E6%84%8F)
- [画像の読み込み表示するスクリプトの記述](#%E7%94%BB%E5%83%8F%E3%81%AE%E8%AA%AD%E3%81%BF%E8%BE%BC%E3%81%BF%E8%A1%A8%E7%A4%BA%E3%81%99%E3%82%8B%E3%82%B9%E3%82%AF%E3%83%AA%E3%83%97%E3%83%88%E3%81%AE%E8%A8%98%E8%BF%B0)
- [いよいよ実行](#%E3%81%84%E3%82%88%E3%81%84%E3%82%88%E5%AE%9F%E8%A1%8C)
- [所感](#%E6%89%80%E6%84%9F)
### プロジェクトを作成
#### 画像表示の練習用のプロジェクトを作成
とは言いながら、ぶっちゃけ前回の使いまわし or 前回のプロジェクトにスクリプト[\*1](#f-3513e849)を追加でいい思います。
少なくとも、スクリプトは前回のものに追加していきます。
(ここでは、プロジェクト名:mygame02、スクリプト名:mygame02.pyとしました[\*2](#f-23bb677b))
#### 画像を用意
自分で用意、またはWebから、利用可能な画像を用意します。
pygameの公式ガイドによると、利用可能な画像形式は(日本語訳はちょい適当です)。。。
> pygame.image.loadコマンドで読み込み可能な画像形式は、基本的に非圧縮BMP形式のみ。
> ほかの画像形式をサポートしているバージョン(なんだそれ?)のみ、以下の形式が読み込み可能JPGPNGGIF (アニメーションはダメ)BMPPCXTGA (非圧縮形式のみ)TIFLBM (PBM)PBM(PPM, PGM)XPM
>
> 画像の保存は、以下の形式のみに対応しています。BMPTGAPNGJPEG
んーと、先日インストールしたばかりなので、きっとBMP以外の画像形式でも読めるでしょうという見切り発車の元、PNG形式の画像を用意してみました。
\*今回使った画像情報\*
| 画像名 | char1.png |
| ---- | --------- |
| 画像形式 | PNG |
| サイズ | 369x480 |
これをスクリプトがあるフォルダに移動します。
図:画像の配置
これでやっとこ準備完了かなぁ。
### 画像の読み込み表示するスクリプトの記述
やっとこスクリプトを記述していきます。
[Gistのソースコードを直接開く](https://gist.github.com/gomta777/165a6c4b496a36aeaad6cf12b209e037?ref=geekjp.com)
前回からの変更点はコメントで書いておきました。
### いよいよ実行
メニュー → RUN → RUN で実行します。
図:実行画面
こんな感じになりました。PNGの透過部分もちゃんと透過されて描画してくれてますね。
スプライトの処理を自分で書かなくてもよさそう。
### 所感
前回のところまで、できていれば割と簡単に画像の表示はできるみたいな気がした。
折角なんで、今回使ったクラス?モジュール?のちょっとした開設を付け加えておこうかと思います。
| モジュール名 | 機能 | 備考 |
| ------------------------ | ------------------------- | --------------------------------------------------------- |
| pygame.image.load | 指定したファイル名の画像を読み込む | 読み込んだ画像から新しいSurfaceを生成 |
| pygame.image.save | 指定したSurfaceを画像として保存します | 指定なしはTGA形式の画像に保存[\*3](#f-1569a608 "読み込みはBMP規定なのになんでじゃい!") |
| pygame.image.get\_extend | 規定以外のファイルが使えるか確認 | 結果はbooleanで返ってくる |
| pygame.image.tostring | 画像を文字形式に変換する | 今は省略 |
| pygame.image.fromstring | 画像を表す文字形式のデータからSurfaceを生成 | 今は省略 |
| pygame.image.frombuffer | 文字列形式の画像情報から直接Surfaceを生成 | 今は省略 |
読み込まれた画像はSurfaceに変換されます。Surfaceはpygameで画像の情報をメモリ内で保存する形式だと思えばいいのかと。
様々なフォーマットを読み込んでも、pygame内ではSurfaceって共通形式で扱える!かな。
詳しいことは後でやる気あったら書こうかのぉ。
また、画面に画像を張り付けるコマンド
| screen.blit(image, (0, 0)) |
| -------------------------- |
imageは画像から生成したSurfaceです。後ろの引数は、表示位置[\*4](#f-f2d79ed3)で、画像の原点をスクリーンのどこへ張り付けるか、っていう指定。
つぎは、画像を動かしてみようかな。
へば、また!
[\*1](#fn-3513e849):なんか、いろいろWeb回った結果スクリプトって呼んでる人が多いからこっちで呼ぼうかの
[\*2](#fn-23bb677b):前回と微妙に整合性合わなぐなったじゃ
[\*3](#fn-1569a608):読み込みはBMP規定なのになんでじゃい!
[\*4](#fn-f2d79ed3):画像も、スクリーンも原点は左上
### python3とpycharmとpygameで画像表示してみた 第1回
URL: https://www.geekjp.com/2019-10-06-143046/
Last updated: 2026-08-01T16:33:10.000Z
## pycharm(IDE)+python3(言語)+pygame(ライブラリ)で画像表示
- [pycharm(IDE)+python3(言語)+pygame(ライブラリ)で画像表示](#pycharmIDEpython3言語pygameライブラリで画像表示)
- [環境を整える](#環境を整える)
- [pycharmとpython3](#pycharmとpython3)
- [pygameのインストール](#pygameのインストール)
- [プロジェクトの作成 in Pycharm](#プロジェクトの作成-in-Pycharm)
- [ソースコードの追加 in Pycharm](#ソースコードの追加-in-Pycharm)
- [サンプルプログラムを動かしてみる](#サンプルプログラムを動かしてみる)
- [ソースコードの入力](#ソースコードの入力)
- [いよいよ実行](#いよいよ実行)
- [所感](#所感)
### 環境を整える
#### pycharmとpython3
pycharmは普通にダウンロードしてインストールしたものを使います。特に何も設定していません。
[https://www.jetbrains.com/pycharm/](https://www.jetbrains.com/pycharm/?ref=geekjp.com)
python3はAnacondaのものを使いました。こちらも特に何も設定していません。
(じじいなのでAnacondaのupdateでちょい嵌りました。原因は、普通のwindows power shellで実行してたこと(;'∀')、スタートメニューからAnaconda PowerShell Promptから実行するとすんなりいきました)
[https://www.python.jp/install/anaconda/index.html](https://www.python.jp/install/anaconda/index.html?ref=geekjp.com)
#### pygameのインストール
これも、じじいなのでちょい嵌りました。じじいの環境では、pycharmdでプロジェクトを作成し、そのプロジェクトにProject Interpreterから、ライブラリを追加する方法ではうまくいきませんでした。(じじいの環境では。。。)
そこで、Anaconda PowerShell Promptからインストールする方法(きっとが[\*1](#f-2b396527)でこいづが普通なんだべな?)で試してうまくいきました。
```bash
python -m pip install pygame
```
#### プロジェクトの作成 in Pycharm
上部のメニューから **FILE→ New Project** でプロジェクトを作成します。(ここでもちょい嵌りやんした)
①プロジェクト名を決めます。(ここは通常通りで問題ないよね)
②virtual envの設定(Project Interpreter: New Virtualenv environment)の"Inherit global site-packages"にチェック(これやらないと、仮想環境にさっきインストールしたpygameが反映されない?)
③右下Createボタンをクリック
図:pygameプロジェクトの作成
これで、問題なくプロジェクトができるはず!
#### ソースコードの追加 in Pycharm
ここまで来たら、あとは通常のプロジェクトみたいにSourceファイルを追加します。
Pycharm左側のProjectの画面の自分のプロジェクト名が表示されている部分を右クリック → New → Python File を選択します。
図:ソースファイルの追加
次に、ファイル名を入力します(プロジェクト名もソースファイル名も任意です)
図:ファイル名の入力
ここまでくれば後は、やっとこソースコードの入力にたどり着けます。
### サンプルプログラムを動かしてみる
#### ソースコードの入力
画面右側のソースコード入力画面に、一番シンプルそうなサンプルを入力してみます。
```python
import pygame
from pygame.locals import *
import sys
def main():
pygame.init() # ライブラリの初期化
screen = pygame.display.set_mode((600, 400)) # 画面サイズを指定
pygame.display.set_caption("Game Test") # ウィンドウタイトルを設定
while True:
screen.fill((203, 255, 135)) # 画面を指定色(R,G,B)で塗りつぶし
pygame.display.update() # 画面の更新
for event in pygame.event.get(): # 終了イベントの処理
if event.type == QUIT:
pygame.quit()
sys.exit()
if __name__ == "__main__": # このスクリプトがトップで実行されたときのみmainを呼ぶ
main()
```
んー。結構長い。。。
#### いよいよ実行
まず、作成したソースコードを確実に保存してください。エラーがあれば、エディット画面に電球マークが出ていると思うので、適切に修正してください。
作成したソースコード(Pythonの場合はやっぱスクリプトっていうんだべか?)を実行してみます。
メニューからRUN → RUN を選び押します。
図:実行画面
さっき指定した色とタイトルのウィンドウが出現すれば大成功!
### 所感
Pycharmを使ってPython3でpygameの一番簡単なサンプルを書いて実際に動かしてみました。
画像を表示するところまではたどり着かなかったので、次は画像の読み込みと表示をやってみます。
また、Pygameはゲームライブラリということなので、図形などの描画、当たり判定、アニメーションなどが簡易的に記述できるはずです。
次回以降その辺をちょっとずつ試していこうと思います。
へば、また。
[\*1](#fn-2b396527):きっとがで→南部弁(岩手県北部)で、たぶん、おそらく、を表す言葉
### iPadでなんか書こうとしたら、Dynalistってアウトライナーすすめられたので、マニュアル訳してみた
URL: https://www.geekjp.com/2019-09-26-030323/
Last updated: 2019-09-25T18:03:23.000Z
わしも、なんか書き物しようかなと思ったら、誰かが
Dynalist良いよって誰かが言ってたから、iPadに入れてみた。
けど、なんか分かんなかったんで、マニュアル訳してみました。
次は、マニュアルの操作をiPadで試してみますか。。。
- Dynalist事始め
- みなのもの、Dynalistを使ってくれてありがとう!👋
- この文書はDynalistを始めるにあたっての必要事項が書いてある。
また、リファレンス(参考書)として保存しておいてもいいし、これ
自体にDynalistのHOWTOを追加することもできる!
- 必要事項リスト
書いてることがわかり切っちゃったら、チェックオフしてね
- Dynalistは入れ子構造のリストで出来ています。
- Tabキーを押すとリストが1レベル深くなります。
- また、Shift+Tabキーで1レベル戻ります(レベルが浅くなる)
- マウスをリストの上に重ねると、ハンバーガーメニューアイコンと虫眼鏡
マークが現れます。
- 虫眼鏡クリックでそのアイテム(要素)が“ズームイン“します。
- メニューをクリックすると他のオプションメニューが現れます
(このメニューをアイテムメニューと呼びます)
- リストをチェックリストに変更するには、アイテムメニューの
”Add checkbox to children“を選択するか、\`Ctrl+Shift+C\`の
キーを押します。
- 箇条書きをドラッグすることで自由にリストを並べ替えられます
(複数アイテムでも可能です)
- 同じように、複数アイテムを選択できます!単に、マウスでドラッグして選ぶ
だけです。
- 新しいドキュメントを作成するときは、左側のサイドバーの”+“アイコンを
クリックするだけです。
- ドキュメントを右クリックするとそのドキュメントに可能な操作のリストが
表示されます。
- \`Shift+Enter\`を押すことでアイテムに注意書きを付けられます。
同じショートカットで、元のアイテムに戻る事ができる。
- \`!\`を押すことで、日付ピッカーをオープンし、日付を入力できます。
必ずスペースの後にタイプしてください。
- (オプション)もし、過去にWorkFlowyを使ったことがあれば、右上の
メニューからオプションを選ぶとWorkFlowyからのインポートができます。
- さらに効果的なリスト
分かっちゃったらチェックオフしてね
- #tags を使うことでグループ化ができます。
- \`Ctrl/Cmd+O\`を使うと、ドキュメント間を素早く切り替えできます。
- スターをクリックするとその場所をブックマークできます。ブックマーク
ペインでその場所に素早く戻れます。
\`Ctrl/Cmd+Shift+B\`のショートカットでブックマークにアクセスできます。
- 他のアイテムへのリンクを挿入するときは、\`\[\[\`をタイプすることでリンク先
のアイテムの検索が始まります。
- \`Ctrl/Cmd+?\`を使うとほとんど全てのショートカットの載ったチートシート
を表示できます。
- ヘルプが必要なとき
- ヘルプセンターで答えを探す。
- メインメニュー(右上のやつ)のヘルプを選ぶ。連絡をもらえればリプライ
します。